
오픈클로(OpenClaw) 모델 카탈로그 전면 개편 — 이제 업데이트 없이 새 모델을 당일 쓴다 (11/6)
 OpenClaw 공식 블로그 ‘Use new models in OpenClaw without an update’ 대표 이미지. (출처: openclaw.ai/blog)
📌 한줄 요약: 2026년 11월 6일, OpenClaw가 모델 탐색(model discovery) 구조를 통째로 갈아엎었습니다. 이제 모델 목록은 ① 호스팅 카탈로그(4시간마다 재빌드), ② 프로바이더 계정이 알려주는 목록, ③ PATH에 설치된 Codex와의 실제 핸드셰이크 — 세 갈래에서 들어옵니다. 핵심은 새 모델이 나와도 OpenClaw 릴리스를 기다리지 않는다는 것. 기본 모델 전환은 68~142초에서 0.6~1.4초로 줄었고, 카탈로그 교체 중에도 목록이 599개에서 54개로 뚝 떨어지던 현상은 사라졌습니다.
이런 분들이라면 체감이 큰 변경입니다
AI 에이전트를 실사용하면서 모델을 자주 바꿔 끼우는 쪽이라면, 최근 몇 달간 이런 답답함을 한 번쯤 겪었을 겁니다.
- 새 모델이 발표됐는데 내 OpenClaw 모델 선택창에는 안 보인다
- 보이는 모델을 고르면 첫 응답에서
Unknown model또는unsupported_api_for_model이 뜬다 - 모델을 하나 바꿀 때마다 선택창이 몇 초씩 멈춘다
- 목록을 새로고침했더니 오히려 모델이 줄어든다
자동화 파이프라인을 운영하는 입장에서는 이게 단순 불편이 아닙니다. 모델 교체가 곧 비용·품질·속도 튜닝인데, 그 튜닝 창구가 릴리스 주기에 묶여 있으면 실험이 밀립니다. 11월 6일 공식 블로그에 올라온 개편 글은 정확히 이 지점을 다룹니다.
왜 갑자기 이걸 뜯어고쳤나
공식 글은 솔직한 고백으로 시작합니다. OpenAI가 GPT-6.1 Sol을 출시했을 때, ChatGPT 로그인으로 OpenClaw를 쓰는 사용자들은 그 모델을 선택할 수 없었습니다. OpenClaw에는 Codex 0.158.0이 번들되어 있었는데, ChatGPT는 Codex 0.159.2 이상에게만 Sol을 노출했습니다. 그 숫자를 바꾸는 유일한 방법이 “OpenClaw 릴리스”였던 겁니다.
“Launch day is when people most want to try a model, and we were the reason they had to wait.” (출시일은 사람들이 가장 그 모델을 써보고 싶어 하는 날인데, 기다리게 만든 쪽이 우리였다.)
그래서 약 5주, 대략 80개의 PR로 모델 목록을 가져오는 방식을 다시 지었습니다. 이번 글은 그 결과물에 대한 기술 회고이자, 운영자 입장에서 읽어야 할 변경 공지입니다.
바뀐 구조 ①: 4시간마다 스스로 갱신되는 카탈로그
예전에는 프로바이더 플러그인마다 모델 목록이 매니페스트 파일로 들어 있었고, 그 파일은 OpenClaw 패키지에 함께 배포됐습니다. 플러그인은 릴리스에 묶여 있으니, 모델 추가는 곧 릴리스였습니다.
이제 OpenClaw는 catalog.openclaw.ai에 호스팅된 모델 카탈로그를 봅니다.
| 항목 | 내용 |
|---|---|
| 재빌드 주기 | 4시간마다 |
| 데이터 소스 | models.dev + OpenClaw 자체 매니페스트 + 가격 피드 + 프로바이더 모델 목록 |
| 수록 규모 | 현재 약 1,000개 모델 |
| 반영 방식 | 실행 중인 게이트웨이가 백그라운드에서 새 카탈로그를 확인하고 라이브로 교체 |
여기서 실무적으로 중요한 디테일이 두 가지 있습니다.
첫째, 진행 중인 턴은 시작할 때의 카탈로그로 끝납니다. 새 턴부터 새 카탈로그를 씁니다. 그래서 한 응답 안에서 모델 목록과 가격이 서로 어긋나는 일이 생기지 않습니다. 비용 집계를 하는 자동화라면 이건 꽤 중요한 보장입니다.
둘째, 폐기된 모델은 카탈로그에서 제거됩니다. 글에서는 NVIDIA가 API에서 2개 모델 서비스를 중단했는데 카탈로그에 계속 남아 있던 사례를 듭니다. 편리함의 이면이기도 합니다. 오래 돌던 자동화가 어느 날 조용히 없는 모델을 가리키게 될 수 있으니, 폴백 모델은 반드시 지정해 두는 편이 안전합니다.
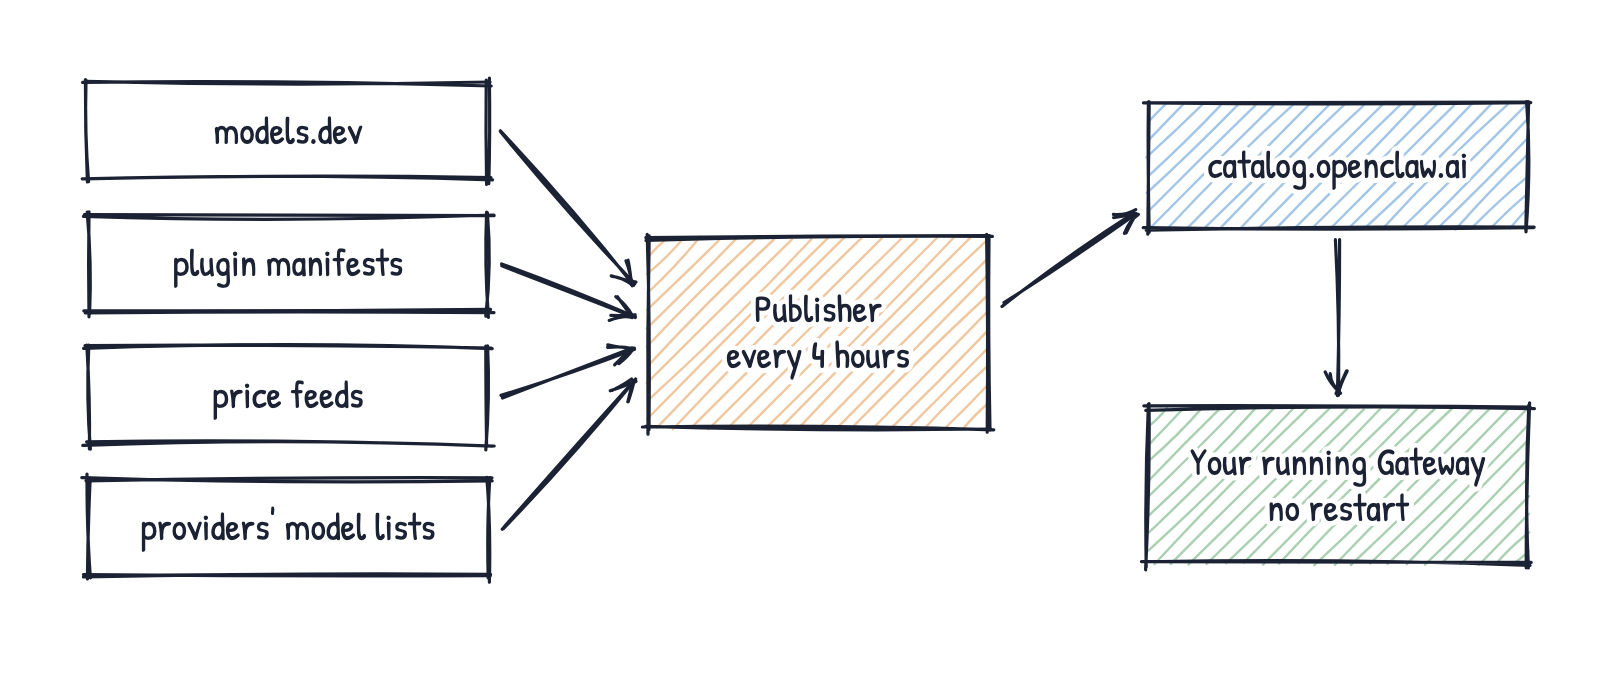 models.dev, 플러그인 매니페스트, 가격 피드, 프로바이더 목록이 호스팅 카탈로그를 거쳐 실행 중인 게이트웨이까지 도달하는 구조. (출처: openclaw.ai/blog)
바뀐 구조 ②: “내 계정에 있으면 고를 수 있다”
카탈로그는 세상에 존재하는 모델을 압니다. 계정은 내가 쓸 수 있는 모델을 압니다. 이 둘은 다릅니다. 그래서 OpenClaw는 프로바이더 로그인 시 해당 계정의 모델 목록을 직접 물어보고, 설치 버전보다 새로운 모델이나 계정 전용 모델까지 선택창에 올립니다.
공식 글이 정리한 전후 비교는 이렇습니다.
| 프로바이더 | 이전 | 이후 |
|---|---|---|
| OpenAI API 키 | 계정에 있는 gpt-5.2가 Unknown model |
계정 목록의 채팅 모델이 표시되고 실행됨 |
| Anthropic API 키 | 새 Claude 모델은 릴리스 전까지 숨김 | Anthropic 목록에 뜨는 즉시 표시 |
| Claude Code | OpenClaw가 관리하던 고정 목록 | 계정에 대해 Claude Code가 보고하는 메뉴 |
| GitHub Copilot | kimi-k3가 첫 턴에서 unsupported_api_for_model |
모델별로 허용되는 엔드포인트를 읽어 맞춰 호출 |
| Grok 구독 | grok-4.7-build-fast의 사고 수준이 off/ultra 2단계 |
목록대로 low/medium/high/xhigh 4단계 |
| Ollama | ollama pull 해도 목록에 안 뜸 |
다음 새로고침에 표시 |
| OpenCode Go | 계정이 서빙하는 4개 모델 누락 | 목록의 모든 모델 표시 |
여기서 절반은 “모델 이름”이 아니라 “모델이 무엇을 할 수 있는지”를 읽는 작업이었습니다. 예전에는 사고 수준(thinking level)과 요청 형식을 모델 이름으로 추측했습니다. 한 번도 본 적 없는 새 모델에서는 이 추측이 곧바로 실패합니다. 이제는 프로바이더가 목록에 실어 보내는 정보를 그대로 씁니다.
바뀐 구조 ③: Codex 버전 문제, 그리고 되돌린 첫 시도
이 대목이 이번 글에서 가장 값진 부분입니다. 실패를 숨기지 않았습니다.
ChatGPT는 클라이언트가 보고하는 Codex 버전을 보고 어떤 모델을 제공할지 정합니다. 버전이 낮으면 목록이 짧아집니다. 첫 시도는 단순했습니다. npm에서 최신 Codex 버전을 받아 그 숫자를 보고하면 되지 않는다는 발상이었고, 실제로 Sol이 선택창에 나타났습니다.
문제는 그다음이었습니다. 목록 요청은 0.161.0이라고 말하는데, 턴은 여전히 번들된 0.160.0에서 돌았습니다. 그 바이너리는 요청마다 자기 버전을 보고합니다. 결과는 선택창에서 고른 모델이 첫 메시지에서 HTTP 400으로 실패하는 것이었습니다.
“We had moved the failure from the picker to the first message, which is worse.” (실패를 선택창에서 첫 메시지로 옮겼을 뿐이고, 그게 더 나쁘다.)
그래서 되돌렸고, 지금은 이렇게 동작합니다.
PATH에서 Codex를 찾습니다.- 안정(stable) 릴리스이고, 번들 버전보다 새롭고, 같은 메이저 버전이면 실제 핸드셰이크를 합니다.
- 핸드셰이크가 통과하면 목록을 가져오는 바이너리와 턴을 실행하는 바이너리가 동일해집니다.
- 하나라도 실패하면 조용히 번들 Codex로 폴백합니다.
- OpenClaw가 임의로 무엇인가를 설치하지는 않습니다.
테스트 로그는 이런 모양입니다.
[agent/embedded] Codex app-server: using installed ~/.local/bin/codex 0.162.1 (newer than bundled 0.161.0)
요지는 “모델을 나열하는 버전과 실행하는 버전이 같아야 한다”는 원칙입니다. 자동화를 운영하며 새 모델을 급히 붙이다 보면 놓치기 쉬운, 그러나 한 번 물리면 원인 찾기 어려운 종류의 버그입니다.
숫자로 보는 체감 차이
공식 글이 제시한 전후 수치입니다. 이쪽이 아마 가장 와닿을 겁니다.
| 상황 | 이전 | 이후 |
|---|---|---|
| OpenRouter가 한 번 타임아웃 | 466개 → 3개, 수동 새로고침 전까지 유지 | 30초 후 재시도, 최대 30분까지 백오프 |
| 게이트웨이가 카탈로그 교체 | 599개 → 54개, 최대 4분간 | 교체 중에도 599개 유지 |
| 기본 모델 변경 | 68~142초 (대형 플러그인 재로드로 게이트웨이 정지) | 0.6~1.4초 (이미 로드된 플러그인 재사용) |
| 모델 선택창 열기 | 최대 5초 대기 | 즉시 열리고 나머지는 백그라운드로 채움 |
솔직히 “기본 모델 변경에 1~2분”은 자주 겪는 사람에게는 꽤 큰 마찰입니다. 모델을 A/B로 바꿔가며 프롬프트를 튜닝하는 작업이라면, 그 1분이 실험 횟수를 직접 깎아먹으니까요. 0.6~1.4초는 체감상 “즉시”에 가깝습니다.
1,000개 모델은 오히려 독이다
목록이 다 보이면 길어집니다. OpenRouter 하나만 466개입니다. 그래서 카탈로그는 프로바이더별 추천 목록을 함께 싣고, 선택창은 추천을 먼저 보여줍니다. 추천 목록은 매일 수동으로 큐레이션되며, 자체 경험과 여러 벤치마크를 섞어 만든다고 합니다. 검색은 여전히 전체 모델을 대상으로 합니다.
OpenAI 그룹을 예로 들면, 현재 사용 중인 모델이 맨 앞, 그다음 추천 2개, 나머지 33개는 한 줄 뒤에 접혀 있습니다.
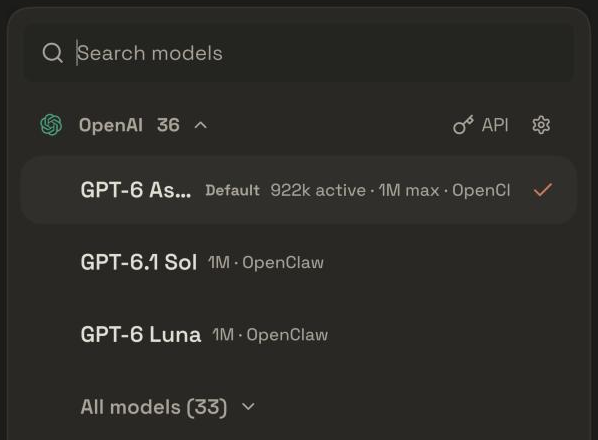 실행 중인 게이트웨이에서 캡처한 OpenClaw 채팅 모델 선택창. (출처: openclaw.ai/blog)
편해진 대신 판단이 하나 늘었습니다. “추천”은 OpenClaw 팀의 취향과 벤치마크가 반영된 값입니다. 내 자동화의 작업 특성(예: 긴 문서 요약, 코드 패치, 다국어 분류)과 반드시 일치하지는 않습니다. 추천은 출발점으로만 쓰고, 실제 품질은 자체 평가셋으로 확인하는 편이 낫습니다.
공식 글이 뽑은 4가지 교훈
- 모델을 나열하는 버전이 그 모델을 실행해야 한다. 보고하는 버전과 실행 버전이 다르면 실패는 선택창에서 첫 메시지로 옮겨갈 뿐이다.
- 능력은 이름이 아니라 목록에서 읽어라. 사고 수준과 엔드포인트는 프로바이더 목록에 이미 적혀 있다. 이름 기반 규칙은 처음 보는 모델에서 깨진다.
- 마지막 정상 목록을 지켜라. 새로고침 실패나 카탈로그 교체가 선택창의 모델 수를 줄여서는 안 된다.
- 한 소스가 깨져도 나머지는 살아 있어야 한다. 9월 21일 models.dev가
kimi-for-coding항목을 둘로 쪼갰을 때, 퍼블리셔가 “프로바이더 하나 누락”을 치명적 오류로 처리해 모든 실행이 실패했고 그 기간 GPT-6 Sol과 Luna가 기존 설치에 도달하지 못했습니다. 지금은 경고만 남기고 해당 프로바이더만 신선한 데이터를 못 받습니다.
3번과 4번은 OpenClaw만의 이야기가 아닙니다. 외부 API 목록을 받아 UI에 뿌리는 자동화를 만든다면 그대로 적용되는 원칙입니다.
아직 릴리스가 필요한 경우 (한계)
과장 없이 정리하면 이렇습니다.
- PATH에 더 새로운 Codex가 없으면, 여전히 번들 버전이 ChatGPT 모델 목록을 결정합니다.
- 카탈로그보다 새로운 모델은 가격이 없습니다. 비용이
unknown으로 표시되고, 카탈로그가 따라잡을 때까지 보수적인 기본 한도로 실행됩니다. - 현재 설치가 어디까지 닿는지 확인하려면
openclaw models list --refresh를 실행하면 됩니다. - Codex 핸드셰이크가 실패하면 조용히 번들로 폴백합니다. 즉 “왜 최신 모델이 안 보이지?”의 답이 로그에만 있을 수 있습니다.
세 번째 항목은 배치 작업에서 특히 주의할 지점입니다. 토큰을 많이 쓰는 잡을 새 모델로 돌렸는데 가격이 아직 등록되지 않아 보수적 한도에 걸리면, 실패가 아니라 성능 저하로 나타납니다. 원인을 모델 탓으로 오해하기 쉬운 형태입니다.
도입 전 체크리스트
자동화 파이프라인을 운영 중이라면, 이번 변경은 아래 순서로 확인하는 걸 권합니다.
openclaw models list --refresh— 현재 설치가 실제로 볼 수 있는 모델 범위 확인- 게이트웨이 로그에서 카탈로그 교체 기록 확인 (재시작 없이 반영되는지)
which codex,codex --version— PATH에 예상치 못한 버전이 물려 있지 않은지- 각 자동화 잡에 폴백 모델 명시 (폐기 모델 자동 제거 대비)
- 가격 미등록 모델은 예산 한도를 별도로 두기
- 팀 게이트웨이라면, 모델 변경이 감사 로그에 모델·가격 단위로 남는지 확인
3번은 은근히 중요합니다. 개발용·실험용 Codex를 여러 버전 설치해 둔 환경이라면, 핸드셰이크가 통과한 “그 버전”이 실제 턴을 실행합니다. 의도한 버전인지 눈으로 확인하는 편이 좋습니다.
정리 — 이번 변경의 성격
이번 개편은 새 기능이 붙은 릴리스가 아니라, 모델을 가져오는 경로 자체를 바꾼 인프라 변경입니다. 눈에 보이는 것은 선택창의 목록 몇 개지만, 실제 효과는 세 가지로 요약됩니다.
- 시간: 모델 출시일과 사용 가능일 사이의 지연이 사라짐 (Codex 예외 있음)
- 안정성: 목록이 줄어들거나 선택창이 멈추는 문제 해결, 전환 0.6~1.4초
- 일관성: 목록을 나열한 버전과 실행 버전을 일치시킴
반대로 비용 예측과 폐기 모델 대응이라는, 원래는 릴리스가 대신 눌러주던 안전장치가 운영자 몫으로 넘어왔습니다. 모델을 자주 갈아 끼우는 자동화라면 이득이 크고, 한 모델로 오래 고정 운영하는 파이프라인이라면 당장 체감은 작을 수 있습니다.
새 모델을 빠르게 붙여 실험하는 쪽, 여러 프로바이더를 섞어 쓰는 쪽이라면 지금 바로 openclaw models list --refresh 한 번 돌려볼 만한 변경입니다. 가성비 좋은 구성(비싼 모델은 최종 검토에만, 나머지는 저렴한 모델로)을 찾고 있다면 더더욱요.
참고
- OpenClaw 공식 블로그 — Use new models in OpenClaw without an update (Ayaan Zaidi, 2026년 11월 6일)
- OpenClaw 공식 문서 — Models / Security / Plugins
- 호스팅 카탈로그:
catalog.openclaw.ai(4시간 주기 재빌드) - 확인 명령:
openclaw models list --refresh