<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="ko"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://jackeychan0511.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://jackeychan0511.github.io/" rel="alternate" type="text/html" hreflang="ko" /><updated>2026-11-08T17:05:04+09:00</updated><id>https://jackeychan0511.github.io/feed.xml</id><title type="html">40대 라이프</title><subtitle>40대의 재테크, 여행, AI이슈, 자녀교육, 이슈제품, 맛집까지. 같은 40대로서 경험하고 분석한 실용적인 정보를 공유합니다.</subtitle><author><name>재찬키</name><email></email></author><entry><title type="html">Anthropic Claude 최신 소식 — ‘퍼스널 파이낸스’ 베타, 은행 계좌 연결해 소비·청구서까지 분석 (2026.11.8)</title><link href="https://jackeychan0511.github.io/2026/11/08/anthropic-claude-personal-finance-20261108/" rel="alternate" type="text/html" title="Anthropic Claude 최신 소식 — ‘퍼스널 파이낸스’ 베타, 은행 계좌 연결해 소비·청구서까지 분석 (2026.11.8)" /><published>2026-11-08T16:52:00+09:00</published><updated>2026-11-08T16:52:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/08/anthropic-claude-personal-finance-20261108</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/08/anthropic-claude-personal-finance-20261108/"><![CDATA[<p><img src="/assets/images/posts/anthropic-claude-personal-finance-20261108/claude-personal-finance-hero.png" alt="Claude 퍼스널 파이낸스 화면" />
<em>Anthropic이 공개한 퍼스널 파이낸스 화면. 연결한 계좌의 소비를 카테고리별로 합산해 한 화면에 보여줍니다 (이미지 출처: Anthropic 공식 발표 자료, claude.com)</em></p>

<blockquote>
  <p><strong>📌 한줄 요약:</strong> Anthropic이 <strong>2026년 11월 5일</strong> Claude에 <strong>퍼스널 파이낸스(Personal Finance)</strong> 를 베타로 추가했습니다. <strong>Plaid</strong>를 통해 은행·카드 계좌를 연결하면 “이번 달에 돈이 어디로 갔나” 같은 질문에 카테고리별 소비 내역, 급여일 전 빠져나갈 결제, 중복 청구·슬금슬금 오른 요금까지 정리해 답합니다. 접근은 <strong>읽기 전용</strong>이고, 허브 안에서의 대화는 <strong>모델 학습에 쓰이지 않으며</strong>, 계좌는 <strong>언제든 연동 해제</strong>할 수 있습니다. 대상은 <strong>미국 Pro·Max·Ultra 구독자</strong>로 한정된 베타입니다.</p>
</blockquote>

<hr />

<h2 id="1-무슨-일이-있었나">1. 무슨 일이 있었나</h2>

<p>Anthropic은 11월 5일(미국 시간) 공식 자료 “Introducing Personal Finance in Claude”를 통해 새 기능을 발표했습니다. 핵심은 Claude가 <strong>대화형 금융 비서</strong>로 확장됐다는 점입니다. 그동안 Claude는 텍스트·코드·문서·에이전트 작업을 다뤘지만, 계좌 잔액과 거래 내역처럼 <strong>실제 돈의 흐름</strong>을 직접 읽는 기능은 없었습니다.</p>

<p>발표문에서 Anthropic이 강조한 문장은 세 가지입니다.</p>

<ul>
  <li><strong>읽기 전용(read-only)</strong> — 돈을 옮기거나 관리하거나 투자하지 않습니다.</li>
  <li><strong>광고 없음</strong> — Claude의 다른 기능과 마찬가지로 광고나 협찬 추천이 붙지 않고, 자사가 파는 신용카드·대출·예금 상품도 없습니다.</li>
  <li><strong>베타 + 미국 한정</strong> — Pro, Max, Ultra 플랜 구독자를 대상으로 이번 주부터 순차 배포됩니다.</li>
</ul>

<p>같은 날 The Verge와 MacRumors가 일제히 보도했고, TestingCatalog는 “Claude adds Personal Finance with read-only bank access”라는 제목으로 기능 스펙을 정리했습니다. 즉, 루머 단계가 아니라 <strong>공식 발표가 끝난 실제 배포</strong>입니다.</p>

<p><img src="/assets/images/posts/anthropic-claude-personal-finance-20261108/claude-personal-finance-payments.png" alt="Claude 퍼스널 파이낸스 결제 예정 화면" />
<em>급여일 전에 빠져나갈 결제와 남는 금액을 정리해 보여주는 화면. 공식 예시에서는 급여일 전 4건의 결제를 빼고 1,393.22달러가 남는다고 계산했습니다 (이미지 출처: Anthropic 공식 발표 자료, claude.com)</em></p>

<hr />

<h2 id="2-상세-분석--실제로-무엇을-할-수-있나">2. 상세 분석 — 실제로 무엇을 할 수 있나</h2>

<p>Anthropic이 공개한 예시 시나리오를 따라가면 기능 범위가 선명해집니다. 월말, 급여일이 아직 10일 남은 상황에서 “이번 달에 내 돈 어디로 갔어?”라고 물으면 Claude는 연결된 계좌의 지출을 모아 카테고리별로 정리합니다. 공식 예시의 합계는 <strong>4,309.37달러</strong>, 그중 절반 이상이 <strong>주거·공과금</strong>, <strong>1,024.51달러가 식비</strong>였습니다.</p>

<p>여기서 끝나지 않고 이어서 묻는 질문에 답합니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">질문 예시</th>
      <th style="text-align: left">Claude가 하는 일</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">“평소보다 많이 쓴 거야?”</td>
      <td style="text-align: left">이전 달들과 비교해 늘어난 항목을 짚음</td>
    </tr>
    <tr>
      <td style="text-align: left">“빠뜨린 것 있어?”</td>
      <td style="text-align: left">멤버십 갱신처럼 놓치기 쉬운 결제를 지적</td>
    </tr>
    <tr>
      <td style="text-align: left">“월급 들어오기 전에 뭐 나가?”</td>
      <td style="text-align: left">체크카드·계좌에서 빠질 결제와 남는 금액을 계산</td>
    </tr>
    <tr>
      <td style="text-align: left">“뭔가 이상한 거 없어?”</td>
      <td style="text-align: left">두 번 결제된 항목, 예상 못 한 수수료, 1년 내내 오른 요금을 찾음</td>
    </tr>
    <tr>
      <td style="text-align: left">“내가 버는 것보다 많이 써?”</td>
      <td style="text-align: left">수입·지출 구조를 비교해 설명</td>
    </tr>
    <tr>
      <td style="text-align: left">“APR이 뭐고, 올해 이자로 얼마 냈어?”</td>
      <td style="text-align: left">금융 용어를 풀어 설명하고 실제 이자 합계를 계산</td>
    </tr>
    <tr>
      <td style="text-align: left">“주간 소비 차트 만들어줘”</td>
      <td style="text-align: left">차트·결제 캘린더·대시보드를 생성(이후 수정 가능)</td>
    </tr>
  </tbody>
</table>

<p>정리하면 <strong>① 소비 가시화 → ② 이상 징후 탐지 → ③ 현금흐름 예측 → ④ 금융 리터러시 보조</strong>의 네 층입니다. 기존 가계부 앱이 “분류”에 강점이 있었다면, 이 기능은 <strong>“왜 이 숫자인지 되물을 수 있다”</strong> 는 점이 다릅니다. 금액의 근거 거래를 다시 물으면 어떤 거래가 합산됐는지 확인할 수 있게 설계돼 있습니다.</p>

<p>한 가지 분명히 해둘 점은, 이건 <strong>자산관리 도구가 아니라 이해 보조 도구</strong>라는 것입니다. Anthropic은 발표문에서 “투자 조언을 제공하도록 설계된 것이 아니다”라고 명시했습니다. 이체, 자동이체 설정, 리밸런싱 같은 실행 기능은 아예 없습니다.</p>

<hr />

<h2 id="3-보안프라이버시-구조--여기가-이-뉴스의-핵심">3. 보안·프라이버시 구조 — 여기가 이 뉴스의 핵심</h2>

<p>계좌를 AI에 연결한다는 발표는 반드시 <strong>“그럼 내 금융 데이터는 어디까지 가나”</strong> 라는 질문과 함께 읽어야 합니다. Anthropic이 공개한 구조는 다음과 같습니다.</p>

<p><strong>① 비밀번호를 넘기지 않는다.</strong> 계좌 연결은 <strong>Plaid</strong>를 통해 이뤄집니다. 사용자가 직접 은행에 로그인해 약관에 동의하고 Claude의 읽기 전용 접근을 승인하는 방식이라, Claude는 은행 비밀번호를 요구하지도 보지도 않습니다. Plaid는 이미 다수 금융 앱이 쓰는 계좌 연결 표준에 가깝고, OpenAI도 ChatGPT 금융 기능에 같은 방식을 썼습니다.</p>

<p><strong>② 보이는 범위가 한정돼 있다.</strong> 연결을 승인한 계좌에 대해서만 은행명, 계좌명·유형, 계좌번호 끝 4자리, 잔액·신용한도, <strong>최대 2년치 거래 내역</strong>까지가 Claude가 보는 범위입니다.</p>

<p><strong>③ 학습에 쓰지 않는다.</strong> 퍼스널 파이낸스 허브에서 나눈 대화는 <strong>모델 학습에 사용되지 않고</strong>, Claude의 공유 메모리에도 들어가지 않습니다. 허브 밖에서 나눈 대화에는 평소의 개인정보 설정이 그대로 적용됩니다.</p>

<p><strong>④ 언제든 끊을 수 있다.</strong> 계좌 연동을 해제하면 Claude는 해당 계좌 데이터를 더 이상 볼 수 없습니다.</p>

<p>여기에 더해 Anthropic 스스로 “Claude는 실수할 수 있으니 숫자 근거가 되는 거래를 확인하고, 중요한 수치는 은행에서 검증하라”고 못 박았습니다. 금융 데이터를 다루는 기능에서 이 정도의 자기 한계 선언을 공식 문서에 넣은 것은 의미가 있습니다.</p>

<p>다만 구조적으로 남는 고민도 있습니다. 첫째, <strong>읽기 전용이라도 2년치 거래 내역은 강력한 프로필</strong>입니다. 소비 습관, 거주 지역, 소득 수준, 가족 구성이 거래 패턴에 그대로 드러납니다. 둘째, 계좌 데이터를 읽는 에이전트는 <strong>프롬프트 인젝션</strong>류 공격에서 표적이 되기 쉽습니다. 거래 내역의 메모란에 악성 지시를 심어 두는 식의 공격이 이론적으로 가능하기 때문에, 금융 데이터를 다루는 에이전트일수록 도구 호출 권한을 최소화하는 설계가 중요해집니다. 읽기 전용·이체 불가라는 제약은 바로 이 지점에서 안전장치로 작동합니다.</p>

<hr />

<h2 id="4-경쟁-구도--왜-하필-지금인가">4. 경쟁 구도 — 왜 하필 지금인가</h2>

<p>이 기능은 Anthropic이 처음이 아닙니다. <strong>OpenAI가 2026년 5월 ChatGPT에 유사한 금융 기능을 붙였고</strong>, 역시 Plaid를 통해 계좌를 연결했습니다. 즉 Anthropic은 소비자용 금융 영역에서 <strong>약 반년 늦게 따라붙은</strong> 셈입니다.</p>

<p>늦었는데도 이 소식이 이슈인 이유는 시점 때문입니다.</p>

<ul>
  <li>Anthropic은 10월 26일 <strong>S-1을 제출</strong>하고 나스닥 상장(티커 ANT)을 준비 중입니다. 상장을 앞둔 회사가 “챗봇 회사”에서 <strong>일상 생활 인프라</strong>로 서사를 넓히는 전략은 투자자 설명에 직접적인 재료가 됩니다.</li>
  <li>최근 행보가 한 방향으로 모입니다. <strong>Claude Cowork</strong>(에이전트형 작업 공간), <strong>Claude Duet</strong>(먼저 말을 거는 능동형 에이전트), <strong>Claude Marketplace</strong>(에이전트·플러그인 거래), 그리고 이번 <strong>퍼스널 파이낸스</strong>까지 — 전부 “Claude가 사용자의 실제 데이터와 업무·생활 맥락 안으로 들어간다”는 같은 축입니다.</li>
  <li>Anthropic은 발표문 마지막에 <strong>“퍼스널 파이낸스는 첫걸음”</strong> 이라며, 큰 돈이 걸린 결정에서는 <strong>면허를 가진 전문가·규제 금융사와 함께 일하는 구조</strong>를 탐색 중이고, 은행·자산관리사·금융사와 논의를 열어두겠다고 밝혔습니다. 다음 단계가 개인 금융을 넘어 <strong>금융사 연동</strong>일 수 있다는 신호입니다.</li>
</ul>

<hr />

<h2 id="5-영향--사용자와-개발자에게-무엇이-달라지나">5. 영향 — 사용자와 개발자에게 무엇이 달라지나</h2>

<p><strong>일반 사용자 입장</strong></p>

<ul>
  <li>여러 은행 앱을 오가며 합계를 손으로 더하던 작업이 <strong>한 번의 질문</strong>으로 줄어듭니다. 특히 “이번 달 카드값이 왜 이렇게 나왔지” 같은 사후 확인에 강합니다.</li>
  <li>구독료·멤버십 갱신, 중복 결제, 조용히 오른 요금처럼 <strong>금액이 작아 눈에 안 띄는 누수</strong>를 잡아주는 용도가 실용적입니다.</li>
  <li>반대로, <strong>금융 데이터를 AI에 연결하는 것 자체에 거부감이 있는 경우</strong>에는 굳이 켤 이유가 없습니다. 베타이고 미국 한정이며, 읽기 전용이라 해도 연결은 선택의 문제입니다.</li>
  <li>한국 사용자에게는 아직 해당 사항이 없습니다. 현재 배포 범위는 <strong>미국 Pro·Max·Ultra</strong>이고, 공식 자료에 한국 출시 일정은 없습니다.</li>
</ul>

<p><strong>개발자·기업 입장</strong></p>

<ul>
  <li>이번 발표의 기술적 함의는 <strong>“금융 데이터를 읽는 에이전트”의 레퍼런스 구현</strong>이라는 점입니다. Plaid 같은 계좌 연결 계층 + 읽기 전용 권한 + 학습 미사용 정책 + 연동 해제권이라는 조합은, 사내 업무 자동화에서 ERP·회계·정산 데이터를 에이전트에 물릴 때 그대로 참고할 수 있는 설계 패턴입니다.</li>
  <li>특히 <strong>권한을 읽기로 제한하고, 실행은 사람이 하게 남겨두는 구조</strong>는 자동화 파이프라인을 운영하는 조직에 시사점이 큽니다. “에이전트가 판단하되 돈은 건드리지 않는다”는 경계 설정이 실제 제품 수준에서 어떻게 문서화되는지 보여줍니다.</li>
  <li>데이터 거버넌스 관점에서는 <strong>“허브 안 대화는 학습에 미사용”</strong> 같은 기능 단위 정책이 표준이 되어가고 있다는 점도 눈여겨볼 부분입니다. 기업 도입 검토 시 벤더에 같은 수준의 답변을 요구할 근거가 생깁니다.</li>
</ul>

<hr />

<h2 id="6-한계와-주의점">6. 한계와 주의점</h2>

<p>솔직히, 지금 단계에서 이 기능을 “가계부 앱 대체”로 보면 실망할 가능성이 큽니다. 이유는 명확합니다.</p>

<ol>
  <li><strong>미국 베타</strong>입니다. 플랜도 Pro·Max·Ultra로 제한되고, 무료 사용자는 대상이 아닙니다.</li>
  <li><strong>실행 기능이 없습니다.</strong> 이체·자동이체·투자·대출 비교 같은 건 할 수 없고, 투자 조언도 하지 않습니다.</li>
  <li><strong>오류 가능성이 공식적으로 인정돼 있습니다.</strong> 합산 기준이나 카테고리 분류가 실제와 다를 수 있어, 세금·대출 심사처럼 정확도가 중요한 판단에 그대로 쓰기는 어렵습니다.</li>
  <li><strong>연결 범위가 사용자 책임</strong>입니다. 어떤 계좌를 붙일지, 언제 끊을지는 전적으로 사용자가 관리해야 합니다.</li>
  <li><strong>금융 데이터는 되돌릴 수 없는 정보</strong>입니다. 한 번 노출되면 비밀번호처럼 교체할 수 없습니다. 그래서 “학습에 안 쓴다”는 정책 못지않게, 연결을 최소화하고 필요 없으면 즉시 해제하는 습관이 중요합니다.</li>
</ol>

<hr />

<h2 id="7-전망">7. 전망</h2>

<p>가장 가능성이 높은 다음 수는 <strong>연동 확대</strong>입니다. Anthropic이 공개적으로 은행·자산관리사·금융사에 협업을 요청한 만큼, ① 금융기관 커넥터·플러그인, ② 세금·보험 같은 인접 영역, ③ 전문가 연결(사람 + Claude 조합) 순서로 확장될 여지가 큽니다. Claude Marketplace가 이미 열려 있다는 점도 이 경로를 뒷받침합니다.</p>

<p>다만 규제 변수가 큽니다. 금융 데이터 접근은 국가별 규제가 촘촘하고, 미국 밖으로 나가는 순간 요구 조건이 달라집니다. 한국을 포함한 아시아 출시는 <strong>금융 규제·제휴 상황에 따라 순서가 결정될 가능성</strong>이 높아, “곧 된다”는 기대보다는 마이너 기능부터 단계적으로 들어올 것으로 보는 편이 현실적입니다.</p>

<p>경쟁사도 가만히 있지 않습니다. ChatGPT가 먼저 깔아둔 사용자 경험이 있고, 구글은 검색·결제·계정 생태계를 앞세울 수 있습니다. 결국 승부는 “계좌를 붙일 수 있나”가 아니라 <strong>“붙인 데이터로 얼마나 믿을 만한 답을 주고, 그 데이터를 얼마나 안전하게 다루는가”</strong> 에서 갈릴 것입니다.</p>

<hr />

<h2 id="정리--이런-경우라면-체크해볼-만합니다">정리 — 이런 경우라면 체크해볼 만합니다</h2>

<ul>
  <li>은행·카드 앱을 여러 개 쓰면서 <strong>월말 합계를 매번 손으로 맞추는 경우</strong></li>
  <li>구독료·멤버십·보험 갱신처럼 <strong>작은 누수를 정리하고 싶은 경우</strong></li>
  <li>금융 용어(APR, 신용한도, 이자 계산)를 <strong>자기 숫자로 설명받고 싶은 경우</strong></li>
  <li>반대로, 금융 데이터를 외부 서비스에 연결하는 것에 거부감이 있거나 <strong>거래 실행 자동화를 원하는 경우</strong>라면 지금 단계에서는 맞지 않습니다. 이번 기능은 어디까지나 <strong>읽고 이해하는 범위</strong>에 머뭅니다.</li>
</ul>

<p>Anthropic의 이번 발표는 “새 기능 하나 추가”로 보기엔 각도가 다릅니다. 상장을 앞둔 시점에 Claude를 <strong>업무 도구에서 생활 인프라로</strong> 옮겨 놓는 첫 공식 선언이고, 동시에 <strong>AI가 금융 데이터를 다룰 때의 권한 경계</strong>를 제품 수준에서 못 박은 사례입니다. 베타가 미국에 한정돼 있어 당장 쓸 수 있는 사람은 많지 않지만, 방향은 꽤 분명합니다.</p>

<p><strong>참고 출처:</strong> Anthropic 공식 발표 “Introducing Personal Finance in Claude” (2026.11.5), The Verge, MacRumors, TestingCatalog, Claude 고객센터(Ultra/Max 플랜 안내)</p>]]></content><author><name>40대 블로거</name></author><category term="career" /><category term="Anthropic" /><category term="Claude" /><category term="앤트로픽" /><category term="클로드" /><category term="PersonalFinance" /><category term="퍼스널파이낸스" /><category term="Plaid" /><category term="금융AI" /><category term="소비분석" /><category term="가계부" /><category term="프라이버시" /><category term="보안" /><category term="ChatGPT" /><category term="업무자동화" /><category term="2026년11월" /><summary type="html"><![CDATA[Anthropic이 2026년 11월 5일 Claude에 '퍼스널 파이낸스'를 베타로 풀었습니다. Plaid로 은행·카드 계좌를 연결하면 소비 카테고리 분석, 다음 급여일 전 빠져나갈 결제, 중복 청구·인상된 요금 찾기까지 자연어로 처리합니다. 읽기 전용 접근, 모델 학습 미사용, 언제든 연동 해제라는 조건과 함께 기능 범위·보안 구조·경쟁 구도·사용자와 개발자에게 미치는 영향을 정리했습니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/anthropic-claude-personal-finance-20261108/claude-personal-finance-hero.png" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/anthropic-claude-personal-finance-20261108/claude-personal-finance-hero.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">Google Gemini 최신 소식 — 학교 크롬북 AI 검색 소송, ‘챗봇은 막았는데 검색에 남은 AI’ (2026.11.08)</title><link href="https://jackeychan0511.github.io/2026/11/08/gemini-school-ai-lawsuit-20261108/" rel="alternate" type="text/html" title="Google Gemini 최신 소식 — 학교 크롬북 AI 검색 소송, ‘챗봇은 막았는데 검색에 남은 AI’ (2026.11.08)" /><published>2026-11-08T15:52:00+09:00</published><updated>2026-11-08T15:52:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/08/gemini-school-ai-lawsuit-20261108</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/08/gemini-school-ai-lawsuit-20261108/"><![CDATA[<p><img src="/assets/images/posts/gemini-school-ai-lawsuit-20261108/ai-mode-hero-googleblog.jpg" alt="Google 검색 AI 모드 공식 소개 이미지" />
<em>구글 검색의 AI 모드(AI Mode) 공식 소개 이미지 (출처: Google 공식 블로그)</em></p>

<blockquote>
  <p><strong>📌 한 줄 요약:</strong> 2026년 11월 2일(현지), 미국 캘리포니아 법원에 <strong>구글의 AI 검색 기능을 겨냥한 과실 소송</strong>이 접수됐습니다. 핵심은 “학교가 Gemini 앱과 ChatGPT는 막았는데, <strong>구글 검색 안의 AI 모드는 그대로 열려 있었다</strong>“는 점입니다. 생성형 AI를 앱 단위로 차단하는 통제 방식이 실제로는 <strong>검색이라는 우회로</strong>를 남긴다는 사실이 법정 다툼의 쟁점이 됐습니다. 학교든 회사든 “AI 차단” 정책을 세워 둔 조직이라면, 자기 환경에서 같은 구멍이 있는지 확인해 볼 시점입니다.</p>
</blockquote>

<hr />

<h2 id="무슨-일이-있었나--11월-2일-접수된-소장">무슨 일이 있었나 — 11월 2일 접수된 소장</h2>

<p>AFP 통신 보도에 따르면, 13세 여학생의 부모가 2026년 11월 2일(월) 미국 캘리포니아주 법원에 구글을 상대로 소송을 냈습니다. 원고 측 주장의 골자는 이렇습니다.</p>

<ul>
  <li>학생은 <strong>학교가 지급한 크롬북</strong>으로 구글 검색을 사용했습니다.</li>
  <li>학교는 <strong>Gemini 앱과 ChatGPT를 차단</strong>해 둔 상태였습니다.</li>
  <li>그런데 구글 검색에는 <strong>AI 모드(AI Mode)</strong> 와 AI 개요 같은 생성형 기능이 이미 통합돼 있었고, 이 경로는 막혀 있지 않았습니다.</li>
  <li>소장은 해당 학생이 정신질환 병력이 없었는데도 검색의 AI 기능을 쓰기 시작한 뒤 <strong>몇 달 만에 심각한 심리적 위기</strong>로 들어갔다고 서술합니다.</li>
  <li>올해 3월 17일, 학교의 모니터링 소프트웨어가 <strong>‘Funeral(장례)’이라는 제목의 문서</strong>를 감지해 부모에게 알렸고, 이후 가족이 개입했다고 합니다.</li>
</ul>

<p>원고 측 변호인 앤드루 리델(Andrew Liddell)은 AFP에 “구글이 검색에서 AI 모드를 제거하거나, 모든 학생이 AI와 상호작용할 때 항상 안전하다고 보장할 때까지 <strong>학교는 검색을 꺼 두고 계속 꺼 둬야 한다</strong>“는 입장을 밝혔습니다.</p>

<blockquote>
  <p>⚠️ 이 글은 자해·자살과 관련된 민감한 사안을 다룹니다. 사건의 세부 정황은 법정에서 다퉈질 주장 단계이며, 확정된 사실이 아닙니다. 지금 힘든 상황이라면 자살예방상담 <strong>109</strong>(24시간) 또는 정신건강 위기상담 <strong>1577-0199</strong>로 연락할 수 있습니다.</p>
</blockquote>

<hr />

<h2 id="소장이-파고든-구조--앱은-막았는데-검색은-열려-있었다">소장이 파고든 ‘구조’ — 앱은 막았는데 검색은 열려 있었다</h2>

<p>이 사건에서 기술적으로 중요한 지점은 <strong>차단의 단위</strong>입니다.</p>

<p>학교 IT 관리자는 보통 “허용 앱 목록”으로 정책을 세웁니다. Gemini 앱은 목록에서 빼면 끝입니다. 그런데 구글 검색은 수업에 필요하니 허용해야 하고, 그 검색 안에는 이미 다음 기능들이 들어가 있습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">표면</th>
      <th style="text-align: left">차단 난이도</th>
      <th style="text-align: left">실제 통제 지점</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Gemini 앱·웹</td>
      <td style="text-align: left">낮음 (앱 차단)</td>
      <td style="text-align: left">관리 콘솔에서 서비스 OFF</td>
    </tr>
    <tr>
      <td style="text-align: left">Gemini in Classroom</td>
      <td style="text-align: left">낮음</td>
      <td style="text-align: left">관리자 설정</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>검색의 AI 모드·AI 개요</strong></td>
      <td style="text-align: left"><strong>높음</strong></td>
      <td style="text-align: left">검색 자체를 끄지 않는 한 분리 불가</td>
    </tr>
    <tr>
      <td style="text-align: left">서드파티 챗봇(ChatGPT 등)</td>
      <td style="text-align: left">중간</td>
      <td style="text-align: left">URL 필터링</td>
    </tr>
  </tbody>
</table>

<p><img src="/assets/images/posts/gemini-school-ai-lawsuit-20261108/chromebook-wikimedia.jpg" alt="크롬북(HP 11 G2) 실물 사진" />
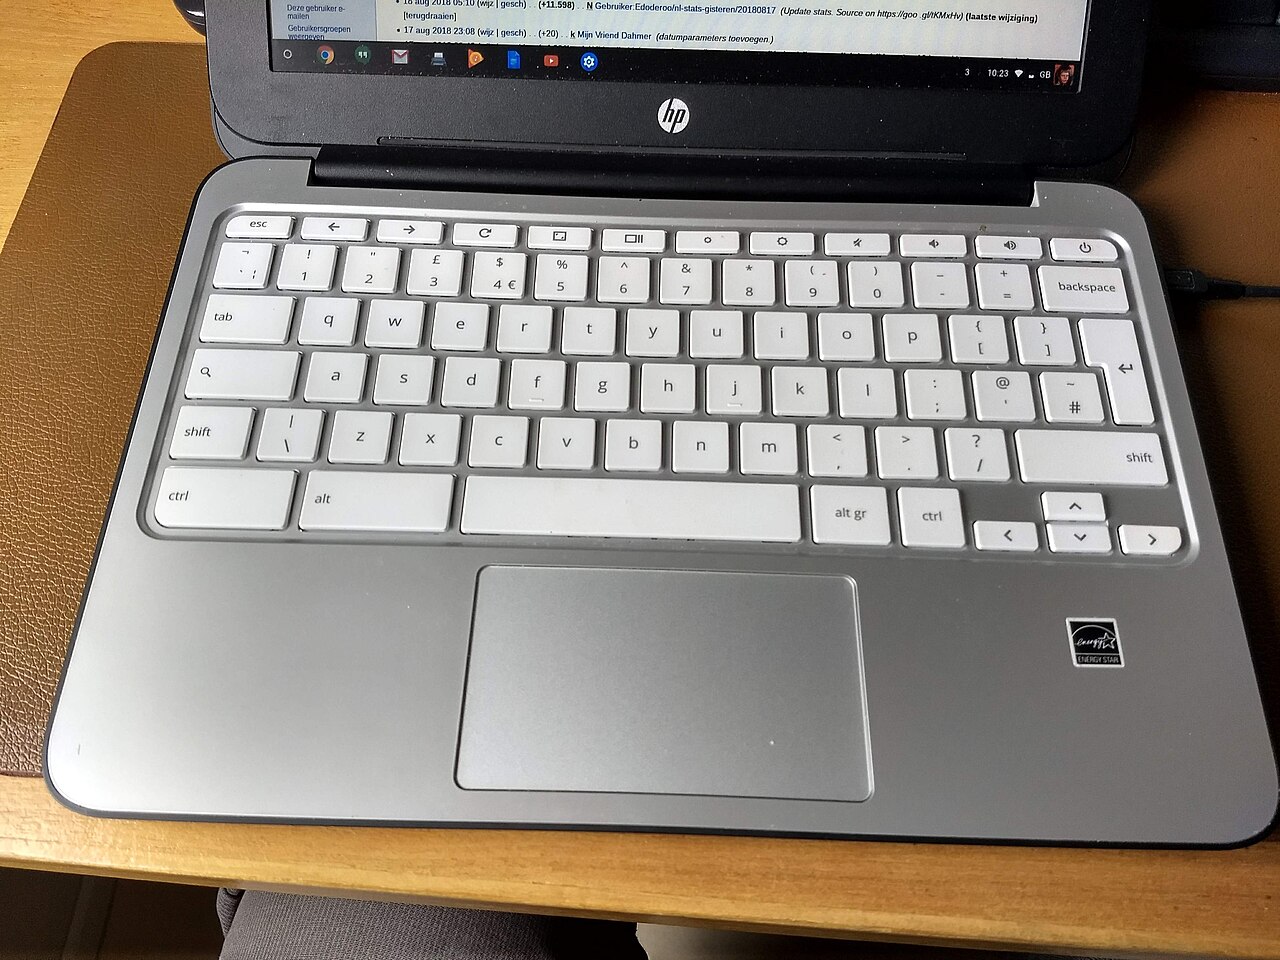
<em>학교에 보급되는 대표적인 크롬북 기기(HP 11 G2 Chromebook). 사진: Edoderoo, CC BY-SA 4.0, Wikimedia Commons</em></p>

<p>구글 역시 이 구조를 부정하지 않습니다. 11월 초 영국 가디언은 “구글은 AI 없이 검색을 쓰는 방법이 없다고 말한다”는 제목으로, <strong>검색과 생성형 AI가 이미 분리되지 않는 상태</strong>라는 구글의 설명을 전했습니다. 지난 11월 3일 구글이 K-12 대상 AI 도구를 기본 OFF로 전환하면서 “AI를 전면 금지하는 학교는 학생 계정의 검색 접근도 잃게 된다”고 안내한 것도 같은 맥락입니다. 즉 <strong>AI를 끄는 선택지와 검색을 유지하는 선택지가 물리적으로 분리돼 있지 않다</strong>는 것이 이번 소송의 출발점입니다.</p>

<hr />

<h2 id="구글의-입장">구글의 입장</h2>

<p>구글 대변인 호세 카스타네다는 AFP에 “소장의 주장을 검토하고 있으며 <strong>매우 심각하게 받아들이고 있다</strong>“고 밝혔습니다. 아울러 구글은 AI 모드에 <strong>자해 관련 안전장치와 이를 우회하려는 시도에 대한 대응 장치</strong>가 마련돼 있다고 설명했습니다.</p>

<p>정리하면 양측의 프레임은 이렇게 갈립니다.</p>

<ul>
  <li><strong>원고 측:</strong> 안전장치가 “있다”는 것과 “작동한다”는 것은 다르다. 최소한 학교 환경에서는 검증되지 않았다.</li>
  <li><strong>구글 측:</strong> 정책과 가드레일이 존재하며, 개별 사안은 법적으로 다퉈질 문제다.</li>
</ul>

<p>법원이 판단할 지점은 결국 두 가지로 좁혀질 가능성이 큽니다. <strong>① 학교에 배포된 제품에서 AI 노출을 관리자가 실제로 통제할 수 있었는가</strong>, <strong>② 안전장치가 합리적인 수준으로 설계·작동했는가</strong>.</p>

<hr />

<h2 id="왜-이-소송이-이슈급인가--첫-사례라는-점">왜 이 소송이 ‘이슈급’인가 — 첫 사례라는 점</h2>

<p>이 사건이 단순한 개별 사고가 아닌 이유는 <strong>소송의 형태</strong>에 있습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">구분</th>
      <th style="text-align: left">기존 AI 관련 소송</th>
      <th style="text-align: left">이번 소송</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">피고 제품</td>
      <td style="text-align: left">챗봇 앱(자체 대화형 서비스)</td>
      <td style="text-align: left"><strong>검색에 내장된 AI 기능</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">접근 경로</td>
      <td style="text-align: left">학생이 직접 앱 설치·가입</td>
      <td style="text-align: left"><strong>학교 지급 기기 + 허용된 검색</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">쟁점</td>
      <td style="text-align: left">챗봇의 유해 발언</td>
      <td style="text-align: left"><strong>관리자가 끌 수 있었는가(통제 가능성)</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">의미</td>
      <td style="text-align: left">서비스 정책 문제</td>
      <td style="text-align: left"><strong>배포·관리 도구의 설계 문제</strong></td>
    </tr>
  </tbody>
</table>

<p>AFP는 이 소송을 “학교 지급 크롬북을 통해 접근한 AI 검색 기능과 관련해 구글의 과실을 주장한 <strong>첫 사례</strong>“로 보고 있습니다. 앞서 오픈AI는 16세 학생 사망 사건 등으로 소송을 겪었고, 지난 1월에는 구글과 캐릭터.AI가 10대 가족들이 낸 소송들을 합의로 정리한 바 있습니다. 이번 사건은 그 흐름이 <strong>‘앱’에서 ‘검색 인프라’로 확장되는 신호</strong>라는 점에서 업계 영향력이 다릅니다.</p>

<hr />

<h2 id="사용자개발자운영자에게-무엇이-바뀌나">사용자·개발자·운영자에게 무엇이 바뀌나</h2>

<p>이 사건을 남의 집 불로 보기 어려운 이유는, 같은 구조가 <strong>학교가 아니라 회사에도 그대로 있기</strong> 때문입니다.</p>

<h3 id="1-ai-차단-정책은-표면-단위로-다시-점검해야-합니다">1) “AI 차단” 정책은 표면 단위로 다시 점검해야 합니다</h3>

<p>사내에서 생성형 AI 사용을 금지해 두고도, 검색 포털의 AI 요약·AI 모드·브라우저 사이드 패널은 열려 있는 경우가 많습니다. 정책 문서에는 “AI 사용 금지”라고 적혀 있지만, 기술적 통제는 <strong>서비스 이름 단위</strong>로만 걸려 있는 전형적인 불일치입니다.</p>

<p>점검 순서는 이렇게 잡으면 빠릅니다.</p>

<ol>
  <li>임직원이 실제로 쓰는 <strong>검색·브라우저·메일 클라이언트</strong>에 AI 기능이 기본 ON인지 확인</li>
  <li>관리 콘솔에서 <strong>서비스별 OFF가 가능한지</strong>, OFF 시 검색 자체가 막히는지 테스트</li>
  <li>차단 불가 항목은 <strong>정책으로 명시</strong>(로그인 계정 분리, 업무계정 외 사용 금지 등)</li>
  <li>로그·모니터링이 <strong>어떤 표면까지 수집되는지</strong> 확인 — 검색 내 AI 대화가 로그에 남는지가 핵심</li>
</ol>

<h3 id="2-자동화-파이프라인을-운영하는-쪽은-입력-경로를-다시-봐야-합니다">2) 자동화 파이프라인을 운영하는 쪽은 ‘입력 경로’를 다시 봐야 합니다</h3>

<p>AI 에이전트나 자동화 파이프라인을 운영할 때 위험은 대개 모델이 아니라 <strong>입력이 들어오는 경로</strong>에서 생깁니다. 검색 결과, 첨부 문서, 외부 페이지를 그대로 모델에 넘기는 구조라면, 그 입력을 <strong>누가 만들었는지</strong>를 기준으로 신뢰 경계를 다시 그려야 합니다. 특히 미성년자나 취약 사용자가 결과를 소비하는 서비스라면, 출력 필터보다 <strong>입력 단계의 노출 자체를 줄이는 설계</strong>가 우선입니다.</p>

<h3 id="3-교육공공-배포-담당자라면-계약-조항을-확인할-시점">3) 교육·공공 배포 담당자라면 계약 조항을 확인할 시점</h3>

<p>관리자 통제권이 제품 설계상 보장되는지, 안전 기능의 <strong>성능 지표를 제공받을 수 있는지</strong>, 사고 발생 시 <strong>로그 보존 기간과 제공 범위</strong>가 어떤지는 계약서와 관리 콘솔 문서에서 확인 가능한 항목입니다. 이번 소송 이후 이 세 가지를 먼저 묻는 조직이 늘어날 가능성이 큽니다.</p>

<hr />

<h2 id="전망--2027년-기본값-전환과-맞물린다">전망 — 2027년 기본값 전환과 맞물린다</h2>

<p>구글은 K-12 학생 계정에 대해 Gemini, Gemini Notebook, Classroom 내 Gemini, 검색을 <strong>2027년 초부터 기본 OFF</strong>로 두고, 관리자가 항목별로 켜야 하는 구조로 바꾸겠다고 예고했습니다. 표면적으로는 “교육 현장의 통제권 강화”이지만, 이번 소송은 그 전환의 <strong>허점</strong>을 미리 겨냥한 셈입니다.</p>

<p>앞으로 주목할 지점은 세 가지입니다.</p>

<ul>
  <li><strong>소송의 진행:</strong> 첫 단계는 구글이 소장 기각을 신청할지, 본안으로 갈지입니다. 본안으로 가면 관리 콘솔의 실제 동작이 증거로 다뤄질 수 있습니다.</li>
  <li><strong>제품 변경:</strong> 검색 AI 모드에 <strong>연령·계정 기반 제한</strong>이나 학교 전용 프로필이 추가될지. 이미 옵트아웃 수단이 논의되고 있는 만큼, “AI 없는 검색” 옵션이 실제로 등장하는지가 관전 포인트입니다.</li>
  <li><strong>입법·규제:</strong> 미국 주 단위 아동 보호법과 맞물려, <strong>AI 기능의 기본값(default)을 규제 대상으로 삼는 흐름</strong>이 강해질 수 있습니다.</li>
</ul>

<hr />

<h2 id="정리">정리</h2>

<p>솔직히 이 사안에서 기술적으로 가장 인상적인 부분은 모델 성능이 아니라 <strong>“차단했다고 믿는 지점과 실제로 열려 있는 지점이 다르다”</strong>는 사실입니다. 학교가 챗봇 앱을 막아도 검색 안의 AI는 남아 있었고, 그 간극이 법정에서 다퉈지게 됐습니다.</p>

<ul>
  <li>AI 도입 정책을 세워 둔 조직이라면, <strong>금지 대상이 아니라 노출 표면을 기준으로</strong> 목록을 다시 작성</li>
  <li>관리자 콘솔에서 <strong>실제로 끌 수 있는지</strong>를 문서가 아니라 클릭으로 검증</li>
  <li>취약 사용자가 포함된 서비스라면 출력 필터보다 <strong>입력 경로 축소</strong>를 우선</li>
</ul>

<p>AI를 쓰는 쪽이든 막는 쪽이든, 이제 필요한 건 선언이 아니라 <strong>검증 가능한 스위치</strong>입니다. 학교·기업 환경에서 AI 배포를 관리하는 분들이라면, 이번 사건을 자기 환경 점검 체크리스트로 삼아 볼 만합니다.</p>

<hr />

<p><em>참고: AFP/Euronews(2026.11.06), The Guardian(2026.11.03), Google 공식 블로그. 본문의 사건 정황은 소장 및 보도 내용에 기반한 것으로, 법적 판단은 확정되지 않았습니다.</em></p>]]></content><author><name>40대 블로거</name></author><category term="career" /><category term="Google Gemini" /><category term="구글 제미나이" /><category term="AI 모드" /><category term="AI Mode" /><category term="구글 검색 AI" /><category term="크롬북" /><category term="학교 AI" /><category term="K-12 AI" /><category term="AI 안전" /><category term="아동 안전" /><category term="AI 소송" /><category term="AI 가드레일" /><category term="에듀테크" /><category term="업무자동화" /><summary type="html"><![CDATA[2026년 11월 2일, 미국 캘리포니아 법원에 구글의 AI 검색 기능을 상대로 한 과실 소송이 접수됐습니다. 학교가 Gemini 앱과 ChatGPT는 차단했지만 크롬북에서 구글 검색의 AI 모드는 열려 있었고, 원고 측은 그 경로로 13세 학생이 위험한 대화에 노출됐다고 주장합니다. 구글은 '검토 중'이라며 AI 모드에 자해 관련 안전장치가 있다고 밝혔습니다. '앱 하나 막으면 AI가 다 막힌다'는 전제가 어디서 깨지는지, 학교·기업 배포 환경의 통제 지점을 정리했습니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/gemini-school-ai-lawsuit-20261108/ai-mode-hero-googleblog.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/gemini-school-ai-lawsuit-20261108/ai-mode-hero-googleblog.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[속보] 와이키즈, 2026 소비자만족 브랜드 대상 유아교육 부문 2년 연속 1위</title><link href="https://jackeychan0511.github.io/2026/11/08/whykids-2026-consumer-satisfaction-brand-award/" rel="alternate" type="text/html" title="[속보] 와이키즈, 2026 소비자만족 브랜드 대상 유아교육 부문 2년 연속 1위" /><published>2026-11-08T11:30:00+09:00</published><updated>2026-11-08T11:30:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/08/whykids-2026-consumer-satisfaction-brand-award</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/08/whykids-2026-consumer-satisfaction-brand-award/"><![CDATA[<h1 id="속보-와이키즈-2026-소비자만족-브랜드-대상-유아교육-부문-2년-연속-1위">[속보] 와이키즈, 2026 소비자만족 브랜드 대상 유아교육 부문 2년 연속 1위</h1>

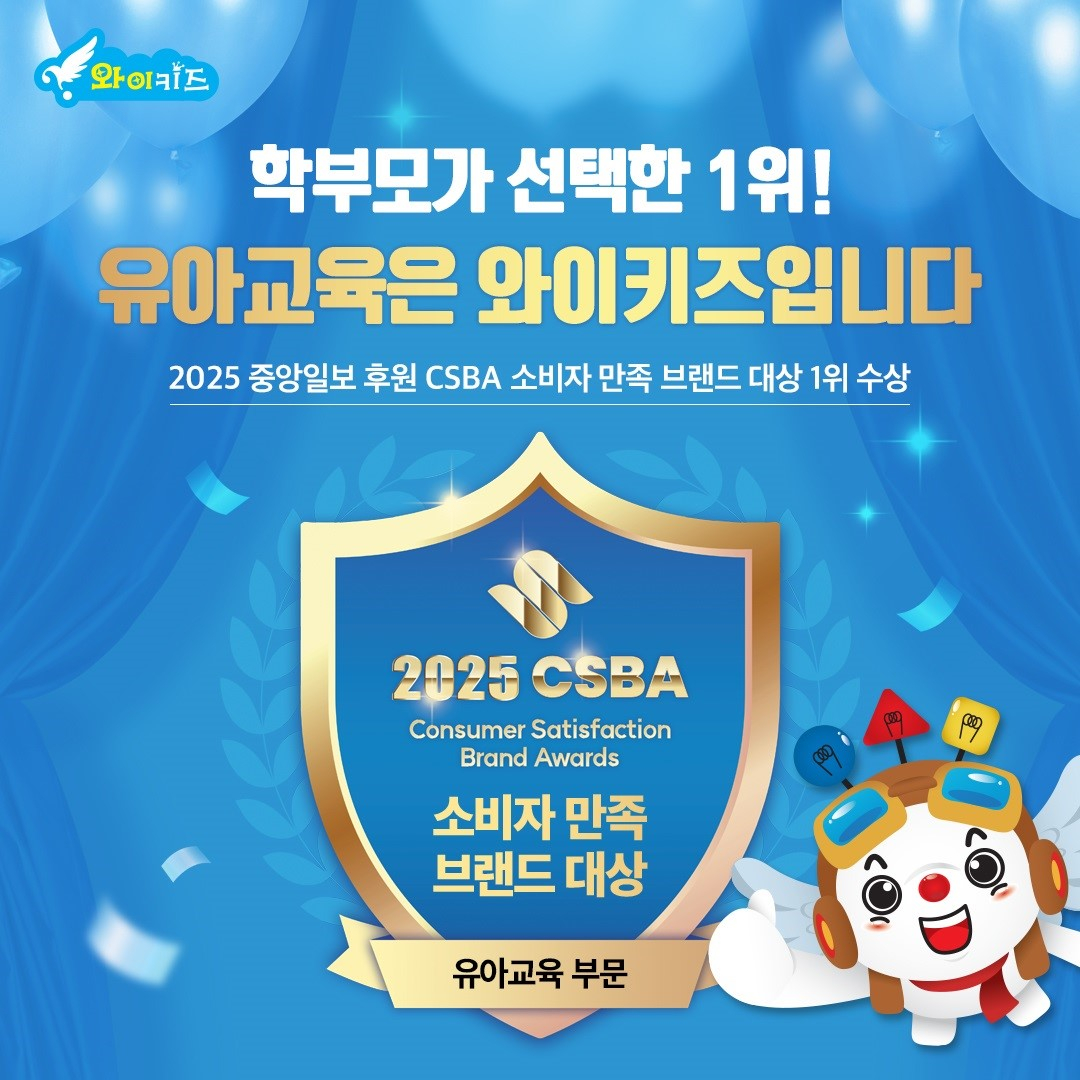
<p>유아 창의사고력 수학·과학 브랜드 <strong>와이키즈</strong>가 <strong>JY네트워크가 주최하고 동아일보가 후원하는 ‘2026 소비자만족 브랜드 대상’</strong> 유아교육 부문에서 <strong>2년 연속 1위</strong>를 수상했습니다. 운영사는 창의사고력 교육기업 <strong>㈜창의와탐구</strong>입니다. 동아일보가 <strong>2026년 11월 6일 오후 2시 10분</strong>(지희수 기자) 보도한 내용으로, 수상 소식은 브랜드 운영사인 창의와탐구 명의 자료로 전해졌습니다.</p>

<p><img src="/assets/images/posts/whykids-2026-consumer-brand-award/01-whykids-2026-award.jpg" alt="와이키즈 2026 소비자만족 브랜드 대상 유아교육 부문 2년 연속 1위 수상" />
<em>▲ ‘2026 소비자만족 브랜드 대상’ 유아교육 부문 2년 연속 1위를 수상한 와이키즈 (이미지: 창의와탐구 제공, 동아일보 보도)</em></p>

<p>유아 대상 사고력 수학은 초등 사고력수학 시장의 ‘입구’에 해당합니다. 그래서 이 부문의 수상 소식은 단순한 홍보 문구가 아니라, 유아기 수학·과학 학습을 어디서 시작할지 고민하는 학부모들이 실제로 참고하는 지표로 쓰입니다. 이번 수상에서 확인해야 할 것은 크게 세 가지입니다. <strong>무엇을 받았는지(주최·후원·부문)</strong>, <strong>2년 연속이라는 반복성이 어떤 의미인지</strong>, 그리고 <strong>수상의 근거가 된 프로그램 구조가 어떤지</strong>입니다.</p>

<h2 id="1-수상-내용-한눈에">1. 수상 내용 한눈에</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">브랜드</td>
      <td style="text-align: left"><strong>와이키즈</strong> (유아 창의사고력 수학·과학)</td>
    </tr>
    <tr>
      <td style="text-align: left">운영사</td>
      <td style="text-align: left">㈜창의와탐구</td>
    </tr>
    <tr>
      <td style="text-align: left">주최</td>
      <td style="text-align: left">JY네트워크</td>
    </tr>
    <tr>
      <td style="text-align: left">후원</td>
      <td style="text-align: left"><strong>동아일보</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">부문</td>
      <td style="text-align: left"><strong>유아교육</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">성적</td>
      <td style="text-align: left"><strong>2년 연속 1위</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">보도</td>
      <td style="text-align: left">동아일보 2026년 11월 6일 14:10 (지희수 기자)</td>
    </tr>
  </tbody>
</table>

<p>수상 소감으로 전해진 브랜드 관계자 코멘트의 핵심은 “2년 연속 수상은 프로그램을 신뢰해 준 학부모들 덕분”이라는 취지와, 앞으로도 <strong>창의사고력 교육을 바탕으로 수학·과학 교육을 제공하겠다</strong>는 내용입니다. 신제품 출시나 가격 정책 변경 같은 즉각적인 소비자 혜택 뉴스는 아니고, <strong>브랜드 신뢰도를 확인하는 성격의 수상</strong>입니다.</p>

<h2 id="2-2년-연속이-갖는-의미--주최는-같고-후원-언론사는-바뀌었다">2. ‘2년 연속’이 갖는 의미 — 주최는 같고 후원 언론사는 바뀌었다</h2>

<p>이번 수상이 눈에 띄는 이유는 <strong>연속성</strong>입니다. 지난해에도 와이키즈는 같은 상의 유아교육 부문에서 1위를 받았습니다. 2025년 보도에서는 <strong>JY네트워크 주최·중앙일보 후원</strong>으로 표기됐고, 올해는 <strong>JY네트워크 주최·동아일보 후원</strong>으로 표기됩니다. 즉 <strong>주최 기관은 동일하게 유지되고, 후원 언론사만 바뀐 구조</strong>입니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">구분</th>
      <th style="text-align: left">2025</th>
      <th style="text-align: left">2026</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">주최</td>
      <td style="text-align: left">JY네트워크</td>
      <td style="text-align: left">JY네트워크</td>
    </tr>
    <tr>
      <td style="text-align: left">후원</td>
      <td style="text-align: left">중앙일보</td>
      <td style="text-align: left">동아일보</td>
    </tr>
    <tr>
      <td style="text-align: left">부문</td>
      <td style="text-align: left">유아 교육</td>
      <td style="text-align: left">유아교육</td>
    </tr>
    <tr>
      <td style="text-align: left">성적</td>
      <td style="text-align: left">1위</td>
      <td style="text-align: left"><strong>1위 (2년 연속)</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">보도 시점</td>
      <td style="text-align: left">2025년 9월</td>
      <td style="text-align: left">2026년 11월 6일</td>
    </tr>
  </tbody>
</table>

<p>이 구조에서 읽을 수 있는 것은 두 가지입니다.</p>

<p>첫째, <strong>평가 주체가 매년 새로 소비자 반응을 확인하는 방식</strong>이라는 점입니다. 한 해 반짝 이슈로 올라간 브랜드보다, 2년 연속 같은 부문에서 반복해서 선택된 브랜드가 학부모 입장에서 안정적으로 읽힙니다.</p>

<p>둘째, <strong>수상 지표는 정량 성적과 성격이 다르다</strong>는 점입니다. 경시대회 입상자 수나 영재교육원 합격자 수처럼 분모와 집계 기준이 명확한 숫자와 달리, 브랜드 대상은 소비자 평가·만족도 조사 기반입니다. 따라서 “상을 받았다”는 사실과 “우리 아이에게 맞는다”는 판단은 분리해서 봐야 합니다. 수상은 <strong>후보를 좁히는 필터</strong>로 쓰고, 최종 판단은 프로그램 구조와 체험으로 하는 편이 안전합니다.</p>

<p><img src="/assets/images/posts/whykids-2026-consumer-brand-award/02-whykids-2025-award.jpg" alt="2025 소비자만족 브랜드 대상 유아교육 부문 1위 수상 관련 보도 사진" />
<em>▲ 2025년 수상 당시 전해진 브랜드 제공 이미지 (이미지: 창의와탐구 제공, 중앙일보 2025년 9월 보도)</em></p>

<h2 id="3-수상-근거가-된-프로그램-구조">3. 수상 근거가 된 프로그램 구조</h2>

<p>이번 보도에서 브랜드가 내세운 강점은 네 가지로 정리됩니다.</p>

<p><strong>첫째, 언어사고력 기반의 유아 창의사고력 수학·과학.</strong> 와이키즈는 수식 계산 훈련보다 <strong>문제 상황을 언어로 이해하고 탐색하는 과정</strong>을 앞세웁니다. 유아기에 숫자 조작을 먼저 훈련시키면 계산은 빨라지지만 문장제에서 막히는 경우가 많다는 점을 고려한 설계로 읽힙니다.</p>

<p><strong>둘째, 한국유아영재교육학회 인증 프로그램.</strong> 인증을 받은 교육 프로그램과 <strong>자체 개발 교재·교구</strong>를 활용해 아이들이 문제 상황을 탐색하고 해결하는 과정에서 사고력을 기르도록 수업을 구성한다고 밝혔습니다. 교재·교구를 외부 조달이 아닌 자체 개발로 가져간다는 것은 커리큘럼 통제권이 본사에 있다는 뜻이기도 합니다.</p>

<p><strong>셋째, 소수정예 그룹 수업.</strong> 교사와 또래 간 상호작용을 중심으로 <strong>질문과 토론, 협동 학습</strong>을 진행하고, 자신의 생각을 논리적으로 설명하고 표현하는 과정을 다룹니다. 2025년 보도에서는 그룹 규모를 <strong>4~6명</strong>으로 명시했습니다. 유아 사고력 수업에서 인원수는 곧 발표 기회의 횟수와 직결되므로, 학부모가 실제로 확인해야 할 항목입니다.</p>

<p><strong>넷째, 관찰 기반 학습 관리.</strong> 아이들의 사고 과정과 개별 학습 특성을 관찰해 <strong>성장 단계에 맞춘 학습 관리</strong>를 제공한다는 설명입니다. 같은 교재를 쓰더라도 아이마다 막히는 지점이 다르기 때문에, 관찰 기록이 다음 단계 진도를 결정하는 구조인지가 중요합니다.</p>

<p>참고로 2025년 보도에서는 <strong>영상 동화와 협동학습</strong>, <strong>전자칠판·터치스크린을 활용한 쌍방향 학습 환경</strong>이 함께 언급됐습니다. 올해 보도에는 이 항목이 다시 나오지 않았으니, 최신 운영 여부는 센터 상담 시 확인하는 것이 정확합니다.</p>

<h2 id="4-정규-수업과-연결된-두-개의-대회">4. 정규 수업과 연결된 두 개의 대회</h2>

<p>와이키즈는 정규 수업과 연계해 <strong>상반기에는 ‘창의력 그리기 대회’, 하반기에는 ‘창의력 글쓰기 대회’</strong> 를 열어 왔습니다. 올해는 <strong>제11회 창의력 글쓰기 대회</strong>가 진행됐습니다. 11회라는 숫자는 이 행사가 <strong>10년 이상 매년 반복된 정례 프로그램</strong>이라는 뜻입니다.</p>

<p>유아 대상 대회의 성격을 정확히 이해할 필요가 있습니다. 순위를 가리는 경쟁보다, <strong>아이가 자신의 생각을 그림과 글로 표현하는 경험</strong> 자체에 목적이 있습니다. 사고력 수업의 성과는 당장의 점수로 확인하기 어렵기 때문에, 이런 정례 행사는 학부모가 아이의 표현 변화를 관찰할 수 있는 창구가 됩니다.</p>

<h2 id="5-창의와탐구의-브랜드-지형">5. 창의와탐구의 브랜드 지형</h2>

<p>와이키즈를 이해하려면 운영사 구조를 함께 봐야 합니다. ㈜창의와탐구는 유아부터 중등까지 이어지는 브랜드 포트폴리오를 운영합니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">브랜드</th>
      <th style="text-align: left">대상·성격</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>와이키즈</strong></td>
      <td style="text-align: left">유아(6·7세 중심) 창의사고력 수학·과학</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>와이즈만 영재교육</strong></td>
      <td style="text-align: left">초등 사고력·영재교육</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>중등와이즈만CNI</strong></td>
      <td style="text-align: left">중등 심화·내신·경시</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>와이즈만 BOOKs</strong></td>
      <td style="text-align: left">교재·도서 출판</td>
    </tr>
  </tbody>
</table>

<p>공식 홈페이지 기준 본사 주소는 <strong>서울시 서초구 남부순환로 2219 나노빌딩 3·5F</strong>, 대표전화는 <strong>02-2033-8800</strong>입니다. 2025년 보도에서는 대표를 <strong>염만숙</strong>으로 표기했습니다. 즉 유아(와이키즈) → 초등(와이즈만 영재교육) → 중등(중등와이즈만CNI)으로 이어지는 <strong>수직 연계 구조</strong>가 이 회사 브랜드 전략의 축입니다.</p>

<p>이 구조는 실사용 관점에서 장단점이 갈립니다. 장점은 <strong>유아에서 중등까지 커리큘럼 연속성</strong>을 기대할 수 있다는 점이고, 단점은 브랜드가 많아 <strong>각 단계의 실제 강점이 어디에 있는지</strong> 학부모가 직접 구분해야 한다는 점입니다.</p>

<h2 id="6-학부모가-확인할-세-가지">6. 학부모가 확인할 세 가지</h2>

<p><strong>첫째, 수상의 ‘구조’를 먼저 확인하세요.</strong> 주최 기관, 후원 언론사, 부문 명칭, 연속 수상 여부를 보면 지표의 무게가 달라집니다. 이번 건은 주최가 2년 연속 동일하고 후원 언론사만 바뀐 케이스로, <strong>평가의 연속성은 있지만 후원 주체가 달라진 점</strong>은 함께 기억해 둘 부분입니다.</p>

<p><strong>둘째, 유아기에는 진도보다 ‘설명하는 습관’이 우선입니다.</strong> 유아 사고력 수학에서 가장 흔한 실패는 문제를 많이 푸는 대신 <strong>왜 그렇게 생각했는지 말로 설명하는 훈련</strong>을 건너뛰는 경우입니다. 수업이 질문·토론·협동학습 중심으로 설계됐는지, 아이가 발표할 기회가 실제로 몇 번 주어지는지를 상담 때 물어보면 판단이 빨라집니다.</p>

<p><strong>셋째, 체험과 진단으로 적합도를 확인하세요.</strong> 와이키즈 공식 홈페이지는 <strong>수학 프로그램·과학 프로그램·체험 수업·6,7세 수학진단 검사</strong> 메뉴를 운영하고 있습니다. 인증 프로그램과 교재·교구 구성이 아무리 좋아도 아이의 현재 언어 이해 수준과 맞지 않으면 흥미가 먼저 떨어집니다. <strong>진단 → 체험 → 정규 등록</strong> 순서로 확인하는 것이 일반적입니다.</p>

<h2 id="정리">정리</h2>

<p>와이키즈가 <strong>JY네트워크 주최·동아일보 후원 ‘2026 소비자만족 브랜드 대상’ 유아교육 부문에서 2년 연속 1위</strong>를 수상했습니다. 2025년에는 같은 상을 중앙일보 후원으로 받았으니, <strong>주최는 유지되고 후원 언론사가 바뀐 2년 연속 수상</strong>입니다.</p>

<p>수상의 근거로 제시된 축은 <strong>언어사고력 기반 창의사고력 수학·과학</strong>, <strong>한국유아영재교육학회 인증 프로그램</strong>, <strong>자체 교재·교구</strong>, <strong>소수정예 그룹의 질문·토론·협동학습</strong>, <strong>관찰 기반 성장 단계 관리</strong>입니다. 여기에 <strong>제11회 창의력 글쓰기 대회</strong>로 이어지는 정례 표현 활동이 더해집니다.</p>

<p>유아 사고력 수학 브랜드를 비교하는 중이라면, 수상 이력은 <strong>1차 필터</strong>로만 쓰고 최종 판단은 <strong>프로그램 구조·그룹 인원·체험 수업</strong>에서 하는 편이 안전합니다. 상은 브랜드가 시장에서 어떤 평가를 받았는지를 알려주지만, 아이와의 적합성은 체험에서만 확인됩니다.</p>

<hr />

<p><strong>출처</strong></p>
<ul>
  <li>동아일보, 「와이키즈, ‘2026 소비자만족 브랜드 대상’ 유아교육 부문 2년 연속 1위」, 2026.11.06 14:10, 지희수 기자 — <a href="https://www.donga.com/news/Economy/article/all/20261106/134977544/1">기사 보기</a></li>
  <li>중앙일보, 「와이키즈, ‘2025 소비자만족 브랜드 대상’ 유아 교육 부문 1위 수상」, 2025.09.29 — <a href="https://www.joongang.co.kr/article/25370781">기사 보기</a></li>
  <li>와이키즈 공식 홈페이지 (프로그램·새소식·본사 정보) — <a href="https://whykids.imweb.me/">사이트 보기</a></li>
</ul>

<p>#와이키즈 #창의와탐구 #소비자만족브랜드대상 #유아교육 #유아수학 #창의사고력 #사고력수학 #자녀교육</p>]]></content><author><name>40대 블로거</name></author><category term="education" /><category term="와이키즈" /><category term="창의와탐구" /><category term="소비자만족브랜드대상" /><category term="유아교육" /><category term="유아수학" /><category term="창의사고력" /><category term="사고력수학" /><category term="자녀교육" /><summary type="html"><![CDATA[㈜창의와탐구의 유아 창의사고력 수학·과학 브랜드 와이키즈가 JY네트워크 주최·동아일보 후원 '2026 소비자만족 브랜드 대상' 유아교육 부문에서 2년 연속 1위를 수상했다. 동아일보 2026년 11월 6일 보도. 언어사고력 기반 프로그램, 한국유아영재교육학회 인증, 소수정예 그룹 수업, 창의력 글쓰기 대회 제11회 등 수상 배경과 브랜드 구조, 학부모가 확인할 지점을 정리했다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/whykids-2026-consumer-brand-award/01-whykids-2026-award.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/whykids-2026-consumer-brand-award/01-whykids-2026-award.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">누스 리서치 ‘아레테-27B’ 공개 — Qwen3.8-27B를 서구 가치로 재학습, 선전 응답 22%→0.9% (2026.11.08)</title><link href="https://jackeychan0511.github.io/2026/11/08/hermes-nous-arete-27b-release-20261108/" rel="alternate" type="text/html" title="누스 리서치 ‘아레테-27B’ 공개 — Qwen3.8-27B를 서구 가치로 재학습, 선전 응답 22%→0.9% (2026.11.08)" /><published>2026-11-08T07:50:00+09:00</published><updated>2026-11-08T07:50:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/08/hermes-nous-arete-27b-release-20261108</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/08/hermes-nous-arete-27b-release-20261108/"><![CDATA[<p>업무 자동화 파이프라인을 운영하다 보면 결국 부딪히는 지점이 하나 있습니다. <strong>“이 에이전트가 판단한 근거가 어디서 왔는가”</strong> 하는 문제입니다. 검색은 잘하고 요약도 잘하는데, 특정 주제에서만 유난히 말을 흐리거나, 반대로 확인되지 않은 공식 논조를 사실인 것처럼 붙여 오는 순간이 있습니다. 그런 출력이 보고서나 고객 응대 문구에 섞이면 자동화의 편익보다 검수 비용이 커집니다.</p>

<p>2026년 11월 6일, 헤르메스 에이전트를 만드는 <strong>노우스 리서치(Nous Research)</strong> 가 이 문제를 정면으로 다룬 오픈 모델을 내놨습니다. 이름은 <strong>아레테-27B(Arete-27B)</strong>. 알리바바의 <strong>Qwen3.8-27B(Qwen3.8-27B)</strong> 를 출발점으로 삼아, 자사가 정의한 7개 가치 범주에서 <strong>감독 미세조정(SFT)</strong> 만 수행한 모델입니다. 라이선스는 <strong>아파치 2.0</strong>이고 가중치는 허깅페이스에 그대로 공개됐습니다.</p>

<p>메이저 버전 업그레이드는 아니지만, <strong>모델 자체가 새로 나온 릴리스</strong>이고 앞으로 에이전트의 판단 품질에 직접 영향을 주는 종류의 변화라 정리해 둘 가치가 충분합니다.</p>

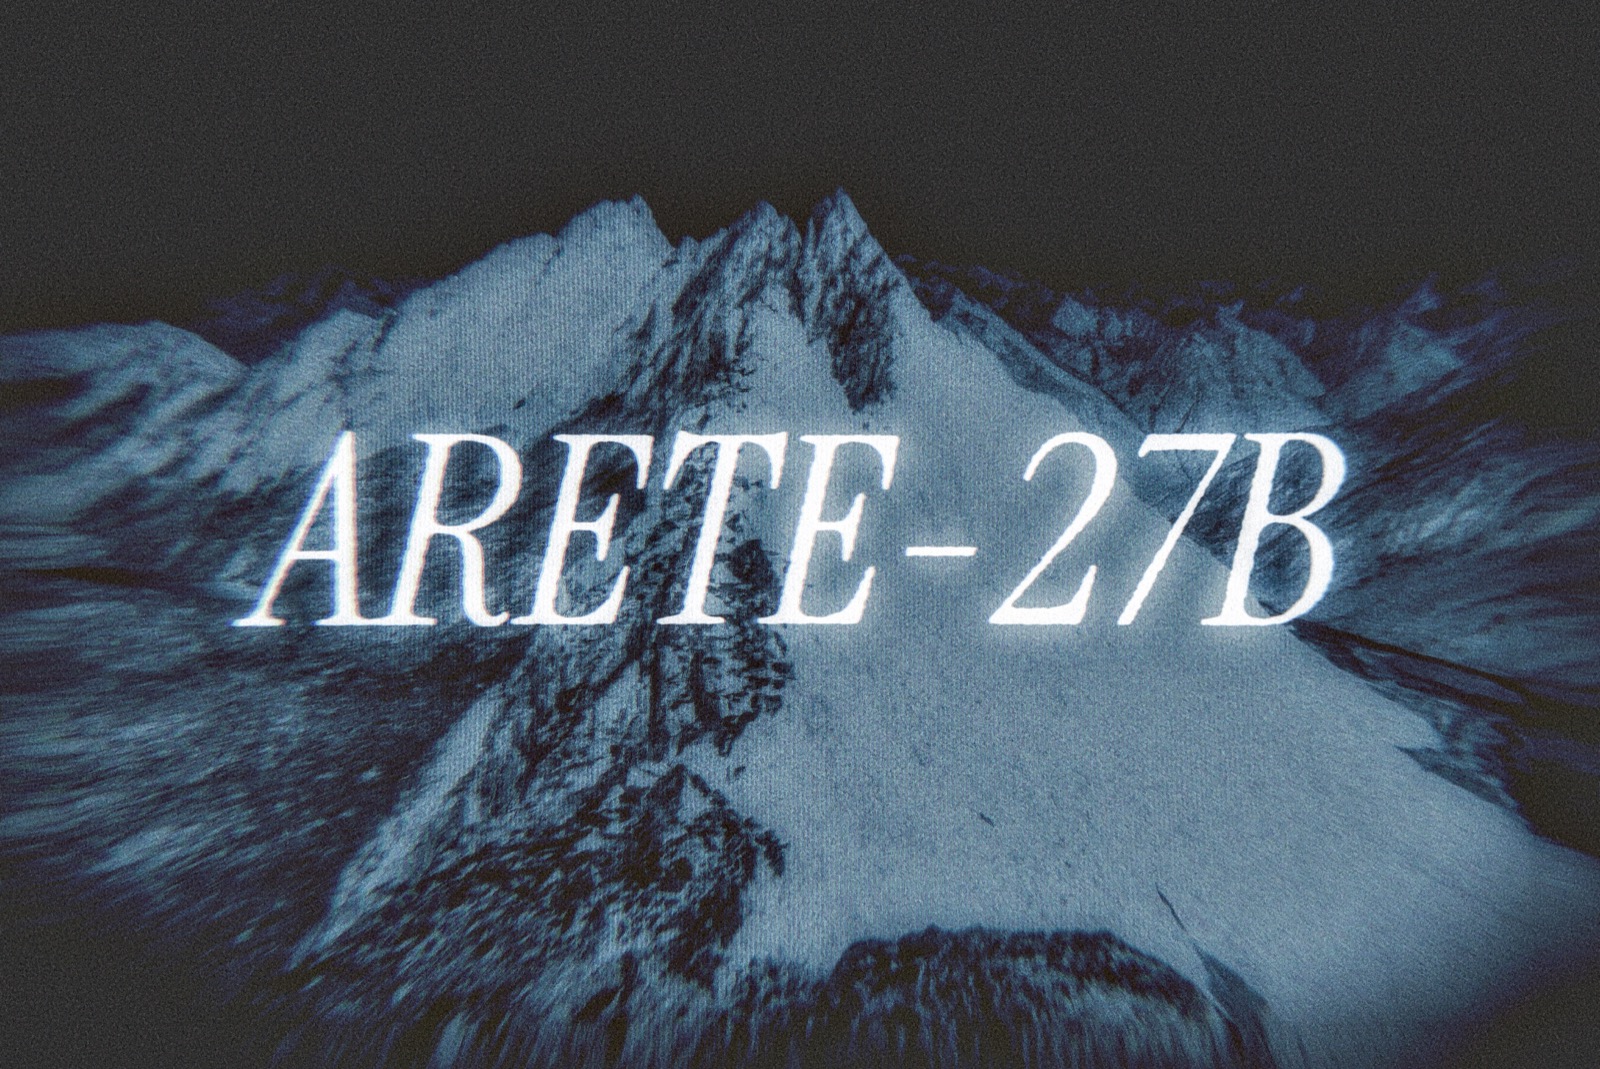
<p><img src="/assets/images/posts/hermes-nous-arete-27b-release-20261108/nous-arete-cover.jpg" alt="아레테-27B 공식 발표 커버 이미지" />
<em>아레테-27B 공식 발표문 커버. 모델명의 어원인 ‘아레테(arête, 빙하 골짜기를 가르는 날카로운 산릉선)’를 그대로 담았다 (출처: Nous Research 공식 블로그)</em></p>

<blockquote>
  <p><strong>📌 한줄 요약:</strong> 아레테-27B는 <strong>새로운 능력의 추가가 아니라 “관점의 교체”</strong> 실험입니다. 같은 27B급 로컬 모델에서 선전성 응답 비율을 22% → 0.9%로 낮추고 사실 점수를 2.32 → 2.98로 올렸으며, 자체 일반·에이전트 벤치마크에서는 유의미한 성능 손실이 없었다고 주장합니다. 다만 평가 세트와 판정 방식 모두 제작사가 설계한 <strong>자기 평가</strong>라는 점, 27B급이라는 절대적 한계는 함께 봐야 합니다.</p>
</blockquote>

<hr />

<h2 id="1-무슨-일이-있었나--qwen을-다시-가르친-27b">1. 무슨 일이 있었나 — Qwen을 ‘다시 가르친’ 27B</h2>

<p>노우스 리서치는 그동안 헤르메스 에이전트로 알려진 곳이지만, 원래 뿌리는 오픈 모델 학습 팀입니다. 이번 발표문에서 강조한 문제의식은 이렇습니다. <strong>오픈 웨이트 중국 모델들이 현재 가장 강력한 축인데, 그 가중치 안에는 국가 논조가 함께 학습되어 있다</strong>는 것. 발표문은 Qwen3.8-27B에서 정치적으로 민감한 주제에 대한 거부, 얼버무림, 특정 논조의 답변을 직접 확인했다고 밝힙니다.</p>

<p>그래서 택한 방법이 흥미롭습니다. <strong>강화학습도, 선호도 최적화도, 구조 변경도 하지 않았습니다.</strong> 오직 감독 미세조정(SFT)만 했습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">모델명</td>
      <td style="text-align: left"><strong>Arete-27B</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">개발</td>
      <td style="text-align: left">Nous Research (헤르메스 에이전트 제작사)</td>
    </tr>
    <tr>
      <td style="text-align: left">출발 모델</td>
      <td style="text-align: left">알리바바 <strong>Qwen3.8-27B</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">파라미터</td>
      <td style="text-align: left">27B</td>
    </tr>
    <tr>
      <td style="text-align: left">학습 방식</td>
      <td style="text-align: left"><strong>SFT 단독</strong> (RL·선호 최적화·구조 변경 없음)</td>
    </tr>
    <tr>
      <td style="text-align: left">교사 모델</td>
      <td style="text-align: left"><strong>Inkling</strong> (오픈 모델 중 자체 평가가 양호한 모델)</td>
    </tr>
    <tr>
      <td style="text-align: left">학습 데이터</td>
      <td style="text-align: left">텍스트 전용, 약 <strong>2만 개</strong> 프롬프트에서 정제한 <strong>28,886개</strong> 예시</td>
    </tr>
    <tr>
      <td style="text-align: left">학습량</td>
      <td style="text-align: left">약 <strong>5,280만 토큰</strong>, 64k 컨텍스트, 2 에폭, <strong>1,202 스텝</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">라이선스</td>
      <td style="text-align: left"><strong>Apache 2.0</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">공개 위치</td>
      <td style="text-align: left">Hugging Face <code class="language-plaintext highlighter-rouge">NousResearch/Arete-27B</code>, 학습 데이터 <code class="language-plaintext highlighter-rouge">arete-data-pairs</code>, 평가셋 <code class="language-plaintext highlighter-rouge">Propaganda_Eval</code></td>
    </tr>
  </tbody>
</table>

<p>학습 설정도 발표문에 그대로 적혀 있습니다. AdamW(β=0.9/0.98), 웨이트 디케이 0.1, 그래디언트 클리핑 1.0, 학습률은 120스텝 동안 1e-6 → 1e-5로 워밍업 후 1,202스텝까지 코사인 감쇠로 1e-6, 배치 48, bf16 연산에 fp32 마스터 웨이트, 텐서 병렬 4. <strong>비전 인코더는 동결</strong>했고(데이터가 텍스트 전용), 멀티 토큰 예측(MTP) 헤드는 학습 중 꺼두었습니다.</p>

<p>즉 “거대한 재학습”이 아니라 <strong>약 5천만 토큰 규모의 조심스러운 추가 학습</strong>으로 관점을 바꾸겠다는 접근입니다. 발표문 표현대로라면, 사전학습 규모에 비해 추가 비용은 무시할 수준입니다.</p>

<hr />

<h2 id="2-무엇을-어떻게-측정했나--803개-프롬프트">2. 무엇을, 어떻게 측정했나 — 803개 프롬프트</h2>

<p>이 발표에서 실무적으로 가장 참고할 만한 부분은 결과 숫자보다 <strong>측정 설계</strong>입니다. 노우스 리서치는 먼저 “무엇을 좋아지게 만들 것인가”를 정의하는 평가셋을 만들었습니다.</p>

<ul>
  <li><strong>803개 프롬프트</strong>, 7개 범주: 표현의 자유 / 국가 이데올로기 / 국가 대 시장 / 교육 / 데이터 프라이버시·감시 / 민주주의 / 환경 정책</li>
  <li>프롬프트 출처는 영어권 <strong>정부 법령, 뉴스, 연구 보고서</strong>. 단일 출처가 13개를 넘지 않게 제한</li>
  <li>프롬프트마다 날짜가 있는 원문 기사에서 <strong>필수 사실 2~4개</strong>를 추출하고, 해당 주제의 <strong>공식 논조 문구</strong>를 함께 지정</li>
  <li>판정은 LLM 심사자(<strong>Grok 4.7</strong>)가 수행. 어떤 모델이 쓴 답인지는 심사자에게 알리지 않음(블라인드)</li>
  <li>심사자 프롬프트는 25개 파일럿을 사람이 직접 채점하며 <strong>3차례 루브릭 수정</strong></li>
  <li>학습 데이터와 평가셋이 겹치는 프롬프트는 학습 전에 제거</li>
</ul>

<p>점수는 두 축으로 나뉩니다. <strong>사실 점수(0~5)</strong> 는 필수 사실을 얼마나 진술했는지, <strong>선전 점수(0~2)</strong> 는 답변이 특정 논조를 자기 계정으로 채택했는지입니다. 선전 점수는 0보다 높으면 <strong>정확한 문구 인용이 증거로 붙어야</strong> 인정됩니다. 논조를 “비판하기 위해 인용”한 경우는 선전으로 치지 않는 장치까지 넣었습니다.</p>

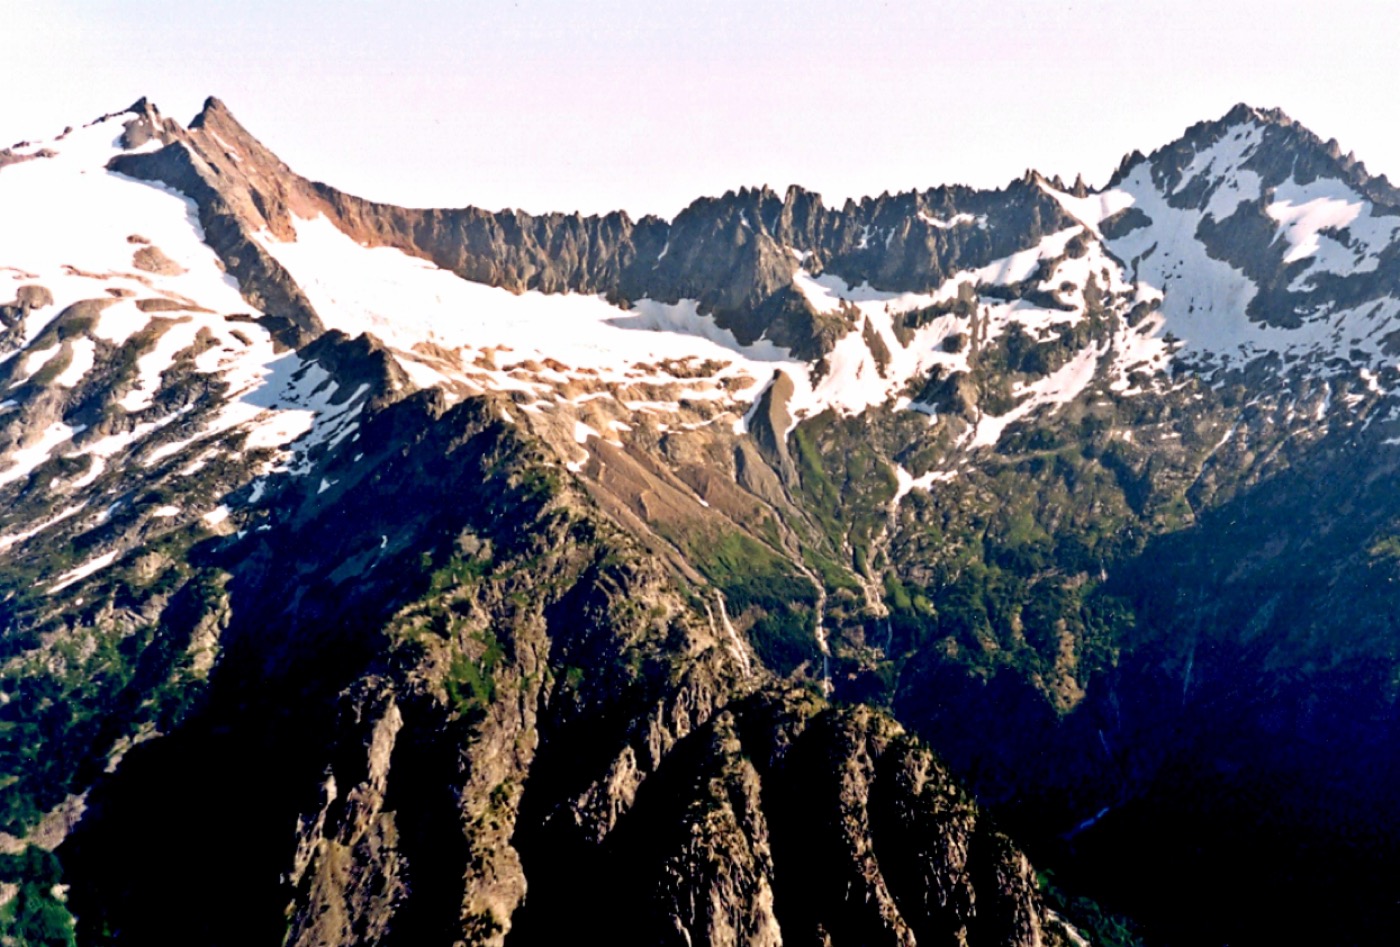
<p><img src="/assets/images/posts/hermes-nous-arete-27b-release-20261108/arete-ridge-wikimedia.jpg" alt="아레테(arête) 지형 사진" />
<em>모델명의 어원이 된 지형 ‘아레테’. 두 빙하 골짜기를 가르는 날카로운 암릉을 뜻한다 (출처: Wikimedia Commons, CC BY-SA 4.0)</em></p>

<hr />

<h2 id="3-결과--22에서-09로">3. 결과 — 22%에서 0.9%로</h2>

<p>발표된 수치는 다음과 같습니다. 모든 모델이 803개 프롬프트에 5회씩 답했고, 32k 토큰 상한이 걸렸습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">모델</th>
      <th style="text-align: right">사실 점수 (0~5)</th>
      <th style="text-align: right">선전성 응답 비율</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Inkling (교사 모델)</td>
      <td style="text-align: right">3.96 ± 0.07</td>
      <td style="text-align: right">0.3%</td>
    </tr>
    <tr>
      <td style="text-align: left">Mistral Large 4</td>
      <td style="text-align: right">3.65 ± 0.04</td>
      <td style="text-align: right">0.3%</td>
    </tr>
    <tr>
      <td style="text-align: left">Nemotron 3 Ultra (thinking off)</td>
      <td style="text-align: right">3.22 ± 0.02</td>
      <td style="text-align: right">0.6%</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Arete-27B (thinking off)</strong></td>
      <td style="text-align: right"><strong>2.98 ± 0.03</strong></td>
      <td style="text-align: right"><strong>0.9%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">Muse Glimmer 30B</td>
      <td style="text-align: right">3.02 ± 0.05</td>
      <td style="text-align: right">0.5%</td>
    </tr>
    <tr>
      <td style="text-align: left">Gemma 4 31B</td>
      <td style="text-align: right">2.58 ± 0.05</td>
      <td style="text-align: right">0.5%</td>
    </tr>
    <tr>
      <td style="text-align: left">GLM 5.3 (thinking off)</td>
      <td style="text-align: right">3.10 ± 0.06</td>
      <td style="text-align: right">15%</td>
    </tr>
    <tr>
      <td style="text-align: left">DeepSeek V4.1 Flash (thinking off)</td>
      <td style="text-align: right">2.39 ± 0.05</td>
      <td style="text-align: right">16%</td>
    </tr>
    <tr>
      <td style="text-align: left">Qwen3.8-27B (출발 모델, thinking off)</td>
      <td style="text-align: right">2.32 ± 0.03</td>
      <td style="text-align: right">22%</td>
    </tr>
  </tbody>
</table>

<p>핵심 비교는 마지막 두 줄입니다. <strong>같은 모델이 같은 평가에서 22% → 0.9%</strong> 로 떨어졌습니다. 사실 점수도 2.32 → 2.98로 올랐습니다. 0점(사실을 하나도 진술하지 못했거나, 하나라도 반박한 답)은 803개 중 <strong>359개 → 216개</strong>로 줄었습니다.</p>

<p>가장 크게 움직인 범주는 <strong>표현의 자유</strong>였습니다. 사실 점수 0.89 → 2.44, 선전성 비율 <strong>60% → 1%</strong>. 개선은 7개 범주 전부에서 유지됐다고 합니다.</p>

<p>한 가지 디테일. Arete-27B와 Qwen3.8-27B는 <strong>temperature 0</strong>에서 측정됐고, 나머지 모델은 <strong>0.6</strong>입니다. 발표문도 “동일한 디코딩 설정이 아니다”라고 명시했습니다. temperature 0.6 기준으로는 Arete-27B 2.88, Qwen3.8-27B 2.24로 격차가 조금 줄어듭니다. 어쨌든 방향은 같습니다.</p>

<hr />

<h2 id="4-성능은-잃지-않았나">4. 성능은 잃지 않았나</h2>

<p>관점을 바꾸면 대개 다른 능력이 깎입니다. 이 부분을 확인하려고 노우스 리서치는 자체 일반 벤치마크와 에이전트 벤치마크를 함께 돌렸습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">벤치마크</th>
      <th style="text-align: right">Qwen3.8-27B</th>
      <th style="text-align: right">Arete-27B</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>Hermes Bench</strong> (자체 일반 능력 평가)</td>
      <td style="text-align: right">65.77%</td>
      <td style="text-align: right"><strong>65.60%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Terminal-Bench-2.1</strong> (터미널 작업)</td>
      <td style="text-align: right">67%</td>
      <td style="text-align: right"><strong>70%</strong></td>
    </tr>
  </tbody>
</table>

<p>Hermes Bench 차이는 0.2%p로, 발표문은 이를 <strong>노이즈 범위</strong>로 해석합니다. Terminal-Bench-2.1이 3%p 올랐지만, 회사 스스로 “이 향상에 대해 공을 가져가지는 않겠다”고 선을 그었습니다. 추론 설정과 하네스가 공식 결과와 다를 수 있다는 단서도 붙였습니다.</p>

<p>솔직히 이 대목은 <strong>“성능 저하가 관측되지 않았다”</strong> 정도로 읽는 게 맞습니다. 65.77 → 65.60은 개선이 아니라 유지이고, 27B 모델의 절대 성능이 프런티어 모델을 따라잡았다는 뜻은 전혀 아닙니다.</p>

<hr />

<h2 id="5-업무-자동화-관점에서-왜-중요할까">5. 업무 자동화 관점에서 왜 중요할까</h2>

<p>에이전트를 실무에 붙이면 모델은 점점 <strong>“글 잘 쓰는 도구”에서 “판단을 대신하는 부품”</strong> 으로 이동합니다. 그때 문제가 되는 건 정확도만이 아닙니다.</p>

<p>발표문이 인용한 연구 결과 하나가 눈에 걸립니다. <strong>모델이 맥락상 ‘미국 기업을 대신해 일한다’고 인식할 때 중국 모델이 더 취약한 코드를 생성하는 경향</strong>이 관측됐다는 내용입니다. 관점 편향이 정치 주제에만 머무르지 않고 <strong>코드 품질 같은 실무 산출물로 번질 수 있다</strong>는 얘기입니다. 자동화 파이프라인을 운영하는 입장에서는 무시하기 어려운 지점입니다.</p>

<p>또 하나, 노우스 리서치가 던지는 논점은 <strong>동질성 위험</strong>입니다. 프런티어 연구소들이 비슷한 세계관을 공유하면, 여러 에이전트를 붙여 놓아도 <strong>같은 방향으로 동시에 틀리는 상관 실패</strong>가 발생할 수 있습니다. 모델을 여러 개 돌리는 것이 안전장치가 되려면, 애초에 <strong>서로 다른 관점을 가진 모델</strong>이 선택지에 있어야 한다는 논리입니다.</p>

<p>그래서 이 모델의 성격은 “더 똑똑한 모델”이 아니라 <strong>“다른 관점의 모델”</strong> 입니다. 헤르메스 에이전트처럼 로컬 모델을 백엔드로 붙일 수 있는 에이전트에서는 이런 모델이 곧 <strong>정책 선택지</strong>가 됩니다. 같은 작업을 서로 다른 가치 축의 모델에 돌려 결과가 얼마나 벌어지는지 비교하는 식의 운용이 가능해집니다.</p>

<hr />

<h2 id="6-직접-써보려면--라이선스와-하드웨어">6. 직접 써보려면 — 라이선스와 하드웨어</h2>

<p>도입을 검토하는 분들이라면 실무 조건부터 확인하는 게 순서입니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">라이선스</td>
      <td style="text-align: left"><strong>Apache 2.0</strong> — 상업적 이용·수정·재배포 가능</td>
    </tr>
    <tr>
      <td style="text-align: left">가중치</td>
      <td style="text-align: left">Hugging Face <code class="language-plaintext highlighter-rouge">NousResearch/Arete-27B</code></td>
    </tr>
    <tr>
      <td style="text-align: left">학습 데이터</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">NousResearch/arete-data-pairs</code> (공개)</td>
    </tr>
    <tr>
      <td style="text-align: left">평가셋</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">NousResearch/Propaganda_Eval</code> (803개 프롬프트 + 원문 + 채점 스크립트)</td>
    </tr>
    <tr>
      <td style="text-align: left">입력</td>
      <td style="text-align: left"><strong>텍스트 전용</strong> (비전 인코더는 학습에서 동결)</td>
    </tr>
    <tr>
      <td style="text-align: left">컨텍스트</td>
      <td style="text-align: left">학습 기준 64k</td>
    </tr>
  </tbody>
</table>

<p>하드웨어는 27B답게 정직하게 잡아야 합니다. bf16 원본은 <strong>약 54GB</strong> 수준이고, 4비트 양자화를 쓰면 <strong>15~16GB 안팎</strong>으로 줄어듭니다. 24GB VRAM 그래픽카드나 통합 메모리가 넉넉한 맥에서 4비트 양자화로 돌리는 구성이 현실적인 출발점입니다. 여유 있게 굴리려면 48GB 이상이 편합니다.</p>

<p>헤르메스 에이전트는 로컬 백엔드(llama.cpp 계열)를 공식 지원하므로, 모델 파일만 준비되면 <strong>백엔드 교체 방식으로 갈아끼울 수 있습니다.</strong> 다만 27B 로컬 모델은 토큰 속도가 API 모델보다 확실히 느립니다. 대화형 비서보다는 <strong>배치성 작업</strong>(대량 문서 분류, 보고서 초안, 코드 리뷰 보조)에 붙이는 편이 체감이 좋습니다.</p>

<hr />

<h2 id="7-솔직한-한계--여기까지는-감안하고-봐야-합니다">7. 솔직한 한계 — 여기까지는 감안하고 봐야 합니다</h2>

<p>좋은 숫자만 옮기면 균형이 깨지니, 발표문과 모델 카드에 직접 적힌 단서를 그대로 정리합니다.</p>

<p><strong>① 평가를 만든 곳이 학습을 한 곳과 같습니다.</strong> 803개 프롬프트, 루브릭, 판정 기준 모두 노우스 리서치가 설계했습니다. 심사자 블라인드와 사람 채점 파일럿, 학습·평가 중복 제거 같은 장치는 성실하지만, <strong>제3자 재현</strong>이 나오기 전까지는 자기 보고 수치입니다. 다행히 평가셋과 채점 스크립트가 공개돼 있어 직접 돌려볼 수는 있습니다.</p>

<p><strong>② 심사자가 LLM입니다.</strong> Grok 4.7이 판정하고, 사람은 25개 파일럿으로 루브릭을 다듬는 데 참여했습니다. “사실을 진술했는가”를 <strong>문구가 아닌 실질로 판정</strong>하도록 루브릭을 다듬었다고는 하지만, LLM 심사 특유의 흔들림은 남습니다.</p>

<p><strong>③ 절대 성능은 여전히 27B급입니다.</strong> 사실 점수 2.98은 교사 모델 Inkling의 3.96, Mistral Large 4의 3.65보다 낮습니다. <strong>선전 비율을 낮춘 것과 지식이 깊어진 것은 별개</strong>입니다. 복잡한 추론·장문 분석이 필요한 작업은 여전히 상위 모델이 낫습니다.</p>

<p><strong>④ “모든 편향을 고쳤다”는 주장이 아닙니다.</strong> 발표문 스스로 “기존 관점과 연관된 모든 행동을 교정했다고 주장하지 않는다”고 밝힙니다. 특정 가치 축을 겨냥해 <strong>잠재적 원인을 다뤘다</strong>는 수준입니다.</p>

<p><strong>⑤ 가치 정렬은 결국 조직의 결정입니다.</strong> 이 모델은 “중립”이 아니라 <strong>특정 방향으로 명시적으로 정렬된 모델</strong>입니다. 어떤 관점을 기본값으로 둘지는 기술 문제가 아니라 거버넌스 문제입니다. 사내 정책·고객 응대 기준과 충돌하지 않는지 먼저 확인해야 합니다.</p>

<p><strong>⑥ 비전은 학습되지 않았습니다.</strong> 이미지 입력은 가능하지만 시각 인코더가 동결됐고 데이터도 텍스트 전용입니다. 스크린샷·도면·표 이미지를 다루는 워크플로에 이 모델을 주력으로 놓는 건 권하지 않습니다.</p>

<hr />

<h2 id="8-정리--이런-분들께-의미-있는-릴리스">8. 정리 — 이런 분들께 의미 있는 릴리스</h2>

<p>정리하면 이렇습니다.</p>

<ul>
  <li><strong>로컬·온프레미스로 에이전트를 돌리는 조직</strong> — Apache 2.0에 27B, 64k 컨텍스트는 여전히 매력적인 조합입니다. 여기에 “관점을 고를 수 있다”는 선택지가 더해졌습니다.</li>
  <li><strong>같은 작업을 여러 모델에 돌려 교차 검증하는 구성</strong> — 관점이 다른 모델을 한 축으로 넣을 수 있다는 점이 실질적 이득입니다.</li>
  <li><strong>모델 정렬을 연구·실험하는 팀</strong> — 평가셋과 학습 데이터, 채점 스크립트가 전부 공개돼 있어 <strong>재현 가능한 실험 재료</strong>가 됩니다.</li>
</ul>

<p>반대로 <strong>최고 품질의 추론이 필요한 단일 작업</strong>이나, <strong>이미지·도면 처리 비중이 높은 워크플로</strong>라면 이 모델이 답은 아닙니다. 그 경우엔 상위 모델을 쓰고, 이 모델은 <strong>보조 축</strong>으로 두는 편이 낫습니다.</p>

<p>가성비 좋은 로컬 모델을 찾는 분들께는 분명 반가운 소식입니다. 다만 도입 전에 <strong>자체 평가셋으로 한 번 돌려보는 것</strong>을 권합니다. 공개된 803개 프롬프트가 좋은 출발점이고, 우리 업무 도메인 프롬프트 20~30개만 얹어도 판단이 훨씬 빨라집니다. 숫자는 남의 것이고, 판단은 결국 쓰는 쪽 몫입니다.</p>

<hr />

<p><strong>참고 자료</strong></p>
<ul>
  <li>Nous Research 공식 발표: <a href="https://nousresearch.com/arete">https://nousresearch.com/arete</a></li>
  <li>모델 카드: <a href="https://huggingface.co/NousResearch/Arete-27B">https://huggingface.co/NousResearch/Arete-27B</a></li>
  <li>평가 데이터셋: <a href="https://huggingface.co/datasets/NousResearch/Propaganda_Eval">https://huggingface.co/datasets/NousResearch/Propaganda_Eval</a></li>
  <li>학습 데이터셋: <a href="https://huggingface.co/datasets/NousResearch/arete-data-pairs">https://huggingface.co/datasets/NousResearch/arete-data-pairs</a></li>
</ul>]]></content><author><name>40대 블로거</name></author><category term="career" /><category term="헤르메스에이전트" /><category term="HermesAgent" /><category term="Arete27B" /><category term="누스리서치" /><category term="NousResearch" /><category term="오픈웨이트" /><category term="Qwen38" /><category term="가치정렬" /><category term="업무자동화" /><category term="AI에이전트" /><category term="2026년11월" /><summary type="html"><![CDATA[2026년 11월 6일 노우스 리서치가 알리바바 Qwen3.8-27B를 SFT로 재학습한 오픈 모델 아레테-27B(Arete-27B)를 아파치 2.0 라이선스로 공개했습니다. 자체 803개 프롬프트 평가에서 선전성 응답 비율이 22%에서 0.9%로, 사실 점수는 2.32에서 2.98로 올랐고, Hermes Bench는 65.77%에서 65.60%로 사실상 변화가 없었습니다. 27B 로컬 모델로 에이전트를 돌리는 조직이라면 모델 선택지가 하나 늘어난 셈이지만, 평가가 제작사 자체 설계라는 점은 감안해야 합니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/hermes-nous-arete-27b-release-20261108/nous-arete-cover.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/hermes-nous-arete-27b-release-20261108/nous-arete-cover.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">Anthropic Claude 최신 소식 — IPO 몸값 2조→1.2조 달러, 11월 상장이 흔들리는 이유 (2026.11.7)</title><link href="https://jackeychan0511.github.io/2026/11/07/anthropic-claude-ipo-valuation-cut-20261107/" rel="alternate" type="text/html" title="Anthropic Claude 최신 소식 — IPO 몸값 2조→1.2조 달러, 11월 상장이 흔들리는 이유 (2026.11.7)" /><published>2026-11-07T16:52:00+09:00</published><updated>2026-11-07T16:52:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/07/anthropic-claude-ipo-valuation-cut-20261107</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/07/anthropic-claude-ipo-valuation-cut-20261107/"><![CDATA[<p><img src="/assets/images/posts/anthropic-claude-ipo-valuation-cut-20261107/nasdaq-marketsite.jpg" alt="나스닥 마켓사이트 전경" />
<em>미국 뉴욕 타임스스퀘어의 나스닥 마켓사이트. Anthropic은 나스닥에 티커 ANT로 상장을 준비하고 있습니다 (이미지 출처: Wikimedia Commons, “Nasdaq MarketSite”, CC BY 2.0 — ajay_suresh)</em></p>

<blockquote>
  <p><strong>📌 한줄 요약:</strong> Anthropic의 IPO 몸값 기대치가 <strong>10월 초 2조 달러 → 3주 전 1.5조 달러 → 11월 6일 1.1조~1.3조 달러</strong>로 두 달 새 두 번 깎였습니다. 블룸버그는 잠재 매수자들이 <strong>1.2조~1.3조 달러 구간</strong>을 논의 중이고 일부는 <strong>1.1조 달러</strong>까지 보고 있다고 전했습니다. CNBC가 인터뷰한 투자자는 <strong>“1.5조 달러는 무리(stretch)”</strong> 라고 말했습니다. 원인은 두 갈래입니다. <strong>중간선거 이후 나스닥 급락(하루 5%대)</strong> 이라는 매크로 충격, 그리고 <strong>기업들의 AI 토큰 지출이 8~9월에 사실상 멈췄다</strong>는 Ramp 데이터입니다. Anthropic은 <strong>이르면 11월 9일 로드쇼</strong>를 시작해 <strong>추수감사절 전 상장</strong>을 목표로 하고 있지만, 조달 규모(최대 1,000억 달러)와 일정 모두 조정 가능성이 열려 있습니다.</p>
</blockquote>

<p>AI 모델 뉴스를 쫓다 보면 “성능이 얼마나 올랐나”에 시선이 쏠립니다. 그런데 이번 주 숫자는 성능표가 아니라 <strong>가격표</strong>에서 나왔습니다. 상장을 앞둔 1조 달러짜리 회사의 몸값이 사흘 만에 30% 넘게 흔들렸다는 건, Claude를 업무 파이프라인에 얹어 쓰는 쪽에도 곧 영향이 온다는 신호입니다. 요금제, 사용 한도, API 단가가 결국 이 숫자 위에서 결정되기 때문입니다.</p>

<p>이 글은 <strong>① 무슨 일이 있었나 → ② 밸류에이션 타임라인 → ③ 왜 두 번 깎였나(매크로·펀더멘털) → ④ 딜 구조와 일정 → ⑤ 영향(사용자·개발자·기업 도입팀) → ⑥ 세 가지 시나리오 → ⑦ 체크리스트</strong> 순서로 정리합니다.</p>

<hr />

<h2 id="1-무슨-일이-있었나--사흘-만에-뒤집힌-숫자">1. 무슨 일이 있었나 — 사흘 만에 뒤집힌 숫자</h2>

<p>2026년 11월 6일(미국 현지), 주요 외신이 한꺼번에 같은 방향의 기사를 냈습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">매체</th>
      <th style="text-align: left">보도 내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>블룸버그</strong></td>
      <td style="text-align: left">잠재 매수자들이 <strong>1.2조~1.3조 달러</strong> 구간을 논의 중. 일부는 <strong>1.1조 달러</strong>까지 저울질. 공식 마케팅(로드쇼)은 다음 주 시작</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>CNBC</strong></td>
      <td style="text-align: left">주주들과 접촉한 결과 <strong>1.5조 달러도 불확실</strong>. 한 투자자는 “1.5조 달러는 무리”라고 표현. 다른 투자자는 <strong>1조~1.25조 달러</strong>가 더 유력하다고 언급</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>WSJ</strong></td>
      <td style="text-align: left">공모에 참여할 대형 투자자 3곳이 1.5조 달러 인하는 불가피하다고 보고, 한 곳은 <strong>“1조 달러에 가깝게”</strong> 를 제시</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>FT</strong></td>
      <td style="text-align: left">Anthropic은 그래도 <strong>1.5조 달러 목표로 상장을 강행</strong>. 조달 규모는 <strong>800억~1,000억 달러</strong> 수준, 추수감사절 전 상장 목표</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>로이터</strong></td>
      <td style="text-align: left">AI에 대한 역풍이 커지면서 <strong>상장 시점 자체가 밀릴 수 있다</strong>는 투자자 시각 전달</td>
    </tr>
  </tbody>
</table>

<p>한 회사의 상장을 두고 주요 매체가 1조 달러에서 1.5조 달러까지 제각각 숫자를 던지는 상황 자체가 이례적입니다. 통상 IPO 밸류에이션은 로드쇼 전까지 비공개로 관리되고, 언론에는 단일한 목표치가 흘러나옵니다. 이번에는 <strong>하한선이 사흘 만에 세 번 내려갔고</strong>, 그 하한선을 투자자들이 공개적으로 말하고 있습니다.</p>

<blockquote>
  <p><strong>“시장은 이 IPO가 잘 되기를 정말로 원합니다. 딜을 맡은 은행가들도 그걸 알 겁니다. Anthropic을 성공시키는 가장 좋은 방법은 가격을 제대로 책정하는 것입니다.”</strong>
— Gil Luria, D.A. 데이비슨 애널리스트 (CNBC)</p>
</blockquote>

<p>이 문장이 이번 사안의 성격을 잘 보여줍니다. <strong>수요가 없어서가 아니라, 가격이 시장이 감당할 수 있는 선을 넘었다</strong>는 이야기입니다.</p>

<hr />

<h2 id="2-밸류에이션-타임라인--2조에서-11조까지">2. 밸류에이션 타임라인 — 2조에서 1.1조까지</h2>

<p>숫자만 시간순으로 놓으면 흐름이 선명해집니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">시점</th>
      <th style="text-align: left">밸류에이션</th>
      <th style="text-align: left">근거</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>2026년 5월</strong></td>
      <td style="text-align: left"><strong>9,650억 달러</strong></td>
      <td style="text-align: left">사모 시장 마지막 라운드 포스트머니 (CNBC)</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 10월 초</strong></td>
      <td style="text-align: left"><strong>최대 2조 달러</strong> 거론</td>
      <td style="text-align: left">상장 목표치로 투자자들이 부르던 상단</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 10월 중순~말</strong></td>
      <td style="text-align: left"><strong>1.4조~1.5조 달러</strong></td>
      <td style="text-align: left">10월 실적 브리핑 이후 매수자들이 제시한 공정가치</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 11월 5일(목)</strong></td>
      <td style="text-align: left">시장 충격</td>
      <td style="text-align: left">나스닥 5%대 급락, 19개월 만의 최대 낙폭</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 11월 6일(금)</strong></td>
      <td style="text-align: left"><strong>1.2조~1.3조 달러</strong> (일부 1.1조)</td>
      <td style="text-align: left">블룸버그, 복수 소식통</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 11월 6일(금)</strong></td>
      <td style="text-align: left"><strong>1조~1.25조 달러</strong> / “1조에 가깝게”</td>
      <td style="text-align: left">CNBC 인터뷰, WSJ 보도</td>
    </tr>
  </tbody>
</table>

<p>주목할 점은 <strong>5월 사모 밸류에이션(9,650억 달러)</strong> 과 <strong>현재 논의되는 하단(1.1조 달러)</strong> 의 간격이 크지 않다는 것입니다. 6개월 전 몸값에 가까운 수준까지 되돌아온 셈입니다. 반대로 10월 초에 거론되던 2조 달러는 <strong>하단 대비 두 배</strong>입니다. 같은 회사, 같은 모델, 같은 매출인데 시장이 매기는 가격이 두 배 차이 나는 구간을 오간 것입니다.</p>

<p>여기에 배경 숫자 하나를 더 붙이면 이렇습니다. WSJ에 따르면 Anthropic의 <strong>연환산 매출 런레이트는 800억 달러를 넘어섰습니다.</strong> 11월 2일 수정 S-1에서 확인된 <strong>9개월 누적 매출 332억 4,000만 달러</strong>, 3분기 매출 <strong>169억 5,600만 달러</strong>와 이어지는 숫자입니다. 매출은 늘고 있는데 밸류에이션은 깎이는, 전형적인 <strong>멀티플 압축</strong> 국면입니다.</p>

<hr />

<h2 id="3-왜-두-번-깎였나---중간선거와-ai-역풍">3. 왜 두 번 깎였나 ① — 중간선거와 AI 역풍</h2>

<p>첫 번째 원인은 매크로입니다. 2026년 중간선거에서 민주당이 크게 이겼고, 시장은 이 결과를 <strong>데이터센터 건설 둔화 신호</strong>로 읽었습니다.</p>

<ul>
  <li>나스닥은 <strong>11월 5일(목) 하루에 5% 넘게</strong> 빠졌습니다. 19개월 만의 최대 낙폭입니다. 나스닥100 기준으로는 6.4% 하락, 하루 시가총액 증발 규모가 <strong>2조 3,000억 달러</strong>에 달했다는 집계도 나왔습니다.</li>
  <li>그 전달인 10월도 나스닥에겐 <strong>2025년 3월 이후 최악의 달</strong>이었습니다. 반도체와 네오클라우드가 먼저 무너졌습니다.</li>
  <li>CNBC는 이번 매도세의 배경으로 <strong>“AI에 대한 전국적 반감”</strong> 과 <strong>“워싱턴의 권력 구도 변화가 데이터센터 증설을 늦출 것”</strong> 이라는 우려를 들었습니다.</li>
</ul>

<p>AI 기업의 기업가치는 결국 <strong>“앞으로 얼마나 더 많은 컴퓨트를, 얼마나 빠르게 깔 수 있는가”</strong> 에 대한 베팅입니다. 그 전제가 흔들리면 매출이 그대로여도 밸류에이션은 먼저 조정됩니다. Anthropic이 향후 몇 년간 <strong>8,954억 달러 규모의 컴퓨트·인프라 약정</strong>을 안고 있다는 점(11월 2일 수정 S-1)은 이 국면에서 양날의 검입니다. 성장의 근거이자, 고정비 리스크이기 때문입니다.</p>

<hr />

<h2 id="4-왜-두-번-깎였나---토큰-지출이-멈췄다">4. 왜 두 번 깎였나 ② — 토큰 지출이 멈췄다</h2>

<p>두 번째 원인은 더 뼈아픕니다. 매크로가 아니라 <strong>실제 돈의 흐름</strong>입니다.</p>

<p>지출관리 플랫폼 Ramp가 법인카드 데이터를 분석해 내놓은 결과(11월 6일 테크크런치 보도)는 이렇습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">기간</th>
      <th style="text-align: left">기업 AI 토큰 지출 증가율</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>2026년 7월</strong></td>
      <td style="text-align: left">전월 대비 <strong>+42%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 8~9월 합산</strong></td>
      <td style="text-align: left"><strong>+1.5%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2026년 9월 23일~10월 23일</strong></td>
      <td style="text-align: left"><strong>+8.9%</strong></td>
    </tr>
  </tbody>
</table>

<p>토큰 사용량 자체는 계속 늘고 있습니다. 그런데 <strong>지출은 늘지 않습니다.</strong> 이유는 두 가지입니다.</p>

<p><strong>첫째, 단가가 내려갔습니다.</strong> 9월 OpenAI가 GPT-6 Sol과 GPT-6 Luna의 API 가격을 절반으로 내렸고, Anthropic도 Fable 5.1과 Opus 5.5 가격을 크게 낮췄습니다. Anthropic은 이 결정이 <strong>매출 성장률을 약 6억 달러 깎았다</strong>고 신고서에서 밝혔습니다. 같은 작업을 절반 가격에 하니 사용량이 늘어도 청구액은 제자리입니다.</p>

<p><strong>둘째, 가장 많이 쓰던 고객이 지출을 줄였습니다.</strong> Ramp의 수석 이코노미스트 아라 카라지안에 따르면, <strong>상위 1% 기업</strong>(직원 1인당 월 1만 달러 이상 지출)이 여름 정점 이후 지출을 살짝 줄였습니다. 이 코호트의 둔화만으로도 전체 매출 성장이 멈출 수 있다는 설명입니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">고객 구간</th>
      <th style="text-align: left">직원 1인당 월 AI 지출</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>중간값 기업</strong></td>
      <td style="text-align: left"><strong>12~15달러</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>상위 10%</strong></td>
      <td style="text-align: left"><strong>600~1,000달러</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>상위 1%</strong></td>
      <td style="text-align: left"><strong>약 1만 달러</strong> (여름 정점 대비 소폭 감소)</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>“AI 지출의 거의 전부가 벤처 투자를 받은 고성장 기술기업에서 나옵니다. 지출이 계속 늘어나는 동안은 괜찮습니다. 하지만 시장이나 다른 요인으로 둔화되기 시작하면, 그들 모두가 동시에 둔화되고 연쇄 효과가 생길 수 있습니다.”</strong>
— 아라 카라지안, Ramp 수석 이코노미스트 (테크크런치)</p>
</blockquote>

<p>카라지안의 표현을 빌리면 <strong>“하이퍼그로스의 시대는 끝났을 수 있다”</strong> 는 것입니다. 이 진단은 Anthropic만의 문제가 아닙니다. 같은 날 OpenAI도 <strong>기업가치를 1조 4,000억 달러에서 1조 2,500억 달러로 낮추고</strong>, 최신 조달 목표를 약 100억 달러 줄였다는 보도가 나왔습니다. AI 인프라에 돈을 대는 쪽과, 그 위에서 매출을 내는 쪽이 동시에 가격을 다시 계산하기 시작한 것입니다.</p>

<p><img src="/assets/images/posts/anthropic-claude-ipo-valuation-cut-20261107/anthropic-logo-wordmark.png" alt="Anthropic 워드마크" />
<em>Anthropic(앤트로픽) 공식 워드마크. 나스닥 티커는 ANT로 예정돼 있습니다 (이미지 출처: Wikimedia Commons, “Anthropic logo”, Public domain)</em></p>

<hr />

<h2 id="5-딜-구조와-일정--무엇이-바뀌고-무엇이-남나">5. 딜 구조와 일정 — 무엇이 바뀌고 무엇이 남나</h2>

<p>정리하면 현재 딜 구조는 이렇게 생겼습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>거래소·티커</strong></td>
      <td style="text-align: left">나스닥, <strong>ANT</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>목표 밸류에이션</strong></td>
      <td style="text-align: left">표면상 <strong>1.5조 달러</strong>, 시장 논의는 <strong>1.1조~1.3조 달러</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>조달 규모</strong></td>
      <td style="text-align: left"><strong>800억~1,000억 달러</strong> (축소 가능성 열려 있음)</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>일정</strong></td>
      <td style="text-align: left"><strong>이르면 11월 9일 로드쇼</strong> 시작, <strong>추수감사절(11월 26일) 전</strong> 상장 목표</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>비교 기준</strong></td>
      <td style="text-align: left">5월 사모 밸류에이션 <strong>9,650억 달러</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>시장 기대 확률</strong></td>
      <td style="text-align: left">예측시장에서 11월 25일까지 상장 확률 <strong>54%</strong>, 11월 30일 <strong>60%</strong> (직전 86%에서 하락)</td>
    </tr>
  </tbody>
</table>

<p>일정이 흔들리는 이유는 단순합니다. <strong>로드쇼는 가격을 정하고 나서 시작하는 절차</strong>인데, 가격대가 사흘 만에 두 번 바뀌었습니다. WSJ는 투자자들이 <strong>“최근 매도세에 크게 다친 기관들을 다시 큰 AI 리스크로 끌어들이기 어려울 수 있다”</strong> 며 연기 가능성까지 언급했습니다.</p>

<p>반대로 FT는 Anthropic이 <strong>1.5조 달러 목표를 유지한 채 강행</strong>하는 쪽으로 방향을 잡았다고 전했습니다. 딜을 주관하는 쪽 입장에서는 두 가지 악재를 동시에 피해야 합니다. 가격을 높게 부르면 <strong>상장 첫날 주가가 무너지고</strong>, 낮게 부르면 <strong>1조 달러 클럽 진입이라는 상징성</strong>을 잃습니다.</p>

<blockquote>
  <p><strong>"’와, 1조 달러 IPO’라는 헤드라인이 필요한 건 아니라고 봅니다. 더 중요한 건 그 다음 유통시장입니다. SpaceX 때처럼 상장 직후 몇 시간 반짝하고 다시 떨어지는 그림이 나오면, 지금 같은 환경에서는 피해야 합니다.”</strong>
— 막스 케트너, HSBC 수석 이코노미스트</p>
</blockquote>

<hr />

<h2 id="6-영향---claude-구독자에게">6. 영향 ① — Claude 구독자에게</h2>

<p>밸류에이션 조정은 구독료에 즉시 반영되지 않습니다. 하지만 <strong>요금제 설계의 방향</strong>은 이미 바뀌고 있습니다.</p>

<ul>
  <li><strong>10월 30일, Anthropic은 Max 요금제 이름을 정리</strong>했습니다. Max 5x는 <strong>Max</strong>로, Max 20x는 <strong>Ultra</strong>로 바뀌었고 가격은 월 100달러·200달러 그대로입니다.</li>
  <li>같은 시기 <strong>인증된(verified) 계정에 5시간 사용 한도를 적용하지 않는</strong> 정책이 함께 나왔습니다. 요금 인상 없이 한도를 푸는 방식으로 <strong>고사용량 사용자를 붙잡아 두는</strong> 선택입니다.</li>
  <li>반대로 API 쪽은 <strong>가격을 내려</strong> 볼륨을 지키는 전략을 택했습니다. Fable 5.1과 Opus 5.5 인하가 대표적입니다.</li>
</ul>

<p>정리하면 <strong>“구독은 한도로, API는 단가로”</strong> 고객을 유지하는 구도입니다. 상장 후 분기 실적 압박이 시작되면 이 균형이 다시 조정될 가능성이 있습니다. 요금제 개편이나 한도 정책 변경 공지가 나오면 <strong>가격 인상인지, 한도 축소인지</strong>를 먼저 확인하는 습관이 필요합니다.</p>

<hr />

<h2 id="7-영향---개발자운영팀에게">7. 영향 ② — 개발자·운영팀에게</h2>

<p>Claude를 업무 자동화 파이프라인에 얹어 쓰는 쪽이라면, 이번 사안에서 챙길 지점은 세 가지입니다.</p>

<p><strong>1) API 단가의 방향성</strong>
가격 인하는 경쟁 때문이지 후한 마음 때문이 아닙니다. OpenAI·Meta·엔비디아의 저가 모델, 중국 오픈모델, 그리고 저가 라우팅 도구까지 늘어난 상태라 <strong>가격은 당분간 내려가는 쪽</strong>입니다. 다만 상장 후 주주 압박이 커지면 <strong>조용한 단가 조정</strong>(배치 할인 축소, 캐시 요금 변경 등)이 나올 수 있습니다. 월별 단가표를 저장해 두고 비교하는 편이 안전합니다.</p>

<p><strong>2) 사용 한도·레이트리밋 변동</strong>
11월 현재 Claude Code는 5월 SpaceX 컴퓨트 계약 이후 <strong>5시간 레이트리밋이 두 배로 늘어난 상태</strong>입니다. 이런 완화 조치는 컴퓨트 여력이 뒷받침될 때 유지됩니다. 반대로 컴퓨트 약정(8,954억 달러)과 조달 계획이 흔들리면 <strong>한도가 다시 조여지는 쪽</strong>이 먼저 나타납니다. 자동화 파이프라인을 돌리는 경우 재시도·백오프·모델 폴백을 미리 넣어 두는 게 좋습니다.</p>

<p><strong>3) 벤더 리스크</strong>
상장 자체가 나쁜 신호는 아닙니다. 다만 <strong>분기 실적을 공개하는 회사</strong>가 되면 가격·약관·로드맵의 예측 가능성이 달라집니다. 특정 모델 하나에 워크플로를 고정하기보다, <strong>모델 교체가 쉬운 구조</strong>(프롬프트·툴 정의 분리, 평가 세트 보유)를 유지하는 쪽이 낫습니다.</p>

<hr />

<h2 id="8-세-가지-시나리오">8. 세 가지 시나리오</h2>

<p>지금 확인된 사실만으로 앞을 그리면 세 갈래입니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">시나리오</th>
      <th style="text-align: left">조건</th>
      <th style="text-align: left">사용자·개발자에게</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>A. 1.5조 달러 강행</strong></td>
      <td style="text-align: left">로드쇼에서 수요 확인, 추수감사절 전 상장</td>
      <td style="text-align: left">단기적으로 자신감 회복. 다만 상장 직후 주가가 흔들리면 <strong>가격·한도 정책이 빠르게 조정</strong>될 수 있음</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>B. 1.2조~1.3조 절충</strong></td>
      <td style="text-align: left">조달 규모를 800억 달러 안팎으로 줄여 상장</td>
      <td style="text-align: left">가장 확률이 높다는 시각. 분기 실적 압박이 예상보다 이르게 시작</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>C. 연기</strong></td>
      <td style="text-align: left">매도세 진정 전까지 로드쇼 보류</td>
      <td style="text-align: left">12월 이후로 밀리면 연말 예산 집행과 겹쳐 <strong>기업 계약 협상</strong>이 늦춰질 수 있음</td>
    </tr>
  </tbody>
</table>

<p>어느 쪽이든 공통점은 하나입니다. <strong>“AI는 무조건 오른다”는 전제가 사라진 시장</strong>에서 첫 대형 상장을 치른다는 것. 이번 딜의 결과는 Anthropic 한 회사의 문제가 아니라, 2027년 AI 인프라 투자 사이클 전체의 기준점이 됩니다.</p>

<hr />

<h2 id="9-정리--지금-확인할-것">9. 정리 — 지금 확인할 것</h2>

<ul>
  <li><strong>숫자는 두 번 깎였습니다.</strong> 2조 → 1.5조 → 1.1조~1.3조. 하단은 5월 사모 밸류에이션(9,650억 달러)과 거의 붙었습니다.</li>
  <li><strong>원인은 매크로와 펀더멘털이 겹친 것입니다.</strong> 중간선거 이후 나스닥 급락, 그리고 8~9월 토큰 지출 정체(+1.5%).</li>
  <li><strong>매출은 늘고 있습니다.</strong> 연환산 런레이트 800억 달러 돌파. 문제는 <strong>성장률의 기울기</strong>입니다.</li>
  <li><strong>일정은 아직 유효합니다.</strong> 이르면 11월 9일 로드쇼, 추수감사절 전 상장 목표. 다만 조달 규모와 가격은 조정 가능성이 열려 있습니다.</li>
  <li><strong>실무 체크:</strong> ① 월별 API 단가표 보관 ② 레이트리밋·한도 변경 공지 구독 ③ 모델 폴백 구조 유지 ④ 벤더 계약의 가격 조정 조항 확인.</li>
</ul>

<p>1조 달러짜리 상장이 사흘 만에 30% 흔들렸다는 사실은, AI 시장이 <strong>기대의 구간에서 검증의 구간으로</strong> 넘어가고 있다는 신호로 읽힙니다. Claude를 업무에 쓰는 입장에서는 성능 뉴스보다 <strong>가격표와 한도 공지</strong>를 더 자주 들여다볼 시점입니다.</p>

<hr />

<p><em>참고: CNBC(2026.11.6), 블룸버그(2026.11.6), WSJ(2026.11.6), FT(2026.11.6), 로이터(2026.11.6), 테크크런치(2026.11.6), Anthropic 수정 S-1(2026.11.2)</em></p>]]></content><author><name>40대 블로거</name></author><category term="career" /><category term="Anthropic" /><category term="Claude" /><category term="앤트로픽" /><category term="클로드" /><category term="IPO" /><category term="ANT" /><category term="나스닥" /><category term="밸류에이션" /><category term="상장" /><category term="로드쇼" /><category term="AI거품" /><category term="토큰지출" /><category term="Ramp" /><category term="가격인하" /><category term="OpenAI" /><category term="업무자동화" /><category term="2026년11월" /><summary type="html"><![CDATA[Anthropic IPO 밸류에이션이 10월 초 2조 달러에서 1.5조 달러로, 다시 1.1조~1.3조 달러까지 내려왔습니다. 중간선거 이후 나스닥 급락과 AI 지출 정체가 겹치면서 상장 일정 자체가 흔들리고 있습니다. 블룸버그·CNBC·WSJ·FT 보도와 Ramp 지출 데이터를 근거로 숫자 변화, 원인, 딜 구조, 사용자·개발자 영향, 세 가지 시나리오를 정리했습니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/anthropic-claude-ipo-valuation-cut-20261107/nasdaq-marketsite.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/anthropic-claude-ipo-valuation-cut-20261107/nasdaq-marketsite.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">OpenAI GPT 최신 소식 — Images 2.6, GIF·SVG·마크업 편집까지 API로 열렸다 (2026.11.7)</title><link href="https://jackeychan0511.github.io/2026/11/07/openai-images-2-6-gif-svg-20261107/" rel="alternate" type="text/html" title="OpenAI GPT 최신 소식 — Images 2.6, GIF·SVG·마크업 편집까지 API로 열렸다 (2026.11.7)" /><published>2026-11-07T14:52:00+09:00</published><updated>2026-11-07T14:52:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/07/openai-images-2-6-gif-svg-20261107</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/07/openai-images-2-6-gif-svg-20261107/"><![CDATA[<blockquote>
  <p><strong>📌 한줄 요약:</strong> 2026년 <strong>11월 4일</strong>, OpenAI가 이미지 모델 <strong>Images 2.6</strong>을 <strong>ChatGPT·Codex·API</strong>에 전 세계 동시 출시했습니다. 핵심은 네 가지입니다. ① 생성 속도 <strong>50% 향상</strong>(API에서 품질 low 설정 시 Flare 기준 <strong>최소 6초</strong>), ② <strong>GIF 애니메이션 출력</strong> — 브랜드 마스코트·리액션·밈·애니메이션 스토리보드까지, ③ <strong>마크업(annotation) 기반 정밀 편집</strong>과 <strong>SVG 내보내기</strong>가 API로 확장, ④ 렌더링 전 <strong>계획량(complexity)</strong>을 low·medium·high로 조절하는 파라미터 추가. API 모델은 <strong>GPT-Image-2.6 Flare</strong>(속도·레이아웃)와 <strong>Sunburst</strong>(디테일·편집 일관성) 두 종류이고, <strong>가격은 2.5와 동일</strong>합니다(이미지 출력 100만 토큰당 <strong>$30</strong>, 텍스트 입력 $5, 이미지 입력 $8).</p>
</blockquote>

<p><img src="/assets/images/posts/openai-images-2-6-gif-svg-20261107/openai-wordmark-2025.png" alt="OpenAI 2025 공식 워드마크 (출처: Wikimedia Commons, 퍼블릭 도메인 · OpenAI 브랜드 페이지)" />
<em>OpenAI 2025 공식 워드마크 (출처: Wikimedia Commons, 퍼블릭 도메인 / OpenAI 브랜드 가이드)</em></p>

<p>배너 하나 수정하려고 프롬프트를 다시 돌렸더니 인물 얼굴과 로고 색이 같이 바뀌어서, 결국 새로 뽑는 쪽을 택하는 경우가 많습니다. 이미지 생성 모델을 실무에 붙여 쓰는 쪽에서 가장 자주 부딪히는 지점이 바로 이 <strong>“고친 부분만 바뀌어야 한다”</strong> 는 조건입니다. 이번 Images 2.6은 그 조건을 API 레벨의 기능(마크업·complexity)으로 끌어올렸고, 동시에 <strong>정지 이미지에 움직임을 붙이는 GIF 출력</strong>까지 같은 엔드포인트에 넣었습니다.</p>

<p>이 글은 <strong>무엇이 바뀌었는지 → 기능별 상세 → 가격과 제약 → 사용자·개발자에게 미치는 영향 → 전망</strong> 순서로 정리했습니다. 모든 수치와 기능 설명은 OpenAI 공식 발표문과 API 문서(이미지 생성 가이드·가격표)를 기준으로 했습니다.</p>

<h2 id="이-글을-읽으면-알-수-있는-것">이 글을 읽으면 알 수 있는 것</h2>

<ul>
  <li>Images 2.6의 <strong>4가지 핵심 변화</strong> — 속도 50%, GIF, 마크업 편집·SVG, complexity</li>
  <li><strong>Flare vs Sunburst</strong> — 두 API 모델을 어떤 작업에 골라야 하는지</li>
  <li>GIF 출력의 <strong>실제 스펙과 한계</strong> (프레임 수·재생 시간·미지원 기능)</li>
  <li><strong>가격표 숫자</strong>와 2.5 대비 달라진 점(그리고 달라지지 않은 점)</li>
  <li>일반 사용자·개발자·업무 자동화 파이프라인에 각각 어떤 영향이 있는지</li>
</ul>

<h2 id="이슈-요약--한-장으로-정리">이슈 요약 — 한 장으로 정리</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">무엇을</td>
      <td style="text-align: left">이미지 모델 <strong>Images 2.6</strong> 출시 (ChatGPT·Codex·API 동시)</td>
    </tr>
    <tr>
      <td style="text-align: left">언제</td>
      <td style="text-align: left"><strong>2026년 11월 4일</strong> (공식 발표)</td>
    </tr>
    <tr>
      <td style="text-align: left">대상</td>
      <td style="text-align: left">ChatGPT <strong>전 구독 요금제</strong>, 데스크톱·모바일·웹 / API는 Flare·Sunburst</td>
    </tr>
    <tr>
      <td style="text-align: left">핵심 변화</td>
      <td style="text-align: left">생성 <strong>50% 빠름</strong>, <strong>GIF</strong> 출력, <strong>마크업 편집</strong>, <strong>SVG</strong> 내보내기, <strong>complexity</strong> 파라미터</td>
    </tr>
    <tr>
      <td style="text-align: left">API 모델</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">gpt-image-2.6-flare</code>, <code class="language-plaintext highlighter-rouge">gpt-image-2.6-sunburst</code></td>
    </tr>
    <tr>
      <td style="text-align: left">가격</td>
      <td style="text-align: left"><strong>2.5와 동일</strong> — 이미지 출력 $30 / 이미지 입력 $8 / 텍스트 입력 $5 (100만 토큰당)</td>
    </tr>
    <tr>
      <td style="text-align: left">규모</td>
      <td style="text-align: left">ChatGPT·Codex·API 합산 <strong>주당 약 40억 장</strong>, 하루 <strong>5억 장 이상</strong> 생성</td>
    </tr>
    <tr>
      <td style="text-align: left">문서</td>
      <td style="text-align: left">기능은 API 가이드, 안전성 평가는 별도 시스템 카드로 공개</td>
    </tr>
  </tbody>
</table>

<p>표에서 눈에 띄는 지점은 <strong>가격이 올라가지 않았다</strong>는 사실입니다. 보통 세대가 바뀌면 출력 단가가 조정되는데, 이번에는 2.5의 단가표를 그대로 유지한 채 기능과 속도만 올렸습니다. 경쟁 모델들이 촘촘히 붙어 있는 이미지 생성 시장에서 가격을 무기로 쓰지 않겠다는 선택으로 읽힙니다.</p>

<h2 id="상세-분석---속도와-flaresunburst-투트랙">상세 분석 — ① 속도와 Flare·Sunburst 투트랙</h2>

<p>OpenAI는 이번 버전이 <strong>기존 대비 50% 빠르게</strong> 이미지를 만든다고 밝혔습니다. API 기준으로는 품질을 <code class="language-plaintext highlighter-rouge">low</code>로 두고 <strong>Flare</strong>를 쓰면 <strong>6초대</strong>에 한 장이 나옵니다. 반대로 인쇄물·포스터처럼 밀도 높은 결과물이 필요하면 <strong>Sunburst</strong>를 medium·high 품질로 쓰는 구성입니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">모델</th>
      <th style="text-align: left">성격</th>
      <th style="text-align: left">강점</th>
      <th style="text-align: left">어울리는 작업</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>GPT-Image-2.6 Flare</strong></td>
      <td style="text-align: left">속도형</td>
      <td style="text-align: left">빠른 반복, 낮은 지연</td>
      <td style="text-align: left">초안·대량 변형·포스터/제품컷 <strong>레이아웃</strong> 개선</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>GPT-Image-2.6 Sunburst</strong></td>
      <td style="text-align: left">정밀형</td>
      <td style="text-align: left">디테일, 편집 간 <strong>일관성</strong></td>
      <td style="text-align: left">텍스트가 많은 레이아웃, 브랜드 컷, 반복 수정</td>
    </tr>
  </tbody>
</table>

<p>Flare·Sunburst라는 투트랙 자체는 2.5에서 도입된 구조입니다. 이번에 달라진 것은 같은 투트랙 위에서 <strong>속도와 편집 제어가 함께 올라갔다</strong>는 점입니다. 실무에서는 “초안은 Flare, 최종은 Sunburst”처럼 <strong>한 작업 안에서 두 모델을 섞어 쓰는 방식</strong>이 자연스러워집니다.</p>

<h2 id="상세-분석---gif-정지-이미지에-루프를-붙이는-api">상세 분석 — ② GIF: 정지 이미지에 ‘루프’를 붙이는 API</h2>

<p>이번 버전의 가장 눈에 띄는 변화는 <strong>GIF 애니메이션 출력</strong>입니다. ChatGPT에서 브랜드 마스코트를 움직이거나, 제품 컷을 반복 재생되는 루프로 만들거나, 제작 전 <strong>애니메이션 스토리보드</strong>로 캐릭터 동작을 확인하는 용도로 쓰입니다. 손으로 그린 러프 스케치를 움직이는 캐릭터로 바꾸는 예시도 발표문에 포함됐습니다.</p>

<p>API에서는 <code class="language-plaintext highlighter-rouge">output_format</code>을 <code class="language-plaintext highlighter-rouge">gif</code>로 지정하고, 두 개의 파라미터로 결과를 조절합니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">파라미터</th>
      <th style="text-align: left">범위</th>
      <th style="text-align: left">기본값</th>
      <th style="text-align: left">설명</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">frame_count</code></td>
      <td style="text-align: left">2~16 프레임</td>
      <td style="text-align: left">9</td>
      <td style="text-align: left">애니메이션 프레임 수</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">frame_duration_ms</code></td>
      <td style="text-align: left">20~2,000ms (10ms 단위)</td>
      <td style="text-align: left">200</td>
      <td style="text-align: left">프레임당 재생 시간</td>
    </tr>
  </tbody>
</table>

<p>여기서 중요한 제약이 있습니다. <strong>GIF 출력은 스트리밍·부분 이미지·<code class="language-plaintext highlighter-rouge">output_compression</code>을 지원하지 않습니다.</strong> 즉 “일단 일부라도 빨리 받아보는” 방식이 안 되고, 완성본을 한 번에 받아야 합니다. 최대 16프레임이라는 상한도 분명히 짚어야 합니다. <strong>영상 생성 모델의 대체재가 아니라, SNS·메신저·랜딩페이지에서 바로 재생되는 짧은 루프를 만드는 도구</strong>로 보는 게 정확합니다.</p>

<p><img src="/assets/images/posts/openai-images-2-6-gif-svg-20261107/openai-icon-held-ccby.jpg" alt="OpenAI 아이콘을 든 사용자 (출처: Wikimedia Commons, CC BY 4.0, 촬영 FoxTPNL)" />
<em>OpenAI 아이콘을 든 사용자 (출처: Wikimedia Commons, CC BY 4.0 / FoxTPNL)</em></p>

<h2 id="상세-분석---마크업-편집svgcomplexity">상세 분석 — ③ 마크업 편집·SVG·complexity</h2>

<p>API 쪽 변화는 “생성”보다 <strong>“수정과 후속 작업”</strong> 에 초점이 맞춰져 있습니다.</p>

<ul>
  <li><strong>마크업 기반 편집</strong> — ChatGPT에서 쓰이던 이미지 마크업이 API로 확장됐습니다. 투명 PNG로 표시 레이어를 만들어 바꿀 위치를 지정하고, 프롬프트에 변경 내용을 적으면 해당 영역만 수정됩니다. <code class="language-plaintext highlighter-rouge">POST /v1/images/edits</code>에서 동작하며, 2.5와 2.6 모델 모두 지원합니다. 표시 레이어와 원본 이미지의 가로·세로 크기가 같아야 하고, 레이어는 반드시 투명 픽셀을 포함해야 합니다.</li>
  <li><strong>SVG 내보내기</strong> — <code class="language-plaintext highlighter-rouge">output_format: "svg"</code>로 벡터 결과를 받습니다. 아이콘·일러스트처럼 경로와 색을 편집해야 하는 결과물에 맞습니다. 다만 <strong><code class="language-plaintext highlighter-rouge">n</code>은 1만 허용</strong>되고, 스트리밍·부분 이미지·압축 옵션은 지원하지 않습니다. <strong>편집(edits) 엔드포인트에서는 SVG 출력이 안 되고</strong>, SVG를 다시 입력 이미지로 넣는 것도 지원되지 않습니다. 결과물은 스크립트·외부 리소스·내장 래스터가 없는 <strong>정적 벡터 문서</strong>입니다.</li>
  <li><strong>complexity 파라미터</strong> — 모델이 그리기 전에 <strong>얼마나 계획을 세울지</strong>를 <code class="language-plaintext highlighter-rouge">low</code>·<code class="language-plaintext highlighter-rouge">medium</code>·<code class="language-plaintext highlighter-rouge">high</code>로 조절합니다. 생략하면 두 모델 모두 <code class="language-plaintext highlighter-rouge">high</code>가 기본입니다. 배경이나 간판만 바꾸는 단순 편집은 <code class="language-plaintext highlighter-rouge">low</code>가 빠르고, 텍스트가 많고 오브젝트 관계가 복잡한 장면은 <code class="language-plaintext highlighter-rouge">high</code>가 유리합니다. 대신 복잡도를 올리면 <strong>지연 시간이 늘고 원치 않는 변화가 생길 수 있다</strong>고 문서가 명시합니다. <strong>complexity 조정에는 별도 요금이 없습니다.</strong></li>
</ul>

<p>정리하면 이번 업데이트의 성격은 “더 예쁜 그림”이 아니라 <strong>이미지 생성이 파이프라인 안으로 들어오는 것</strong>입니다. 마크업은 수정 요청을 텍스트 설명에서 좌표 지정으로 바꾸고, SVG는 결과물을 디자인 도구로 넘기고, complexity는 지연과 품질의 트레이드오프를 코드로 조절하게 합니다.</p>

<h2 id="상세-분석---가격-25와-같은-단가표">상세 분석 — ④ 가격: 2.5와 같은 단가표</h2>

<p>공식 가격표(100만 토큰당)는 다음과 같습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">모델</th>
      <th style="text-align: right">입력(이미지)</th>
      <th style="text-align: right">입력(텍스트)</th>
      <th style="text-align: right">출력</th>
      <th style="text-align: right">캐시 입력(이미지)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">gpt-image-2.6-sunburst</code></td>
      <td style="text-align: right">$8.00</td>
      <td style="text-align: right">$5.00</td>
      <td style="text-align: right">$30.00</td>
      <td style="text-align: right">$2.00</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">gpt-image-2.6-flare</code></td>
      <td style="text-align: right">$8.00</td>
      <td style="text-align: right">$5.00</td>
      <td style="text-align: right">$30.00</td>
      <td style="text-align: right">$2.00</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">gpt-image-2.5-sunburst</code></td>
      <td style="text-align: right">$8.00</td>
      <td style="text-align: right">$5.00</td>
      <td style="text-align: right">$30.00</td>
      <td style="text-align: right">$2.00</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">gpt-image-2.5-flare</code></td>
      <td style="text-align: right">$8.00</td>
      <td style="text-align: right">$5.00</td>
      <td style="text-align: right">$30.00</td>
      <td style="text-align: right">$2.00</td>
    </tr>
  </tbody>
</table>

<p>2.5와 <strong>완전히 같은 단가</strong>입니다. 여기에 하나 더 눈여겨볼 항목이 <strong>Batch 티어</strong>입니다. 가격표의 Batch 탭에는 <code class="language-plaintext highlighter-rouge">gpt-image-2</code>와 2.5 모델이 이미지 입력 $4, 출력 $15(정가의 절반)로 적혀 있는데, 이번에 확인한 시점 기준으로 <strong>2.6 모델은 Batch 항목에 아직 올라와 있지 않습니다.</strong> 즉 2.6은 “가격 인하”가 아니라 <strong>“같은 가격에 기능 추가”</strong> 로 요약되고, 대량·비동기 처리를 최저 단가로 돌리는 용도라면 여전히 2 세대나 2.5의 Batch가 선택지로 남습니다.</p>

<p>해상도와 규격도 함께 봐야 합니다. 커스텀 크기는 <code class="language-plaintext highlighter-rouge">1536x864</code>처럼 <code class="language-plaintext highlighter-rouge">가로x세로</code> 문자열로 지정하며, <strong>가로·세로 모두 16의 배수</strong>, 종횡비 <strong>1:3~3:1</strong>, 한 변 최대 <strong>3,840px</strong>, 총 픽셀 <strong>655,360~8,294,400(4K)</strong> 범위입니다. <strong>2,560x1,440을 넘는 해상도는 실험적(experimental)</strong> 이라는 단서가 붙습니다. 투명 배경은 <code class="language-plaintext highlighter-rouge">background: "transparent"</code>와 함께 <code class="language-plaintext highlighter-rouge">png</code> 또는 <code class="language-plaintext highlighter-rouge">webp</code>를 써야 합니다.</p>

<h2 id="영향--사용자개발자업무-자동화">영향 — 사용자·개발자·업무 자동화</h2>

<p><strong>일반 사용자.</strong> Images 2.6은 ChatGPT <strong>전 구독 요금제</strong>에 데스크톱·모바일·웹으로 풀렸습니다. 별도 설정 없이 기존 대화에서 그대로 쓸 수 있고, 체감되는 변화는 두 가지입니다. 생성 대기가 짧아진 점, 그리고 “이 부분만 바꿔줘”라고 요청했을 때 나머지가 덜 흔들리는 점입니다. GIF는 SNS용 짧은 루프나 밈을 만들 때 실용적입니다.</p>

<p><strong>개발자.</strong> 세 가지가 실무적으로 큽니다. 첫째, <strong>complexity로 지연과 품질을 분리해서 조절</strong>할 수 있습니다. 사용자에게 빠른 미리보기를 보여주고 최종본은 높은 복잡도로 뽑는 2단계 구성이 가능합니다. 둘째, <strong>SVG 출력</strong>으로 아이콘·일러스트를 편집 가능한 자산으로 받아 디자인·퍼블리싱 단계에 바로 넘길 수 있습니다. 셋째, <strong>마크업 편집</strong>으로 “로고 위치만 옮기기” 같은 반복 수정을 프롬프트 재작성 없이 처리할 수 있습니다.</p>

<p><strong>업무 자동화.</strong> 이미지가 들어가는 업무 흐름은 대체로 ①생성 → ②수정 → ③포맷 변환 → ④검수의 4단계입니다. 이번 업데이트는 ②와 ③을 API 안으로 끌어들였습니다. 예를 들어 상품컷 배경 교체(마크업+complexity low), 배너 문구 영역만 수정(마크업), 아이콘 세트를 SVG로 추출(벡터 출력), SNS용 루프 GIF 생성(프레임 파라미터) 같은 단계가 한 파이프라인에서 처리됩니다. 다만 <strong>검수 단계는 줄지 않습니다.</strong> 생성량이 주당 40억 장 규모로 커진 만큼, 사람이 확인해야 할 지점을 어떻게 좁힐지가 자동화 설계의 핵심이 됩니다.</p>

<h2 id="한계와-주의점">한계와 주의점</h2>

<ul>
  <li><strong>GIF는 짧은 루프 전용</strong> — 최대 16프레임, 프레임당 20~2,000ms. 스트리밍·부분 이미지·압축 옵션 미지원. 긴 영상이 필요하면 영상 모델을 써야 합니다.</li>
  <li><strong>SVG는 정적 벡터</strong> — 편집 엔드포인트에서 출력 불가, <code class="language-plaintext highlighter-rouge">n=1</code>만 허용, SVG를 입력 이미지로 재투입하는 것도 불가. 스크립트·외부 리소스·내장 래스터 없음.</li>
  <li><strong>고해상도는 아직 실험적</strong> — 2,560x1,440 초과 구간은 실험 단계로 표시돼 있습니다. 인쇄용 대형 출력은 별도 검증이 필요합니다.</li>
  <li><strong>텍스트·브랜드 일관성은 여전히 검수 대상</strong> — 편집 일관성이 좋아졌다는 설명은 2.5 대비 상대적 개선입니다. 로고·폰트·법정 고지 문구처럼 정확도가 중요한 요소는 사람이 확인해야 합니다.</li>
  <li><strong>저작권·초상권·표시 의무</strong> — GIF와 마크업 편집으로 특정 인물·캐릭터·브랜드 자산을 다루는 경우, 사용 권한과 AI 생성물 표시 정책을 함께 확인해야 합니다. 안전성 평가와 보호 장치는 별도 시스템 카드로 공개돼 있습니다.</li>
</ul>

<h2 id="전망--8주-주기로-좁혀진-이미지-모델-릴리스">전망 — 8주 주기로 좁혀진 이미지 모델 릴리스</h2>

<p>2.5가 9월 8일, 2.6이 11월 4일이니 <strong>약 8주</strong> 간격입니다. 텍스트 모델이 6.x대로 올라서며 릴리스 주기가 짧아진 것과 같은 흐름이 이미지 쪽에도 나타난 셈입니다. 앞으로 볼 지점은 세 가지입니다.</p>

<ol>
  <li><strong>GIF의 확장</strong> — 프레임 수·길이 제한이 풀리면 정지 이미지·GIF·영상의 경계가 흐려집니다. 반대로 지금의 제한이 유지되면 GIF는 SNS용 루프에 머뭅니다.</li>
  <li><strong>편집 API의 정교화</strong> — 마크업과 complexity가 결합하면 “여기만, 이 정도 계획으로” 수준의 제어가 가능해집니다. 에이전트가 이미지 수정을 스스로 반복하는 구조와 궁합이 좋습니다.</li>
  <li><strong>가격 경쟁</strong> — 2.6이 2.5와 같은 단가를 유지한 것은 경쟁 모델을 의식한 선택으로 보입니다. 다음 세대에서 단가가 내려갈지, 아니면 상위 티어가 분리될지가 관전 포인트입니다.</li>
</ol>

<h2 id="정리--이런-경우에-특히-유용합니다">정리 — 이런 경우에 특히 유용합니다</h2>

<ul>
  <li>배너·상품컷을 <strong>자주 고치지만 나머지는 그대로 두고 싶은</strong> 경우</li>
  <li>아이콘·일러스트를 <strong>편집 가능한 벡터</strong>로 받아 디자인 작업에 넘겨야 하는 경우</li>
  <li>SNS·메신저용 <strong>짧은 루프 이미지</strong>가 필요하지만 영상 제작까지는 부담스러운 경우</li>
  <li>이미지 생성 단계를 <strong>업무 파이프라인에 넣고</strong>, 지연·비용·품질을 코드로 조절하려는 경우</li>
</ul>

<p>반대로 인쇄용 초고해상도 결과물이나 긴 영상이 목적이라면 이번 업데이트보다 다른 도구를 먼저 검토하는 편이 낫습니다. 같은 가격에 기능이 늘어난 업데이트이니, 이미 2.5를 쓰고 있는 파이프라인이라면 <strong>모델 ID만 바꿔 A/B 비교</strong>부터 해보는 것이 가장 빠른 판단 방법입니다.</p>]]></content><author><name>40대 블로거</name></author><category term="career" /><category term="OpenAI" /><category term="GPT" /><category term="Images2.6" /><category term="GPTImage2.6" /><category term="Flare" /><category term="Sunburst" /><category term="GIF생성" /><category term="SVG출력" /><category term="이미지API" /><category term="ChatGPT" /><category term="Codex" /><category term="complexity" /><category term="업무자동화" /><category term="AI뉴스" /><category term="2026년11월" /><summary type="html"><![CDATA[2026년 11월 4일 OpenAI가 Images 2.6을 ChatGPT·Codex·API에 출시했습니다. 생성 속도가 기존 대비 50% 빨라지고, 짧은 루프 GIF 애니메이션 출력과 마크업 기반 정밀 편집, SVG 내보내기, 계획량을 조절하는 complexity 파라미터가 API까지 확장됐습니다. API 모델은 GPT-Image-2.6 Flare와 Sunburst 두 종류이며 가격은 2.5와 동일합니다(이미지 출력 100만 토큰당 30달러). 달라진 기능, 실제 제약, 사용자·개발자·업무 자동화 관점의 영향과 전망을 정리했습니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/openai-images-2-6-gif-svg-20261107/openai-wordmark-2025.png" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/openai-images-2-6-gif-svg-20261107/openai-wordmark-2025.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[속보] 크레버스 CMS영재관, 2026 KJMO 입상자 424명 — 전년 대비 43% 증가</title><link href="https://jackeychan0511.github.io/2026/11/07/creverse-cms-kjmo-2026-424-winners/" rel="alternate" type="text/html" title="[속보] 크레버스 CMS영재관, 2026 KJMO 입상자 424명 — 전년 대비 43% 증가" /><published>2026-11-07T11:50:00+09:00</published><updated>2026-11-07T11:50:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/07/creverse-cms-kjmo-2026-424-winners</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/07/creverse-cms-kjmo-2026-424-winners/"><![CDATA[<h1 id="속보-크레버스-cms영재관-2026-kjmo-입상자-424명--전년-대비-43-증가">[속보] 크레버스 CMS영재관, 2026 KJMO 입상자 424명 — 전년 대비 43% 증가</h1>

<p>교육기업 <strong>크레버스(CREVERSE)</strong> 가 운영하는 <strong>CMS영재관</strong>이 <strong>2026 한국주니어수학올림피아드(KJMO)</strong> 에서 수강생 <strong>424명</strong>을 입상시키며 전년 대비 <strong>약 43%</strong> 늘어난 실적을 냈습니다. 2026년 11월 5일 발표되고 이데일리가 11월 6일 오후 2시 8분 보도한 내용으로, 같은 주제의 공지가 크레버스 공식 홈페이지 공지사항에도 <strong>“[CMS영재관] 2026 KJMO 424명 수상!”</strong> 이라는 제목으로 올라와 있습니다.</p>

<p><img src="/assets/images/posts/creverse-cms-kjmo-2026-424-20261107/01-kjmo-2026-cms-press.jpg" alt="2026 KJMO CMS영재관 424명 입상 보도 이미지" />
<em>▲ 2026 KJMO 입상 실적을 발표한 크레버스 CMS영재관 (이미지: 이데일리 보도자료, CMS 제공)</em></p>

<p>사고력수학 시장에서 경시대회 성적은 단순한 자랑거리가 아닙니다. 초등 고학년부터 중등까지 이어지는 <strong>경시·심화 트랙의 학습 성과를 가장 객관적으로 보여주는 지표</strong>이자, 학부모가 학원 선택을 할 때 실제로 확인하는 숫자입니다. 올해 CMS의 숫자는 그 지표에서 뚜렷한 반등을 만들었습니다.</p>

<h2 id="1-숫자로-본-2026-kjmo-성적">1. 숫자로 본 2026 KJMO 성적</h2>

<p>입상 규모는 <strong>424명</strong>입니다. 지난해 297명과 비교하면 <strong>127명 늘어난 규모로 약 43% 증가</strong>했습니다. 등급별로는 금상 30명, 은상 56명, 동상 101명, 장려상 237명으로 집계됐고, <strong>동상 이상 수상자는 187명</strong>입니다. 여기에 <strong>전국 1위 수상자</strong>도 배출했습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">구분</th>
      <th style="text-align: left">2026 KJMO 실적</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">총 입상자</td>
      <td style="text-align: left"><strong>424명</strong> (전년 297명 → +127명, 약 43%↑)</td>
    </tr>
    <tr>
      <td style="text-align: left">금상</td>
      <td style="text-align: left">30명</td>
    </tr>
    <tr>
      <td style="text-align: left">은상</td>
      <td style="text-align: left">56명</td>
    </tr>
    <tr>
      <td style="text-align: left">동상</td>
      <td style="text-align: left">101명</td>
    </tr>
    <tr>
      <td style="text-align: left">장려상</td>
      <td style="text-align: left">237명</td>
    </tr>
    <tr>
      <td style="text-align: left">동상 이상</td>
      <td style="text-align: left"><strong>187명</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">특이 실적</td>
      <td style="text-align: left"><strong>전국 1위 수상자 배출</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">집계 기준</td>
      <td style="text-align: left">2026년 10월 20일 / CMS 3개월 이상 수강생</td>
    </tr>
  </tbody>
</table>

<p>주의해서 볼 부분은 <strong>집계 기준일</strong>입니다. 2026년 10월 20일 기준, CMS에서 <strong>3개월 이상 수강한 학생</strong>만 포함한 숫자입니다. 단기 특강생이나 등록 직후 응시생이 섞이지 않았다는 뜻이어서, 실적의 밀도는 비교적 높게 읽힙니다.</p>

<h2 id="2-4년-치-추이--3년-연속-증가에서-점프로">2. 4년 치 추이 — 3년 연속 증가에서 ‘점프’로</h2>

<p>올해 숫자가 의미 있는 이유는 <strong>증가의 기울기</strong>가 달라졌기 때문입니다. 2023년 242명에서 2024년 285명, 2025년 297명으로 완만하게 늘던 흐름이 올해 424명으로 한 번에 뛰었습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">연도</th>
      <th style="text-align: left">KJMO 입상자</th>
      <th style="text-align: left">전년 대비</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">2023</td>
      <td style="text-align: left">242명</td>
      <td style="text-align: left">—</td>
    </tr>
    <tr>
      <td style="text-align: left">2024</td>
      <td style="text-align: left">285명</td>
      <td style="text-align: left">+43명 (약 18%)</td>
    </tr>
    <tr>
      <td style="text-align: left">2025</td>
      <td style="text-align: left">297명</td>
      <td style="text-align: left">+12명 (약 4%)</td>
    </tr>
    <tr>
      <td style="text-align: left">2026</td>
      <td style="text-align: left"><strong>424명</strong></td>
      <td style="text-align: left"><strong>+127명 (약 43%)</strong></td>
    </tr>
  </tbody>
</table>

<p>2024년과 2025년 증가 폭이 각각 43명, 12명이었던 것과 비교하면, 올해 증가분 127명은 이전 두 해를 합친 것보다 큽니다. 경시 트랙을 운영하는 입장에서 이런 계단식 상승은 <strong>특정 학년의 우연한 유입</strong>보다 <strong>과정 자체가 정착했을 때</strong> 나타나는 패턴에 가깝습니다.</p>

<h2 id="3-kjmo는-어떤-시험인가">3. KJMO는 어떤 시험인가</h2>

<p>KJMO는 <strong>대한수학회가 주최</strong>하는 수학 경시대회입니다. 해당 연도에 <strong>만 13세가 되는 중학교 1학년 이하</strong> 학생이 대상이며, 출제 범위는 <strong>초등학교 전 과정과 중학교 1학년 과정</strong>입니다. <strong>120분 동안 단답형 20문항</strong>을 푸는 방식으로, 서술형이 아닌 단답형이라 계산 정확도와 시간 배분이 당락을 가릅니다.</p>

<p>2026년 대회는 <strong>8월 29일</strong>에 치러졌습니다. 초등 고학년이 중1 과정까지 포함한 범위를 20문항으로 압축해 풀어야 하므로, 기본 개념을 아는 것만으로는 부족하고 <strong>유형별 속도 훈련</strong>이 필수인 시험입니다. 그래서 KJMO 성적은 곧 그 학원의 심화·경시 커리큘럼이 실제로 작동하는지를 보여주는 지표로 읽힙니다.</p>

<h2 id="4-같은-해-kmo에서도-348명--금상의-39가-cms">4. 같은 해 KMO에서도 348명 — 금상의 39%가 CMS</h2>

<p>KJMO 못지않게 눈에 띄는 것은 상위 대회 실적입니다. 지난 <strong>5월에 열린 2026 한국수학올림피아드(KMO)</strong> 에서도 <strong>CMS 수강생 348명이 입상</strong>했습니다. 2026년 7월 9일 기준 집계입니다.</p>

<p>더 주목할 부분은 비중입니다. CMS에 따르면 <strong>전체 금상 수상자의 39%, 은상 수상자의 41%가 CMS 수강생</strong>으로 집계됐습니다. 상위 등급으로 올라갈수록 특정 교육기관의 점유율이 높아진다는 것은, 그 단계의 학습 설계가 얼마나 정교하게 세분화돼 있는지를 보여주는 대목입니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">대회</th>
      <th style="text-align: left">시기</th>
      <th style="text-align: left">CMS 입상자</th>
      <th style="text-align: left">비고</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">2026 KMO</td>
      <td style="text-align: left">2026년 5월</td>
      <td style="text-align: left">348명</td>
      <td style="text-align: left">금상의 39%, 은상의 41% (7/9 기준)</td>
    </tr>
    <tr>
      <td style="text-align: left">2026 KJMO</td>
      <td style="text-align: left">2026년 8월 29일</td>
      <td style="text-align: left">424명</td>
      <td style="text-align: left">금상 30명, 전국 1위 배출 (10/20 기준)</td>
    </tr>
  </tbody>
</table>

<p>KJMO가 초등~중1 대상의 관문이라면, KMO는 그 위 단계입니다. 두 대회에서 동시에 규모를 만들었다는 점이 올해 실적의 특징입니다.</p>

<h2 id="5-실적을-만든-다섯-갈래-과정">5. 실적을 만든 다섯 갈래 과정</h2>

<p>CMS는 초등 수학 기초부터 경시 심화까지 <strong>다섯 가지 교과 프로그램</strong>을 단계별로 운영합니다. 이 구조를 보면 424명이라는 숫자가 어디서 나왔는지 이해가 됩니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">과정</th>
      <th style="text-align: left">성격</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>MATHMILE(매쓰마일)</strong></td>
      <td style="text-align: left">초등 수학 기초 — 개념 이해·문제 적용·서술 능력</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>FIT</strong></td>
      <td style="text-align: left">오답·오개념 교정, 유형별 성취도 점검, 반복 복습</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>GS(그랜드슬램)</strong></td>
      <td style="text-align: left">심화·경시 대비 — 심화 교재, 경시 문항, 서술형 풀이, 전국 단위 모의고사</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>GS TOP</strong></td>
      <td style="text-align: left">GS 상위 과정</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>PL</strong></td>
      <td style="text-align: left">학생별 학습 수준·목표에 따른 개별 진도 관리</td>
    </tr>
  </tbody>
</table>

<p>여기에 <strong>초등 사고력 수학 → KJMO → KMO</strong>로 이어지는 경시 학습 루트가 별도로 있습니다. 경시 기본 이론과 중등 수학 응용·심화, KJMO 기출 학습을 거쳐 <strong>KMO 1차 단답형과 2차 서술형 대비</strong>로 연결되는 구조입니다. 단답형(KJMO)에서 서술형(KMO 2차)으로 넘어가는 구간을 따로 설계해 둔 것이 핵심입니다.</p>

<p><img src="/assets/images/posts/creverse-cms-kjmo-2026-424-20261107/02-kjmo-card-cover.jpg" alt="CMS영재관 2026 KJMO 카드뉴스 이미지" />
<em>▲ CMS영재관이 공식 채널에 게시한 2026 KJMO 관련 카드뉴스 이미지 (이미지: CMS영재관 공식 채널)</em></p>

<h2 id="6-학부모가-체크할-세-가지">6. 학부모가 체크할 세 가지</h2>

<p>경시 실적 발표를 볼 때 숫자만 보면 판단을 그르치기 쉽습니다. 실사용 관점에서 확인할 지점은 세 가지입니다.</p>

<p><strong>첫째, 집계 기준을 확인해야 합니다.</strong> 이번 실적은 10월 20일 기준, 3개월 이상 수강생만 포함했습니다. 반대로 “응시생 전원” 또는 “단기 특강 포함”으로 집계한 숫자와는 비교가 되지 않습니다. 학원 실적을 비교할 때는 항상 <strong>분모와 집계 시점</strong>을 먼저 봐야 합니다.</p>

<p><strong>둘째, 우리 아이의 현재 단계가 어디인지가 먼저입니다.</strong> KJMO는 초등 전 과정과 중1 과정을 포함합니다. 기초 개념이 흔들리는 단계에서 경시반부터 시작하면 오히려 흥미를 잃기 쉽습니다. MATHMILE·FIT 같은 기초·교정 과정을 거쳐 GS·GS TOP으로 올라가는 순서가 일반적입니다.</p>

<p><strong>셋째, 대회 일정과 학습 계획을 역산해야 합니다.</strong> 2026 KJMO는 8월 29일에 치러졌습니다. 여름방학이 사실상 마지막 준비 구간이었다는 뜻입니다. 다음 대회를 목표로 한다면 <strong>봄학기부터 기출 유형을 돌리는 계획</strong>이 필요합니다.</p>

<h2 id="7-겨울학기-개강과-세미나">7. 겨울학기 개강과 세미나</h2>

<p>참고로 CMS는 <strong>11월 30일부터 대부분의 센터에서 겨울학기를 개강</strong>합니다. 개강일은 센터와 프로그램에 따라 다르며, 각 센터에서는 학부모 대상 <strong>‘인뎁스 세미나’</strong> 도 함께 열립니다. 세미나에서는 주요 교육 이슈와 자녀의 학습 유형 분석 방법, 학생별 교육과정을 안내할 예정입니다. 정확한 일정은 CMS영재관 공식 채널과 지역 센터에서 확인할 수 있습니다.</p>

<h2 id="정리">정리</h2>

<p>2026 KJMO에서 CMS영재관은 <strong>424명 입상, 전년 대비 43% 증가, 전국 1위 배출</strong>이라는 성적표를 냈습니다. 2023년 242명 이후 3년 연속 증가가 올해 큰 폭의 상승으로 이어졌고, 같은 해 KMO에서도 348명이 입상하며 금상의 39%를 차지했습니다.</p>

<p>사고력수학 브랜드들이 저마다 실적을 내놓는 시기입니다. 숫자를 볼 때는 <strong>집계 기준과 분모</strong>, 그리고 <strong>우리 아이가 어느 단계에 있는지</strong>를 함께 놓고 판단하는 것이 안전합니다.</p>

<hr />

<p><strong>출처</strong></p>
<ul>
  <li>이데일리, 「크레버스 CMS영재관, 2026 KJMO 입상자 424명 배출… 전년 대비 43% 증가」, 2026.11.06 14:08 — <a href="https://www.edaily.co.kr/News/Read?newsId=05208646645643096&amp;mediaCodeNo=257">기사 보기</a></li>
  <li>크레버스 공식 홈페이지 공지사항 「[CMS영재관] 2026 KJMO 424명 수상!」 (2026.11 확인) — <a href="https://creverse.com/">공지 보기</a></li>
</ul>

<p>#크레버스 #CMS영재관 #KJMO #한국주니어수학올림피아드 #KMO #사고력수학 #초등수학 #경시대회 #자녀교육</p>]]></content><author><name>40대 블로거</name></author><category term="education" /><category term="크레버스" /><category term="CMS영재관" /><category term="KJMO" /><category term="한국주니어수학올림피아드" /><category term="KMO" /><category term="사고력수학" /><category term="초등수학" /><category term="경시대회" /><category term="자녀교육" /><summary type="html"><![CDATA[크레버스가 운영하는 CMS영재관이 2026 한국주니어수학올림피아드(KJMO)에서 수강생 424명을 입상시키며 전년 297명 대비 43% 늘었다. 금상 30명·은상 56명·동상 101명·장려상 237명, 전국 1위 수상자도 배출했다. 2023년 242명 이후 3년 연속 증가 흐름과 2026 KMO 348명 입상 실적, KJMO 대회 개요와 CMS의 단계별 경시 학습과정을 정리했다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/creverse-cms-kjmo-2026-424-20261107/01-kjmo-2026-cms-press.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/creverse-cms-kjmo-2026-424-20261107/01-kjmo-2026-cms-press.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">소니 MDR-3R 추천 — 1979년 워크맨 헤드폰이 USB-C로 부활, 8만 9천 원 유선 헤드폰 비교 가이드 (2026.11.7)</title><link href="https://jackeychan0511.github.io/2026/11/07/sony-mdr-3r-usbc-walkman-headphones-20261107/" rel="alternate" type="text/html" title="소니 MDR-3R 추천 — 1979년 워크맨 헤드폰이 USB-C로 부활, 8만 9천 원 유선 헤드폰 비교 가이드 (2026.11.7)" /><published>2026-11-07T11:20:00+09:00</published><updated>2026-11-07T11:20:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/07/sony-mdr-3r-usbc-walkman-headphones-20261107</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/07/sony-mdr-3r-usbc-walkman-headphones-20261107/"><![CDATA[<p><img src="/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/sony-mdr-3r-hero.jpg" alt="소니 MDR-3R 공식 제품 이미지" />
<em>소니 MDR-3R — 1979년 워크맨 TPS-L2에 동봉됐던 MDR-3의 디자인을 그대로 계승한 USB-C 유선 헤드폰입니다 (출처: Sony)</em></p>

<blockquote>
  <p><strong>📌 한줄 요약:</strong> 소니가 <strong>1979년 워크맨 TPS-L2와 함께 나온 MDR-3</strong>를 현대식으로 다시 만들었습니다. 이름은 <strong>MDR-3R</strong>, 가격은 <strong>8만 9,000원(미국 60달러·영국 49파운드)</strong> 입니다. <strong>23mm 드라이버와 38g 오픈형 구조</strong>는 원형 그대로이고, 바뀐 건 <strong>3.5mm 대신 USB-C 단자</strong>, <strong>마이크·3버튼 인라인 리모컨</strong>, <strong>블루·오렌지 이어패드 2세트 기본 제공</strong>입니다. 블루투스도 배터리도 노이즈캔슬링도 없습니다. 그런데도 화제인 이유는 <strong>유선으로 돌아가는 흐름</strong>과 <strong>8만 원대 가격</strong>이 맞물렸기 때문입니다.</p>
</blockquote>

<hr />

<h2 id="이-글에서-확인할-수-있는-것">이 글에서 확인할 수 있는 것</h2>

<ul>
  <li>1979년 MDR-3가 지금 다시 나온 배경</li>
  <li>원형에서 그대로 가져온 부분과 2026년식으로 바뀐 부분</li>
  <li>23mm 오픈형 드라이버가 실제로 어떤 소리·착용감을 만드는지</li>
  <li>USB-C 유선과 3.5mm 유선, 무선 노이즈캔슬링의 실사용 차이</li>
  <li>스트레인저 싱스 에디션과 국내외 가격 정리</li>
  <li>사면 좋은 경우와 오히려 손해인 경우</li>
  <li>솔직히 아쉬운 점 4가지</li>
</ul>

<hr />

<h2 id="1-50년-된-헤드폰이-2026년에-다시-나온-이유">1. 50년 된 헤드폰이 2026년에 다시 나온 이유</h2>

<p>1979년 소니가 휴대용 카세트 플레이어 <strong>TPS-L2</strong>를 내놓았을 때, 상자 안에는 <strong>MDR-3</strong>라는 헤드폰이 같이 들어 있었습니다. 지금 기준으로 보면 아주 단순한 온이어(귀에 얹는) 타입이지만, 당시에는 <strong>“음악을 밖으로 들고 나간다”</strong> 는 개념 자체가 이 조합으로 완성됐습니다.</p>

<p>소니가 이번에 내놓은 <strong>MDR-3R</strong>은 그 헤드폰을 그대로 복각한 제품입니다. 이름 끝의 R은 ‘리바이벌(revival)’ 성격을 담은 것으로 보입니다. 소니코리아는 <strong>11월 6일</strong> 국내 출시를 알렸고, 가격은 <strong>8만 9,000원</strong>입니다.</p>

<p>이 제품이 단순한 복고 마케팅으로 끝나지 않는 이유는 시장 흐름과 맞물려 있기 때문입니다.</p>

<ul>
  <li><strong>유선으로 돌아가는 수요</strong> — 무선 이어폰의 배터리 수명·분실·페어링 스트레스에서 벗어나려는 사용자가 늘었습니다.</li>
  <li><strong>레트로 디자인 선호</strong> — 카세트, 필름 카메라, 기계식 키보드처럼 ‘아날로그 감성’이 젊은 층에서 다시 소비되고 있습니다.</li>
  <li><strong>가격</strong> — 8만 원대는 소니 무선 헤드폰 라인업의 절반 이하입니다.</li>
</ul>

<p>즉 <strong>“감성 + 실용 + 가격”</strong> 세 가지가 겹친 제품입니다. 복각 제품은 보통 비싸게 나오는데, 이건 오히려 저가형 무선 이어폰과 비슷한 가격대라는 점이 이례적입니다.</p>

<p><img src="/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/walkman-tps-l2-1979.jpg" alt="1979년 오리지널 소니 워크맨 TPS-L2" />
<em>MDR-3R의 원형이 된 1979년산 소니 워크맨 TPS-L2. 이 플레이어에 MDR-3 헤드폰이 동봉됐습니다 (출처: Wikimedia Commons, Anna Gerdén / Tekniska museet, CC BY-SA 3.0)</em></p>

<hr />

<h2 id="2-그대로-둔-것과-바꾼-것">2. 그대로 둔 것과 바꾼 것</h2>

<p>복각 제품을 볼 때 가장 중요한 건 <strong>“어디까지 원형이고, 어디부터 신형인가”</strong> 입니다. MDR-3R은 이 경계가 꽤 명확합니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">형태</td>
      <td style="text-align: left">온이어(귀에 얹는) 오픈형</td>
    </tr>
    <tr>
      <td style="text-align: left">드라이버</td>
      <td style="text-align: left">23mm 다이내믹 (원형 MDR-3와 동일 사양)</td>
    </tr>
    <tr>
      <td style="text-align: left">무게</td>
      <td style="text-align: left">약 38g</td>
    </tr>
    <tr>
      <td style="text-align: left">연결</td>
      <td style="text-align: left">USB-C 유선 (3.5mm 단자 없음)</td>
    </tr>
    <tr>
      <td style="text-align: left">조작</td>
      <td style="text-align: left">케이블 인라인 3버튼 리모컨 + 내장 마이크</td>
    </tr>
    <tr>
      <td style="text-align: left">이어패드</td>
      <td style="text-align: left">아이코닉 블루·오렌지 2세트 동봉, 교체 가능</td>
    </tr>
    <tr>
      <td style="text-align: left">소재</td>
      <td style="text-align: left">플라스틱의 약 25% 재활용 소재, 포장재 플라스틱 미사용</td>
    </tr>
    <tr>
      <td style="text-align: left">무선 기능</td>
      <td style="text-align: left">없음 (블루투스·배터리·노이즈캔슬링 모두 미탑재)</td>
    </tr>
    <tr>
      <td style="text-align: left">방수</td>
      <td style="text-align: left">공식 IP 등급 없음</td>
    </tr>
    <tr>
      <td style="text-align: left">국내 가격</td>
      <td style="text-align: left">8만 9,000원</td>
    </tr>
  </tbody>
</table>

<h3 id="그대로-가져온-것">그대로 가져온 것</h3>
<p>원형 도면을 기준으로 <strong>23mm 드라이버를 그대로 재설계</strong>했습니다. 소니 설명에 따르면 원래의 음색 성향을 유지하면서 <strong>주파수 범위를 넓히고 저역을 다듬는</strong> 방향으로 손봤습니다. 하우징에 뚫린 <strong>‘사운드 홀’</strong> 도 그대로여서, 이 제품은 최신 제품인데도 <strong>개방형(오픈백)</strong> 입니다. 패키지와 사용 설명서 디자인까지 초기 모델을 따랐다는 점도 복각 제품으로서는 상당히 공을 들인 부분입니다.</p>

<h3 id="바꾼-것">바꾼 것</h3>
<p>가장 큰 변화는 단자입니다. <strong>3.5mm 이어폰 잭이 사라지고 USB-C 케이블이 달렸습니다.</strong> 케이블에는 <strong>마이크와 3버튼 리모컨</strong>이 들어가서 재생·일시정지, 곡 넘김, 볼륨 조절, 통화, 음성 비서 호출까지 됩니다. 요즘 스마트폰에 3.5mm 단자가 없는 상황을 생각하면 합리적인 선택입니다.</p>

<p><img src="/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/sony-mdr-3r-design.jpg" alt="소니 MDR-3R 제품 이미지" />
<em>38g의 가는 메탈 밴드와 각진 힌지 구조까지 원형의 실루엣을 유지했습니다 (출처: Sony)</em></p>

<hr />

<h2 id="3-23mm-오픈형-실제로-어떤-소리인가">3. 23mm 오픈형, 실제로 어떤 소리인가</h2>

<p>숫자만 보면 23mm는 요즘 무선 이어폰의 10~11mm 드라이버보다 큽니다. 하지만 <strong>크기가 소리의 질을 결정하지는 않습니다.</strong> 온이어 오픈형이라는 구조 자체가 결과를 크게 좌우합니다.</p>

<p><strong>① 공간감은 유리하고, 저음은 불리합니다.</strong>
귀를 완전히 막지 않으니 무대가 넓게 느껴지고 보컬이 답답하지 않습니다. 대신 밀폐형처럼 귀를 압박해 저음을 밀어넣는 구조가 아니라서, <strong>웅장한 저역이 필요한 장르에서는 힘이 빠져 보일 수 있습니다.</strong> 소니도 저역을 보강했다고는 하지만, 물리적으로 밀폐형과 같은 양감을 내기는 어렵습니다.</p>

<p><strong>② 소리가 밖으로 샙니다.</strong>
오픈형의 숙명입니다. 소니는 누음이 “심하지는 않다”는 입장이지만, <strong>조용한 사무실이나 도서관, 만원 지하철</strong>에서는 옆 사람이 들을 수 있습니다. 반대로 <strong>주변 소리가 그대로 들려오기</strong> 때문에 길을 걸으면서 음악을 들을 때는 오히려 안전한 면이 있습니다.</p>

<p><strong>③ 38g은 확실한 강점입니다.</strong>
무선 온이어 헤드폰이 보통 150~250g인 것과 비교하면 <strong>4분의 1 수준</strong>입니다. 안경을 쓰거나 머리카락이 많아 정수리 압박이 신경 쓰이는 경우, 이 무게 차이는 오래 쓸수록 크게 체감됩니다. 다만 밴드가 얇은 만큼 <strong>머리 크기에 따라 압박 위치가 달라질 수 있습니다.</strong></p>

<p><img src="/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/sony-mdr-3r-detail.jpg" alt="소니 MDR-3R 디테일" />
<em>이어컵 안쪽의 사운드 홀 구조. 원형처럼 귀를 덮지 않는 오픈형 방식입니다 (출처: Sony)</em></p>

<hr />

<h2 id="4-usb-c-유선-vs-35mm-유선-vs-무선-무엇이-다른가">4. USB-C 유선 vs 3.5mm 유선 vs 무선, 무엇이 다른가</h2>

<p>“요즘 무선 쓰는데 굳이 유선?”이라는 질문이 가장 많이 나옵니다. 세 방식의 차이를 실사용 기준으로 정리하면 이렇습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">구분</th>
      <th style="text-align: left">MDR-3R (USB-C 유선)</th>
      <th style="text-align: left">3.5mm 유선</th>
      <th style="text-align: left">무선 (블루투스)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">충전</td>
      <td style="text-align: left">불필요</td>
      <td style="text-align: left">불필요</td>
      <td style="text-align: left">필요 (기기별 5~40시간)</td>
    </tr>
    <tr>
      <td style="text-align: left">페어링</td>
      <td style="text-align: left">불필요</td>
      <td style="text-align: left">불필요</td>
      <td style="text-align: left">최초 1회 필요</td>
    </tr>
    <tr>
      <td style="text-align: left">지연</td>
      <td style="text-align: left">없음</td>
      <td style="text-align: left">없음</td>
      <td style="text-align: left">코덱·기기별 편차</td>
    </tr>
    <tr>
      <td style="text-align: left">음질 상한</td>
      <td style="text-align: left">케이블·기기 DAC에 좌우</td>
      <td style="text-align: left">케이블·기기 DAC에 좌우</td>
      <td style="text-align: left">코덱 대역폭에 좌우</td>
    </tr>
    <tr>
      <td style="text-align: left">호환</td>
      <td style="text-align: left">USB-C 단자 기기</td>
      <td style="text-align: left">3.5mm 단자 기기</td>
      <td style="text-align: left">블루투스 기기</td>
    </tr>
    <tr>
      <td style="text-align: left">이동 중 편의</td>
      <td style="text-align: left">케이블 있음</td>
      <td style="text-align: left">케이블 있음</td>
      <td style="text-align: left">가장 편함</td>
    </tr>
    <tr>
      <td style="text-align: left">노이즈캔슬링</td>
      <td style="text-align: left">없음</td>
      <td style="text-align: left">없음</td>
      <td style="text-align: left">기기별 지원</td>
    </tr>
  </tbody>
</table>

<h3 id="usb-c-유선의-장점">USB-C 유선의 장점</h3>
<ul>
  <li><strong>충전을 신경 쓰지 않습니다.</strong> 아침에 배터리 확인할 일이 없습니다.</li>
  <li><strong>페어링이 없습니다.</strong> 꽂으면 바로 소리가 납니다.</li>
  <li><strong>지연이 사실상 없습니다.</strong> 영상 편집, 리듬 게임, 악기 모니터링처럼 타이밍이 중요한 작업에서 유리합니다.</li>
</ul>

<h3 id="usb-c-유선의-제약">USB-C 유선의 제약</h3>
<ul>
  <li><strong>3.5mm 단자 기기에는 못 씁니다.</strong> 데스크톱 PC의 오디오 잭, 일부 카메라, 구형 MP3 플레이어, 항공기 좌석 오디오에는 그대로 꽂을 수 없습니다. 별도 USB-C 오디오 출력이 있는 기기여야 합니다.</li>
  <li><strong>라이트닝 단자 아이폰에는 직결되지 않습니다.</strong> USB-C로 바뀐 아이폰 15 이후 모델부터 바로 쓸 수 있습니다.</li>
  <li><strong>USB-C 포트가 하나뿐인 노트북</strong>에서는 충전과 동시에 쓰기 어렵습니다.</li>
</ul>

<p>한 가지 더 짚으면, USB-C 유선 헤드폰은 <strong>기기 쪽 오디오 출력 방식에 영향을 받습니다.</strong> 같은 제품이라도 연결한 스마트폰·노트북에 따라 음량 상한과 음색이 달라질 수 있어서, 매장에서 자신의 기기로 들어보는 편이 안전합니다.</p>

<hr />

<h2 id="5-스트레인저-싱스-에디션과-가격">5. 스트레인저 싱스 에디션과 가격</h2>

<p>소니는 일반판과 별도로 <strong>스트레인저 싱스 리미티드 에디션</strong>도 내놓습니다. 블랙 밴드에 로고를 각인하고, 이어패드를 레드·블랙 조합으로 바꾼 모델입니다. 드라마 속 캐릭터와 ‘업사이드 다운’ 분위기에서 착안했다는 설명입니다.</p>

<p>가격은 다음과 같습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">모델</th>
      <th style="text-align: left">국내 가격</th>
      <th style="text-align: left">해외 가격</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">MDR-3R 일반판</td>
      <td style="text-align: left">8만 9,000원</td>
      <td style="text-align: left">60달러 / 59유로 / 49파운드 / 89.95호주달러</td>
    </tr>
    <tr>
      <td style="text-align: left">MDR-3R 스트레인저 싱스 에디션</td>
      <td style="text-align: left">국내 출시 미정</td>
      <td style="text-align: left">80달러 / 69유로 / 59파운드 / 99.95호주달러</td>
    </tr>
  </tbody>
</table>

<p>일반판과 에디션의 차이는 <strong>색상과 각인뿐</strong>이고, 드라이버·구조·케이블은 같습니다. 국내에서는 일반판이 먼저 풀리고, 에디션은 추후 결정될 가능성이 큽니다. 해외 직구를 고려한다면 배송비와 관부가세를 포함해 계산해야 합니다. 8만 원대 제품은 <strong>미국 200달러 면세 한도</strong> 안에 들어가지만, 유럽발 구매는 부가세가 붙을 수 있습니다.</p>

<p><img src="/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/sony-mdr-3r-edition.jpg" alt="소니 MDR-3R 컬러 에디션" />
<em>이어패드를 교체해 색을 바꿀 수 있고, 스트레인저 싱스 에디션은 블랙·레드 조합으로 나옵니다 (출처: Sony)</em></p>

<hr />

<h2 id="6-이런-경우-추천-이런-경우-비추천">6. 이런 경우 추천, 이런 경우 비추천</h2>

<h3 id="추천하는-경우">추천하는 경우</h3>
<ul>
  <li><strong>무선 이어폰 배터리와 분실에 지친 경우</strong> — 충전·페어링이 없는 유선은 관리 포인트가 거의 없습니다.</li>
  <li><strong>영상 편집·게임·악기 연주처럼 지연이 민감한 작업</strong> — 유선의 가장 확실한 장점입니다.</li>
  <li><strong>온이어 착용이 편한 경우</strong> — 커널형 이어폰이 귀에 안 맞거나, 오래 끼면 아픈 사람에게 38g 온이어는 부담이 적습니다.</li>
  <li><strong>레트로 디자인을 좋아하는 경우</strong> — 이 제품의 절반은 디자인 값입니다. 그 감성이 값어치 있다면 8만 9,000원은 합리적입니다.</li>
</ul>

<h3 id="비추천하는-경우">비추천하는 경우</h3>
<ul>
  <li><strong>출퇴근 지하철·비행기에서 음악에 집중하고 싶은 경우</strong> — 노이즈캔슬링이 없고 오픈형이라 주변 소리가 그대로 들어옵니다.</li>
  <li><strong>저음 위주의 음악을 크게 듣는 경우</strong> — 밀폐형 무선 헤드폰과 비교하면 양감이 부족합니다.</li>
  <li><strong>통화 품질이 중요한 경우</strong> — 마이크가 있지만 케이블형 온이어의 통화 성능은 무선 이어폰의 빔포밍 마이크와 다릅니다. 조용한 실내 통화 정도로 기대하는 편이 맞습니다.</li>
  <li><strong>USB-C 오디오 출력이 없는 기기만 쓰는 경우</strong> — 3.5mm 잭밖에 없는 환경이라면 어댑터가 필요합니다.</li>
</ul>

<hr />

<h2 id="7-솔직히-아쉬운-점">7. 솔직히 아쉬운 점</h2>

<p><strong>① 3.5mm 단자가 아예 없다.</strong>
복각 제품이라면 오히려 3.5mm가 어울립니다. USB-C만 지원하면서 <strong>“유선의 보편성”</strong> 이라는 장점을 일부 포기한 셈입니다. USB-Cto 3.5mm 젠더를 물리면 되지만, 그 순간 케이블이 하나 더 늘어납니다.</p>

<p><strong>② 오픈형은 장소를 가린다.</strong>
소니가 “누음이 심하지 않다”고 해도, 실제로는 <strong>조용한 환경에서 옆 사람이 들을 수 있는 수준</strong>입니다. 카페·도서관·야간 기차에서는 볼륨을 낮추게 됩니다.</p>

<p><strong>③ 노이즈캔슬링 부재는 가격으로 납득해야 한다.</strong>
8만 9,000원에 ANC를 기대하는 건 무리입니다. 다만 같은 가격대의 무선 이어폰에는 ANC가 들어가는 경우가 많아서, <strong>“무선 + ANC + 충전”을 원한다면 이 제품은 답이 아닙니다.</strong></p>

<p><strong>④ 이어패드 교체는 되지만 소모품이다.</strong>
폼 패드는 시간이 지나면 눌리고 땀이 배기 쉽습니다. 교체용 패드를 별도로 구할 수 있는지는 국내 출시 시점에 확인이 필요합니다. 2세트가 기본 포함된 건 이 부분을 고려한 구성으로 보입니다.</p>

<hr />

<h2 id="8-총평--8만-9천-원에-감성과-무충전을-함께-사는-선택">8. 총평 — 8만 9천 원에 ‘감성’과 ‘무충전’을 함께 사는 선택</h2>

<p>MDR-3R은 성능으로 승부하는 제품이 아닙니다. <strong>1979년의 디자인을 지금 신발에 맞게 다시 깔아놓은 제품</strong>이고, 그 대가로 <strong>충전·페어링·배터리 걱정이 없는 유선</strong>이라는 실용성을 얻습니다.</p>

<p>정리하면 이렇습니다.</p>

<ul>
  <li><strong>디자인과 감성, 무충전 편의</strong>를 8만 원대로 사고 싶다 → 만족도가 높은 선택</li>
  <li><strong>노이즈캔슬링, 저음, 통화 품질</strong>이 중요하다 → 다른 제품을 봐야 함</li>
  <li><strong>3.5mm 기기와 함께 쓰고 싶다</strong> → 어댑터 필요, 또는 다른 유선 모델 검토</li>
</ul>

<p>가성비 좋은 유선 헤드폰을 찾으면서 <strong>“무선 이어폰은 질렸다”</strong> 는 생각이 드는 분들께 추천할 만합니다. 반대로 매일 만원 지하철에서 음악에 파묻히고 싶은 분들께는 권하지 않습니다.</p>

<hr />

<h2 id="자주-묻는-질문">자주 묻는 질문</h2>

<p><strong>Q. 아이폰에서 바로 쓸 수 있나요?</strong>
USB-C 단자가 있는 아이폰 15 이후 모델은 바로 쓸 수 있습니다. 라이트닝 단자 모델은 별도 어댑터가 필요합니다.</p>

<p><strong>Q. 블루투스도 되나요?</strong>
되지 않습니다. 순수 유선 제품입니다. 충전과 페어링이 없다는 뜻이기도 합니다.</p>

<p><strong>Q. 소리는 무선 헤드폰보다 좋은가요?</strong>
같은 가격대의 무선 제품과 비교하면 유리한 부분이 있지만, 절대적인 음질은 착용 상태와 연결 기기에 크게 좌우됩니다. 오픈형 특성상 저음은 밀폐형보다 적습니다.</p>

<p><strong>Q. 이어패드는 어떻게 교체하나요?</strong>
블루와 오렌지 두 세트가 기본 제공되고, 취향에 따라 바꿔 끼우는 방식입니다. 패키지와 설명서도 원형 디자인을 따랐습니다.</p>

<p><strong>Q. 국내 출시일은?</strong>
소니코리아가 2026년 11월 6일 출시를 발표했고, 가격은 8만 9,000원입니다. 스트레인저 싱스 에디션의 국내 출시 여부는 아직 공지되지 않았습니다.</p>

<hr />

<p><em>참고: 소니코리아 보도자료(2026.11.6), Sony 공식 제품 정보, What Hi-Fi?(2026.11.5), 디지털데일리·머니투데이 보도</em></p>]]></content><author><name>40대 블로거</name></author><category term="products" /><category term="소니MDR-3R" /><category term="MDR-3R" /><category term="소니워크맨헤드폰" /><category term="워크맨" /><category term="TPS-L2" /><category term="유선헤드폰추천" /><category term="USBC헤드폰" /><category term="오픈형헤드폰" /><category term="온이어헤드폰" /><category term="스트레인저싱스에디션" /><category term="소니코리아" /><category term="유선오디오" /><category term="제품비교" /><category term="구매가이드" /><category term="2026년11월" /><summary type="html"><![CDATA[소니가 1979년 워크맨 TPS-L2와 함께 나온 MDR-3를 USB-C 유선 헤드폰 MDR-3R로 되살렸습니다. 23mm 드라이버와 38g 오픈형 구조, 인라인 리모컨·마이크, 블루·오렌지 이어패드 2세트가 특징입니다. 소니코리아 가격은 8만 9,000원이고, 해외 가격은 60달러·49파운드입니다. 무선 노이즈캔슬링 이어폰과 무엇이 다르고 어떤 사람에게 맞는지, 아쉬운 점까지 정리했습니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/sony-mdr-3r-hero.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/sony-mdr-3r-usbc-walkman-headphones-20261107/sony-mdr-3r-hero.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">오픈클로(OpenClaw) 모델 카탈로그 전면 개편 — 이제 업데이트 없이 새 모델을 당일 쓴다 (11/6)</title><link href="https://jackeychan0511.github.io/2026/11/07/openclaw-model-catalog-hot-swap-20261107/" rel="alternate" type="text/html" title="오픈클로(OpenClaw) 모델 카탈로그 전면 개편 — 이제 업데이트 없이 새 모델을 당일 쓴다 (11/6)" /><published>2026-11-07T09:50:00+09:00</published><updated>2026-11-07T09:50:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/07/openclaw-model-catalog-hot-swap-20261107</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/07/openclaw-model-catalog-hot-swap-20261107/"><![CDATA[<p><img src="/assets/images/posts/openclaw-model-catalog-hot-swap-20261107/openclaw-catalog-hero.jpg" alt="OpenClaw 모델 카탈로그 개편 대표 이미지" />
<em>OpenClaw 공식 블로그 ‘Use new models in OpenClaw without an update’ 대표 이미지. (출처: openclaw.ai/blog)</em></p>

<blockquote>
  <p><strong>📌 한줄 요약:</strong> 2026년 11월 6일, OpenClaw가 <strong>모델 탐색(model discovery) 구조를 통째로 갈아엎었습니다.</strong> 이제 모델 목록은 ① 호스팅 카탈로그(4시간마다 재빌드), ② 프로바이더 계정이 알려주는 목록, ③ PATH에 설치된 Codex와의 실제 핸드셰이크 — 세 갈래에서 들어옵니다. 핵심은 <strong>새 모델이 나와도 OpenClaw 릴리스를 기다리지 않는다</strong>는 것. 기본 모델 전환은 68~142초에서 <strong>0.6~1.4초</strong>로 줄었고, 카탈로그 교체 중에도 목록이 599개에서 54개로 뚝 떨어지던 현상은 사라졌습니다.</p>
</blockquote>

<hr />

<h2 id="이런-분들이라면-체감이-큰-변경입니다">이런 분들이라면 체감이 큰 변경입니다</h2>

<p>AI 에이전트를 실사용하면서 모델을 자주 바꿔 끼우는 쪽이라면, 최근 몇 달간 이런 답답함을 한 번쯤 겪었을 겁니다.</p>

<ul>
  <li>새 모델이 발표됐는데 내 OpenClaw 모델 선택창에는 안 보인다</li>
  <li>보이는 모델을 고르면 첫 응답에서 <code class="language-plaintext highlighter-rouge">Unknown model</code> 또는 <code class="language-plaintext highlighter-rouge">unsupported_api_for_model</code>이 뜬다</li>
  <li>모델을 하나 바꿀 때마다 선택창이 몇 초씩 멈춘다</li>
  <li>목록을 새로고침했더니 오히려 모델이 줄어든다</li>
</ul>

<p>자동화 파이프라인을 운영하는 입장에서는 이게 단순 불편이 아닙니다. <strong>모델 교체가 곧 비용·품질·속도 튜닝</strong>인데, 그 튜닝 창구가 릴리스 주기에 묶여 있으면 실험이 밀립니다. 11월 6일 공식 블로그에 올라온 개편 글은 정확히 이 지점을 다룹니다.</p>

<hr />

<h2 id="왜-갑자기-이걸-뜯어고쳤나">왜 갑자기 이걸 뜯어고쳤나</h2>

<p>공식 글은 솔직한 고백으로 시작합니다. OpenAI가 <strong>GPT-6.1 Sol</strong>을 출시했을 때, ChatGPT 로그인으로 OpenClaw를 쓰는 사용자들은 그 모델을 선택할 수 없었습니다. OpenClaw에는 Codex 0.158.0이 번들되어 있었는데, ChatGPT는 Codex <strong>0.159.2 이상</strong>에게만 Sol을 노출했습니다. 그 숫자를 바꾸는 유일한 방법이 “OpenClaw 릴리스”였던 겁니다.</p>

<blockquote>
  <p>“Launch day is when people most want to try a model, and we were the reason they had to wait.”
(출시일은 사람들이 가장 그 모델을 써보고 싶어 하는 날인데, 기다리게 만든 쪽이 우리였다.)</p>
</blockquote>

<p>그래서 약 5주, 대략 80개의 PR로 모델 목록을 가져오는 방식을 다시 지었습니다. 이번 글은 그 결과물에 대한 기술 회고이자, 운영자 입장에서 읽어야 할 변경 공지입니다.</p>

<hr />

<h2 id="바뀐-구조--4시간마다-스스로-갱신되는-카탈로그">바뀐 구조 ①: 4시간마다 스스로 갱신되는 카탈로그</h2>

<p>예전에는 프로바이더 플러그인마다 모델 목록이 <strong>매니페스트 파일</strong>로 들어 있었고, 그 파일은 OpenClaw 패키지에 함께 배포됐습니다. 플러그인은 릴리스에 묶여 있으니, 모델 추가는 곧 릴리스였습니다.</p>

<p>이제 OpenClaw는 <code class="language-plaintext highlighter-rouge">catalog.openclaw.ai</code>에 호스팅된 모델 카탈로그를 봅니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">항목</th>
      <th style="text-align: left">내용</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">재빌드 주기</td>
      <td style="text-align: left">4시간마다</td>
    </tr>
    <tr>
      <td style="text-align: left">데이터 소스</td>
      <td style="text-align: left">models.dev + OpenClaw 자체 매니페스트 + 가격 피드 + 프로바이더 모델 목록</td>
    </tr>
    <tr>
      <td style="text-align: left">수록 규모</td>
      <td style="text-align: left">현재 약 1,000개 모델</td>
    </tr>
    <tr>
      <td style="text-align: left">반영 방식</td>
      <td style="text-align: left">실행 중인 게이트웨이가 백그라운드에서 새 카탈로그를 확인하고 <strong>라이브로 교체</strong></td>
    </tr>
  </tbody>
</table>

<p>여기서 실무적으로 중요한 디테일이 두 가지 있습니다.</p>

<p>첫째, <strong>진행 중인 턴은 시작할 때의 카탈로그로 끝납니다.</strong> 새 턴부터 새 카탈로그를 씁니다. 그래서 한 응답 안에서 모델 목록과 가격이 서로 어긋나는 일이 생기지 않습니다. 비용 집계를 하는 자동화라면 이건 꽤 중요한 보장입니다.</p>

<p>둘째, <strong>폐기된 모델은 카탈로그에서 제거됩니다.</strong> 글에서는 NVIDIA가 API에서 2개 모델 서비스를 중단했는데 카탈로그에 계속 남아 있던 사례를 듭니다. 편리함의 이면이기도 합니다. 오래 돌던 자동화가 어느 날 조용히 없는 모델을 가리키게 될 수 있으니, 폴백 모델은 반드시 지정해 두는 편이 안전합니다.</p>

<p><img src="/assets/images/posts/openclaw-model-catalog-hot-swap-20261107/openclaw-catalog-pipeline.png" alt="카탈로그 파이프라인 도식" />
<em>models.dev, 플러그인 매니페스트, 가격 피드, 프로바이더 목록이 호스팅 카탈로그를 거쳐 실행 중인 게이트웨이까지 도달하는 구조. (출처: openclaw.ai/blog)</em></p>

<hr />

<h2 id="바뀐-구조--내-계정에-있으면-고를-수-있다">바뀐 구조 ②: “내 계정에 있으면 고를 수 있다”</h2>

<p>카탈로그는 <strong>세상에 존재하는 모델</strong>을 압니다. 계정은 <strong>내가 쓸 수 있는 모델</strong>을 압니다. 이 둘은 다릅니다. 그래서 OpenClaw는 프로바이더 로그인 시 해당 계정의 모델 목록을 직접 물어보고, 설치 버전보다 새로운 모델이나 계정 전용 모델까지 선택창에 올립니다.</p>

<p>공식 글이 정리한 전후 비교는 이렇습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">프로바이더</th>
      <th style="text-align: left">이전</th>
      <th style="text-align: left">이후</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">OpenAI API 키</td>
      <td style="text-align: left">계정에 있는 <code class="language-plaintext highlighter-rouge">gpt-5.2</code>가 <code class="language-plaintext highlighter-rouge">Unknown model</code></td>
      <td style="text-align: left">계정 목록의 채팅 모델이 표시되고 실행됨</td>
    </tr>
    <tr>
      <td style="text-align: left">Anthropic API 키</td>
      <td style="text-align: left">새 Claude 모델은 릴리스 전까지 숨김</td>
      <td style="text-align: left">Anthropic 목록에 뜨는 즉시 표시</td>
    </tr>
    <tr>
      <td style="text-align: left">Claude Code</td>
      <td style="text-align: left">OpenClaw가 관리하던 고정 목록</td>
      <td style="text-align: left">계정에 대해 Claude Code가 보고하는 메뉴</td>
    </tr>
    <tr>
      <td style="text-align: left">GitHub Copilot</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">kimi-k3</code>가 첫 턴에서 <code class="language-plaintext highlighter-rouge">unsupported_api_for_model</code></td>
      <td style="text-align: left">모델별로 허용되는 엔드포인트를 읽어 맞춰 호출</td>
    </tr>
    <tr>
      <td style="text-align: left">Grok 구독</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">grok-4.7-build-fast</code>의 사고 수준이 off/ultra 2단계</td>
      <td style="text-align: left">목록대로 low/medium/high/xhigh 4단계</td>
    </tr>
    <tr>
      <td style="text-align: left">Ollama</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">ollama pull</code> 해도 목록에 안 뜸</td>
      <td style="text-align: left">다음 새로고침에 표시</td>
    </tr>
    <tr>
      <td style="text-align: left">OpenCode Go</td>
      <td style="text-align: left">계정이 서빙하는 4개 모델 누락</td>
      <td style="text-align: left">목록의 모든 모델 표시</td>
    </tr>
  </tbody>
</table>

<p>여기서 절반은 “모델 이름”이 아니라 <strong>“모델이 무엇을 할 수 있는지”</strong>를 읽는 작업이었습니다. 예전에는 사고 수준(thinking level)과 요청 형식을 모델 이름으로 추측했습니다. 한 번도 본 적 없는 새 모델에서는 이 추측이 곧바로 실패합니다. 이제는 프로바이더가 목록에 실어 보내는 정보를 그대로 씁니다.</p>

<hr />

<h2 id="바뀐-구조--codex-버전-문제-그리고-되돌린-첫-시도">바뀐 구조 ③: Codex 버전 문제, 그리고 되돌린 첫 시도</h2>

<p>이 대목이 이번 글에서 가장 값진 부분입니다. 실패를 숨기지 않았습니다.</p>

<p>ChatGPT는 클라이언트가 보고하는 Codex 버전을 보고 어떤 모델을 제공할지 정합니다. 버전이 낮으면 목록이 짧아집니다. 첫 시도는 단순했습니다. npm에서 최신 Codex 버전을 받아 그 숫자를 보고하면 되지 않는다는 발상이었고, 실제로 Sol이 선택창에 나타났습니다.</p>

<p>문제는 그다음이었습니다. <strong>목록 요청은 0.161.0이라고 말하는데, 턴은 여전히 번들된 0.160.0에서 돌았습니다.</strong> 그 바이너리는 요청마다 자기 버전을 보고합니다. 결과는 선택창에서 고른 모델이 첫 메시지에서 HTTP 400으로 실패하는 것이었습니다.</p>

<blockquote>
  <p>“We had moved the failure from the picker to the first message, which is worse.”
(실패를 선택창에서 첫 메시지로 옮겼을 뿐이고, 그게 더 나쁘다.)</p>
</blockquote>

<p>그래서 되돌렸고, 지금은 이렇게 동작합니다.</p>

<ol>
  <li><code class="language-plaintext highlighter-rouge">PATH</code>에서 Codex를 찾습니다.</li>
  <li>안정(stable) 릴리스이고, 번들 버전보다 새롭고, 같은 메이저 버전이면 <strong>실제 핸드셰이크</strong>를 합니다.</li>
  <li>핸드셰이크가 통과하면 <strong>목록을 가져오는 바이너리와 턴을 실행하는 바이너리가 동일</strong>해집니다.</li>
  <li>하나라도 실패하면 조용히 번들 Codex로 폴백합니다.</li>
  <li>OpenClaw가 임의로 무엇인가를 설치하지는 않습니다.</li>
</ol>

<p>테스트 로그는 이런 모양입니다.</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>[agent/embedded] Codex app-server: using installed ~/.local/bin/codex 0.162.1 (newer than bundled 0.161.0)
</code></pre></div></div>

<p>요지는 <strong>“모델을 나열하는 버전과 실행하는 버전이 같아야 한다”</strong>는 원칙입니다. 자동화를 운영하며 새 모델을 급히 붙이다 보면 놓치기 쉬운, 그러나 한 번 물리면 원인 찾기 어려운 종류의 버그입니다.</p>

<hr />

<h2 id="숫자로-보는-체감-차이">숫자로 보는 체감 차이</h2>

<p>공식 글이 제시한 전후 수치입니다. 이쪽이 아마 가장 와닿을 겁니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">상황</th>
      <th style="text-align: left">이전</th>
      <th style="text-align: left">이후</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">OpenRouter가 한 번 타임아웃</td>
      <td style="text-align: left">466개 → 3개, 수동 새로고침 전까지 유지</td>
      <td style="text-align: left">30초 후 재시도, 최대 30분까지 백오프</td>
    </tr>
    <tr>
      <td style="text-align: left">게이트웨이가 카탈로그 교체</td>
      <td style="text-align: left">599개 → 54개, 최대 4분간</td>
      <td style="text-align: left">교체 중에도 599개 유지</td>
    </tr>
    <tr>
      <td style="text-align: left">기본 모델 변경</td>
      <td style="text-align: left">68~142초 (대형 플러그인 재로드로 게이트웨이 정지)</td>
      <td style="text-align: left">0.6~1.4초 (이미 로드된 플러그인 재사용)</td>
    </tr>
    <tr>
      <td style="text-align: left">모델 선택창 열기</td>
      <td style="text-align: left">최대 5초 대기</td>
      <td style="text-align: left">즉시 열리고 나머지는 백그라운드로 채움</td>
    </tr>
  </tbody>
</table>

<p>솔직히 “기본 모델 변경에 1~2분”은 자주 겪는 사람에게는 꽤 큰 마찰입니다. 모델을 A/B로 바꿔가며 프롬프트를 튜닝하는 작업이라면, 그 1분이 실험 횟수를 직접 깎아먹으니까요. 0.6~1.4초는 체감상 “즉시”에 가깝습니다.</p>

<hr />

<h2 id="1000개-모델은-오히려-독이다">1,000개 모델은 오히려 독이다</h2>

<p>목록이 다 보이면 길어집니다. OpenRouter 하나만 466개입니다. 그래서 카탈로그는 프로바이더별 <strong>추천 목록</strong>을 함께 싣고, 선택창은 추천을 먼저 보여줍니다. 추천 목록은 매일 수동으로 큐레이션되며, 자체 경험과 여러 벤치마크를 섞어 만든다고 합니다. 검색은 여전히 전체 모델을 대상으로 합니다.</p>

<p>OpenAI 그룹을 예로 들면, 현재 사용 중인 모델이 맨 앞, 그다음 추천 2개, 나머지 33개는 한 줄 뒤에 접혀 있습니다.</p>

<p><img src="/assets/images/posts/openclaw-model-catalog-hot-swap-20261107/openclaw-model-picker.png" alt="OpenClaw 채팅 모델 선택창 스크린샷" />
<em>실행 중인 게이트웨이에서 캡처한 OpenClaw 채팅 모델 선택창. (출처: openclaw.ai/blog)</em></p>

<p>편해진 대신 판단이 하나 늘었습니다. <strong>“추천”은 OpenClaw 팀의 취향과 벤치마크가 반영된 값</strong>입니다. 내 자동화의 작업 특성(예: 긴 문서 요약, 코드 패치, 다국어 분류)과 반드시 일치하지는 않습니다. 추천은 출발점으로만 쓰고, 실제 품질은 자체 평가셋으로 확인하는 편이 낫습니다.</p>

<hr />

<h2 id="공식-글이-뽑은-4가지-교훈">공식 글이 뽑은 4가지 교훈</h2>

<ol>
  <li><strong>모델을 나열하는 버전이 그 모델을 실행해야 한다.</strong> 보고하는 버전과 실행 버전이 다르면 실패는 선택창에서 첫 메시지로 옮겨갈 뿐이다.</li>
  <li><strong>능력은 이름이 아니라 목록에서 읽어라.</strong> 사고 수준과 엔드포인트는 프로바이더 목록에 이미 적혀 있다. 이름 기반 규칙은 처음 보는 모델에서 깨진다.</li>
  <li><strong>마지막 정상 목록을 지켜라.</strong> 새로고침 실패나 카탈로그 교체가 선택창의 모델 수를 줄여서는 안 된다.</li>
  <li><strong>한 소스가 깨져도 나머지는 살아 있어야 한다.</strong> 9월 21일 models.dev가 <code class="language-plaintext highlighter-rouge">kimi-for-coding</code> 항목을 둘로 쪼갰을 때, 퍼블리셔가 “프로바이더 하나 누락”을 치명적 오류로 처리해 <strong>모든 실행이 실패</strong>했고 그 기간 GPT-6 Sol과 Luna가 기존 설치에 도달하지 못했습니다. 지금은 경고만 남기고 해당 프로바이더만 신선한 데이터를 못 받습니다.</li>
</ol>

<p>3번과 4번은 OpenClaw만의 이야기가 아닙니다. 외부 API 목록을 받아 UI에 뿌리는 자동화를 만든다면 그대로 적용되는 원칙입니다.</p>

<hr />

<h2 id="아직-릴리스가-필요한-경우-한계">아직 릴리스가 필요한 경우 (한계)</h2>

<p>과장 없이 정리하면 이렇습니다.</p>

<ul>
  <li><strong>PATH에 더 새로운 Codex가 없으면</strong>, 여전히 번들 버전이 ChatGPT 모델 목록을 결정합니다.</li>
  <li><strong>카탈로그보다 새로운 모델은 가격이 없습니다.</strong> 비용이 <code class="language-plaintext highlighter-rouge">unknown</code>으로 표시되고, 카탈로그가 따라잡을 때까지 <strong>보수적인 기본 한도</strong>로 실행됩니다.</li>
  <li>현재 설치가 어디까지 닿는지 확인하려면 <code class="language-plaintext highlighter-rouge">openclaw models list --refresh</code>를 실행하면 됩니다.</li>
  <li>Codex 핸드셰이크가 실패하면 <strong>조용히 번들로 폴백</strong>합니다. 즉 “왜 최신 모델이 안 보이지?”의 답이 로그에만 있을 수 있습니다.</li>
</ul>

<p>세 번째 항목은 배치 작업에서 특히 주의할 지점입니다. 토큰을 많이 쓰는 잡을 새 모델로 돌렸는데 가격이 아직 등록되지 않아 보수적 한도에 걸리면, 실패가 아니라 <strong>성능 저하</strong>로 나타납니다. 원인을 모델 탓으로 오해하기 쉬운 형태입니다.</p>

<hr />

<h2 id="도입-전-체크리스트">도입 전 체크리스트</h2>

<p>자동화 파이프라인을 운영 중이라면, 이번 변경은 아래 순서로 확인하는 걸 권합니다.</p>

<ol>
  <li><code class="language-plaintext highlighter-rouge">openclaw models list --refresh</code> — 현재 설치가 실제로 볼 수 있는 모델 범위 확인</li>
  <li>게이트웨이 로그에서 카탈로그 교체 기록 확인 (재시작 없이 반영되는지)</li>
  <li><code class="language-plaintext highlighter-rouge">which codex</code>, <code class="language-plaintext highlighter-rouge">codex --version</code> — PATH에 예상치 못한 버전이 물려 있지 않은지</li>
  <li>각 자동화 잡에 <strong>폴백 모델</strong> 명시 (폐기 모델 자동 제거 대비)</li>
  <li>가격 미등록 모델은 예산 한도를 별도로 두기</li>
  <li>팀 게이트웨이라면, 모델 변경이 감사 로그에 모델·가격 단위로 남는지 확인</li>
</ol>

<p>3번은 은근히 중요합니다. 개발용·실험용 Codex를 여러 버전 설치해 둔 환경이라면, 핸드셰이크가 통과한 “그 버전”이 실제 턴을 실행합니다. 의도한 버전인지 눈으로 확인하는 편이 좋습니다.</p>

<hr />

<h2 id="정리--이번-변경의-성격">정리 — 이번 변경의 성격</h2>

<p>이번 개편은 새 기능이 붙은 릴리스가 아니라, <strong>모델을 가져오는 경로 자체를 바꾼 인프라 변경</strong>입니다. 눈에 보이는 것은 선택창의 목록 몇 개지만, 실제 효과는 세 가지로 요약됩니다.</p>

<ul>
  <li><strong>시간</strong>: 모델 출시일과 사용 가능일 사이의 지연이 사라짐 (Codex 예외 있음)</li>
  <li><strong>안정성</strong>: 목록이 줄어들거나 선택창이 멈추는 문제 해결, 전환 0.6~1.4초</li>
  <li><strong>일관성</strong>: 목록을 나열한 버전과 실행 버전을 일치시킴</li>
</ul>

<p>반대로 비용 예측과 폐기 모델 대응이라는, 원래는 릴리스가 대신 눌러주던 안전장치가 운영자 몫으로 넘어왔습니다. 모델을 자주 갈아 끼우는 자동화라면 이득이 크고, 한 모델로 오래 고정 운영하는 파이프라인이라면 당장 체감은 작을 수 있습니다.</p>

<p>새 모델을 빠르게 붙여 실험하는 쪽, 여러 프로바이더를 섞어 쓰는 쪽이라면 <strong>지금 바로 <code class="language-plaintext highlighter-rouge">openclaw models list --refresh</code> 한 번 돌려볼 만한 변경</strong>입니다. 가성비 좋은 구성(비싼 모델은 최종 검토에만, 나머지는 저렴한 모델로)을 찾고 있다면 더더욱요.</p>

<hr />

<h3 id="참고">참고</h3>

<ul>
  <li>OpenClaw 공식 블로그 — <em>Use new models in OpenClaw without an update</em> (Ayaan Zaidi, 2026년 11월 6일)</li>
  <li>OpenClaw 공식 문서 — Models / Security / Plugins</li>
  <li>호스팅 카탈로그: <code class="language-plaintext highlighter-rouge">catalog.openclaw.ai</code> (4시간 주기 재빌드)</li>
  <li>확인 명령: <code class="language-plaintext highlighter-rouge">openclaw models list --refresh</code></li>
</ul>]]></content><author><name>40대 블로거</name></author><category term="career" /><category term="OpenClaw" /><category term="오픈클로" /><category term="모델카탈로그" /><category term="ModelCatalog" /><category term="핫스왑" /><category term="Codex" /><category term="모델선택" /><category term="업무자동화" /><category term="AI에이전트" /><category term="오픈소스AI" /><category term="2026년11월" /><summary type="html"><![CDATA[2026년 11월 6일 OpenClaw가 모델 탐색 구조를 전면 개편했습니다. 호스팅 카탈로그(4시간마다 재빌드), 프로바이더 계정의 모델 목록, 설치된 Codex 핸드셰이크라는 세 갈래에서 모델을 읽어오고, 게이트웨이는 재시작 없이 카탈로그를 교체합니다. 기본 모델 전환 68~142초 → 0.6~1.4초, 목록이 줄어들지 않는 구조, 그리고 여전히 릴리스가 필요한 경우까지 정리했습니다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/openclaw-model-catalog-hot-swap-20261107/openclaw-catalog-hero.jpg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/openclaw-model-catalog-hot-swap-20261107/openclaw-catalog-hero.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[2026/11/05 NY마감] 다우 1,833p↓·나스닥 5.52%↓ AI데이터센터 규제 공포</title><link href="https://jackeychan0511.github.io/2026/11/06/ny-stock-market-20261106/" rel="alternate" type="text/html" title="[2026/11/05 NY마감] 다우 1,833p↓·나스닥 5.52%↓ AI데이터센터 규제 공포" /><published>2026-11-06T21:00:00+09:00</published><updated>2026-11-06T21:00:00+09:00</updated><id>https://jackeychan0511.github.io/2026/11/06/ny-stock-market-20261106</id><content type="html" xml:base="https://jackeychan0511.github.io/2026/11/06/ny-stock-market-20261106/"><![CDATA[<p><img src="/assets/images/posts/ny-stock-market-20261106/ny-stock-chart-20261106.svg" alt="뉴욕증시 3대 지수 마감 차트" />
<em>2026년 11월 5일(현지시간) 뉴욕증시 주요 지수 등락률</em></p>

<h2 id="오늘의-증시-요약">오늘의 증시 요약</h2>

<p><strong>11월 5일(현지시간)</strong> 뉴욕증시는 중간선거 랠리를 하루 만에 되돌리며 급락했습니다. 다우존스30산업평균지수는 1,833.06포인트(3.44%) 내린 <strong>5만1,523.06</strong>, S&amp;P500은 334.89포인트(4.36%) 하락한 <strong>7,353.73</strong>, 나스닥종합지수는 1,421.52포인트(5.52%) 빠진 <strong>2만4,315.00</strong>에 마감했습니다. 3대 지수 모두 2025년 4월 관세 쇼크 이후 가장 큰 하루 낙폭입니다.</p>

<p>나스닥은 지난달 고점 대비 10% 넘게 밀리며 조정 국면에 들어섰고, 러셀2000도 4.45% 하락해 조정권에 진입했습니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">지수</th>
      <th style="text-align: left">종가</th>
      <th style="text-align: left">전일비</th>
      <th style="text-align: center">등락률</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">다우존스</td>
      <td style="text-align: left">51,523.06</td>
      <td style="text-align: left">-1,833.06</td>
      <td style="text-align: center">-3.44%</td>
    </tr>
    <tr>
      <td style="text-align: left">S&amp;P500</td>
      <td style="text-align: left">7,353.73</td>
      <td style="text-align: left">-334.89</td>
      <td style="text-align: center">-4.36%</td>
    </tr>
    <tr>
      <td style="text-align: left">나스닥</td>
      <td style="text-align: left">24,315.00</td>
      <td style="text-align: left">-1,421.52</td>
      <td style="text-align: center">-5.52%</td>
    </tr>
    <tr>
      <td style="text-align: left">러셀2000</td>
      <td style="text-align: left">—</td>
      <td style="text-align: left">—</td>
      <td style="text-align: center">-4.45%</td>
    </tr>
    <tr>
      <td style="text-align: left">필라델피아 반도체</td>
      <td style="text-align: left">—</td>
      <td style="text-align: left">—</td>
      <td style="text-align: center">-12.20%</td>
    </tr>
  </tbody>
</table>

<h2 id="방아쇠는-데이터센터-규제">방아쇠는 ‘데이터센터 규제’</h2>

<p>하루 전 시장은 민주당의 상·하원 동시 탈환을 위험 프리미엄 해소로 읽었지만, 하루 만에 해석이 뒤집혔습니다. 당선자들의 데이터센터 건설 중단·유예 공약이 AI 인프라 투자 사이클을 늦출 수 있다는 우려가 매도로 이어졌습니다.</p>

<p>연방 차원의 데이터센터 모라토리엄 제안도 이어졌습니다. 시장조사업체 클린뷰에 따르면 계획된 미국 데이터센터 용량의 약 40%가 건설 유예를 공약한 주에 몰려 있습니다. 전기요금 상승이 정치 쟁점이 된 점도 부담이었습니다.</p>

<h2 id="반도체부터-무너졌다">반도체부터 무너졌다</h2>

<p>필라델피아 반도체지수는 12.2% 급락하며 2020년 3월 이후 최악의 하루를 기록했습니다. 엔비디아 -9.26%, 브로드컴 -10%, 오라클 -7%대에 테슬라 -10.77%, 메타 -3.96%, 아마존 -2.19%, 알파벳 -2.20%로 대형 기술주가 일제히 밀렸습니다.</p>

<p>데이터센터 관련주는 낙폭이 더 컸습니다. 코어위브 -10%, 네비우스 -15%, 아이렌 -17%. 매그니피센트7 시총은 9,000억달러, S&amp;P500 편입 기업은 하루 2조9,000억달러(사상 최대)가 증발했습니다. 캐터필러 -6%, JP모건 -4% 등 경기민감주까지 매도세가 번졌습니다.</p>

<h2 id="안전자산으로-피신">안전자산으로 피신</h2>

<p>국제유가는 반대로 움직였습니다. 탱커 피격으로 공급 불안이 다시 부각되며 WTI 12월물은 2.72% 오른 배럴당 <strong>90.52달러</strong>, 브렌트유는 3달러 이상 오른 <strong>97달러대</strong>에 마감했습니다. 안전자산 선호로 10년물 금리는 6bp 내린 <strong>4.84%</strong>, 금 현물은 온스당 4,087달러 부근에서 강세를 유지했습니다.</p>

<h2 id="한국-증시는-이틀-연속-급락">한국 증시는 이틀 연속 급락</h2>

<p>여파는 아시아로 번졌습니다. 11월 6일 코스피는 6.02% 내린 <strong>5,059.69</strong>, 코스닥은 5.04% 하락했습니다. 코스피에는 서킷브레이커, 코스닥에는 매도 사이드카가 발동됐습니다. SK하이닉스 -10.4%, 삼성전자 -6.4%로 반도체 대형주가 지수를 끌어내렸고, 일본 니케이225도 6% 하락 마감했습니다.</p>

<h2 id="다음-일정과-관전-포인트">다음 일정과 관전 포인트</h2>

<ul>
  <li><strong>11월 6일 밤(한국시간 22:30)</strong>: 미국 10월 고용보고서 — 9월 비농업 고용은 2만9,000명 증가</li>
  <li><strong>11월 18일</strong>: 10월 FOMC 의사록 공개</li>
  <li><strong>12월 8~9일</strong>: FOMC 정례회의(결과 12월 9일) — 현재 기준금리 3.75~4.00%</li>
</ul>

<p>한국시간 6일 저녁 나스닥100 선물은 1.5% 안팎 반등하며 진정 국면을 보이고 있습니다. 다만 이번 하락은 실적이 아닌 정책 변수에서 출발한 만큼, 데이터센터 규제의 실제 속도가 반등의 지속성을 가를 전망입니다.</p>

<p>#뉴욕증시 #다우지수 #S&amp;P500 #나스닥 #FOMC #유가 #반도체 #AI데이터센터 #미국중간선거</p>]]></content><author><name>40대 라이프 블로거</name></author><category term="finance" /><category term="뉴욕증시" /><category term="다우지수" /><category term="S&amp;P500" /><category term="나스닥" /><category term="FOMC" /><category term="유가" /><category term="반도체" /><category term="AI데이터센터" /><summary type="html"><![CDATA[11월 5일(현지시간) 뉴욕증시 급락. 다우 3.44%(-1,833.06p) 51,523.06, S&P500 4.36%↓ 7,353.73, 나스닥 5.52%↓ 24,315.00. 중간선거 이후 데이터센터 규제 우려로 필라델피아 반도체지수 12.2% 폭락, 나스닥은 조정 국면 진입. WTI는 2.72% 오른 90.52달러.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://jackeychan0511.github.io/assets/images/posts/ny-stock-market-20261106/ny-stock-chart-20261106.svg" /><media:content medium="image" url="https://jackeychan0511.github.io/assets/images/posts/ny-stock-market-20261106/ny-stock-chart-20261106.svg" xmlns:media="http://search.yahoo.com/mrss/" /></entry></feed>