
Google Gemini 최신 소식 — '제미나이 4 카본' 전격 발표, 사이버보안·장기 작업 겨냥한 프론티어 모델 (2026.10.29)
 출처: Google 공식 블로그 “Gemini 4 Carbon: our next frontier model” (2026.10.28)
📌 한 줄 요약: 구글이 2026년 10월 28일(미국 현지시간), 새 프론티어 모델 ‘제미나이 4 카본(Gemini 4 Carbon)’ 을 공식 발표했습니다. 인공지능 분석 지수(Artificial Analysis Intelligence Index) v5.0에서 59점으로 1위, 취약점 탐지 SEC-bench Pro 88.2%, 익스플로잇 검증 ExploitGym 54.8%, 패치 작성 CWE-bench 71.0% 를 기록했습니다. 내부적으로는 며칠씩 걸리는 장기 엔지니어링 작업을 포기하지 않고 이어갔다고 밝혔습니다. 다만 이번 주부터 사이버 방어팀 일부에게만 열리고, 개발자·기업·일반 사용자 공개 시점은 “가능한 한 빠르게(as soon as possible)” 라는 표현뿐입니다.
AI 에이전트로 코드 리뷰·보안 점검·반복 업무를 자동화하는 파이프라인을 운영하는 분들이라면, 새 모델 발표 소식이 반갑기만 하지는 않을 겁니다. “또 모델이 바뀌면 프롬프트·평가셋·비용 계산을 다시 해야 하나” 하는 피로감이 먼저 오기 때문입니다. 그런데 이번 제미나이 4 카본은 단순한 버전업이 아니라 구글이 모델의 용도를 ‘사이버보안 방어’로 명확히 좁혀서 내놓은 첫 사례에 가깝습니다. 무엇이 발표됐고, 숫자는 어떤 의미이며, 실무에서는 언제·어떻게 쓸 수 있는지 순서대로 짚어 보겠습니다.
🗞️ 이슈 요약 — 한눈에 보기
- 무엇: 구글이 제미나이 4 카본을 공식 발표했습니다. 구글 딥마인드의 코라이 카북추오글루(Koray Kavukcuoglu) SVP가 직접 글을 올렸습니다
- 포지션: “우리 중 가장 강력한 모델“이자 사이버보안(state-of-the-art cybersecurity) 과 장기 작업(long horizon) 에 특화된 프론티어 모델
- 성능 1위: 최근 개편된 인공지능 분석 지수 v5.0에서 59점으로 1위. 코딩·에이전트 작업에서 “상당한 향상(significant gains)”을 냈다고 밝혔습니다
- 보안 3종 지표: 취약점 탐지 SEC-bench Pro 88.2%, 익스플로잇 검증 ExploitGym 54.8%, 패치 CWE-bench 71.0%
- 웹 개발: WebDev Arena에서 +89 Elo 상승해 4위(1768점). 1위는 아니라는 점을 구글도 명시했습니다
- 전작 대비: 2주 전 나온 제미나이 4 아르곤 위에 쌓았고, 내부 벤치마크에서 보안 코드 생성 성공률이 아르곤의 2배 이상
- 출시 방식: 이번 주부터 사이버 방어팀 일부 → 페어윈드(Fairwind) 프로그램 신뢰 파트너 순차 확대 → 개발자·기업·소비자는 “가능한 한 빠르게”
- 가격: 아르곤과 동일한 도입가 적용. 입력 100만 토큰당 2달러, 출력 10달러, 캐시 입력 95% 할인
🔍 상세 분석 — 무엇이, 왜 중요한가
1) 아르곤 발표 2주 만에 다음 프론티어가 나왔다
구글은 9월 30일 제미나이 4 아르곤을 발표했고, 10월 중순 일반 공개로 넘어갔습니다. 그로부터 약 2주 만에 카본을 내놨습니다. AI 업계에서도 빠른 편이지만, 더 눈에 띄는 건 모델 계보의 연속성입니다. 카본은 완전히 새로운 아키텍처가 아니라 아르곤을 기반으로 특정 능력을 끌어올린 파생 프론티어라는 성격이 강합니다.
구글의 표현을 그대로 옮기면 이렇습니다. “아르곤 위에 쌓았고, 카본은 우리가 프론티어를 얼마나 빠르게 밀어붙이고 있는지를 보여준다.” 같은 계열 안에서 2주 단위로 체크포인트를 올려 공개하는 사이클이 자리 잡았다는 뜻으로 읽힙니다. 실제로 10월 초 카본은 사내 코딩 플랫폼 ‘젯스키’에서 내부 테스트 중이라는 보도가 먼저 나왔고, 이번에 공식 제품으로 확인된 흐름입니다.
2) 숫자로 본 성능 — 어디가 얼마나 올랐나
구글이 공개한 외부 벤치마크는 세 가지입니다. 셋 다 “보안 담당자의 일”을 쪼갠 것이라 서로 다른 걸 측정합니다.
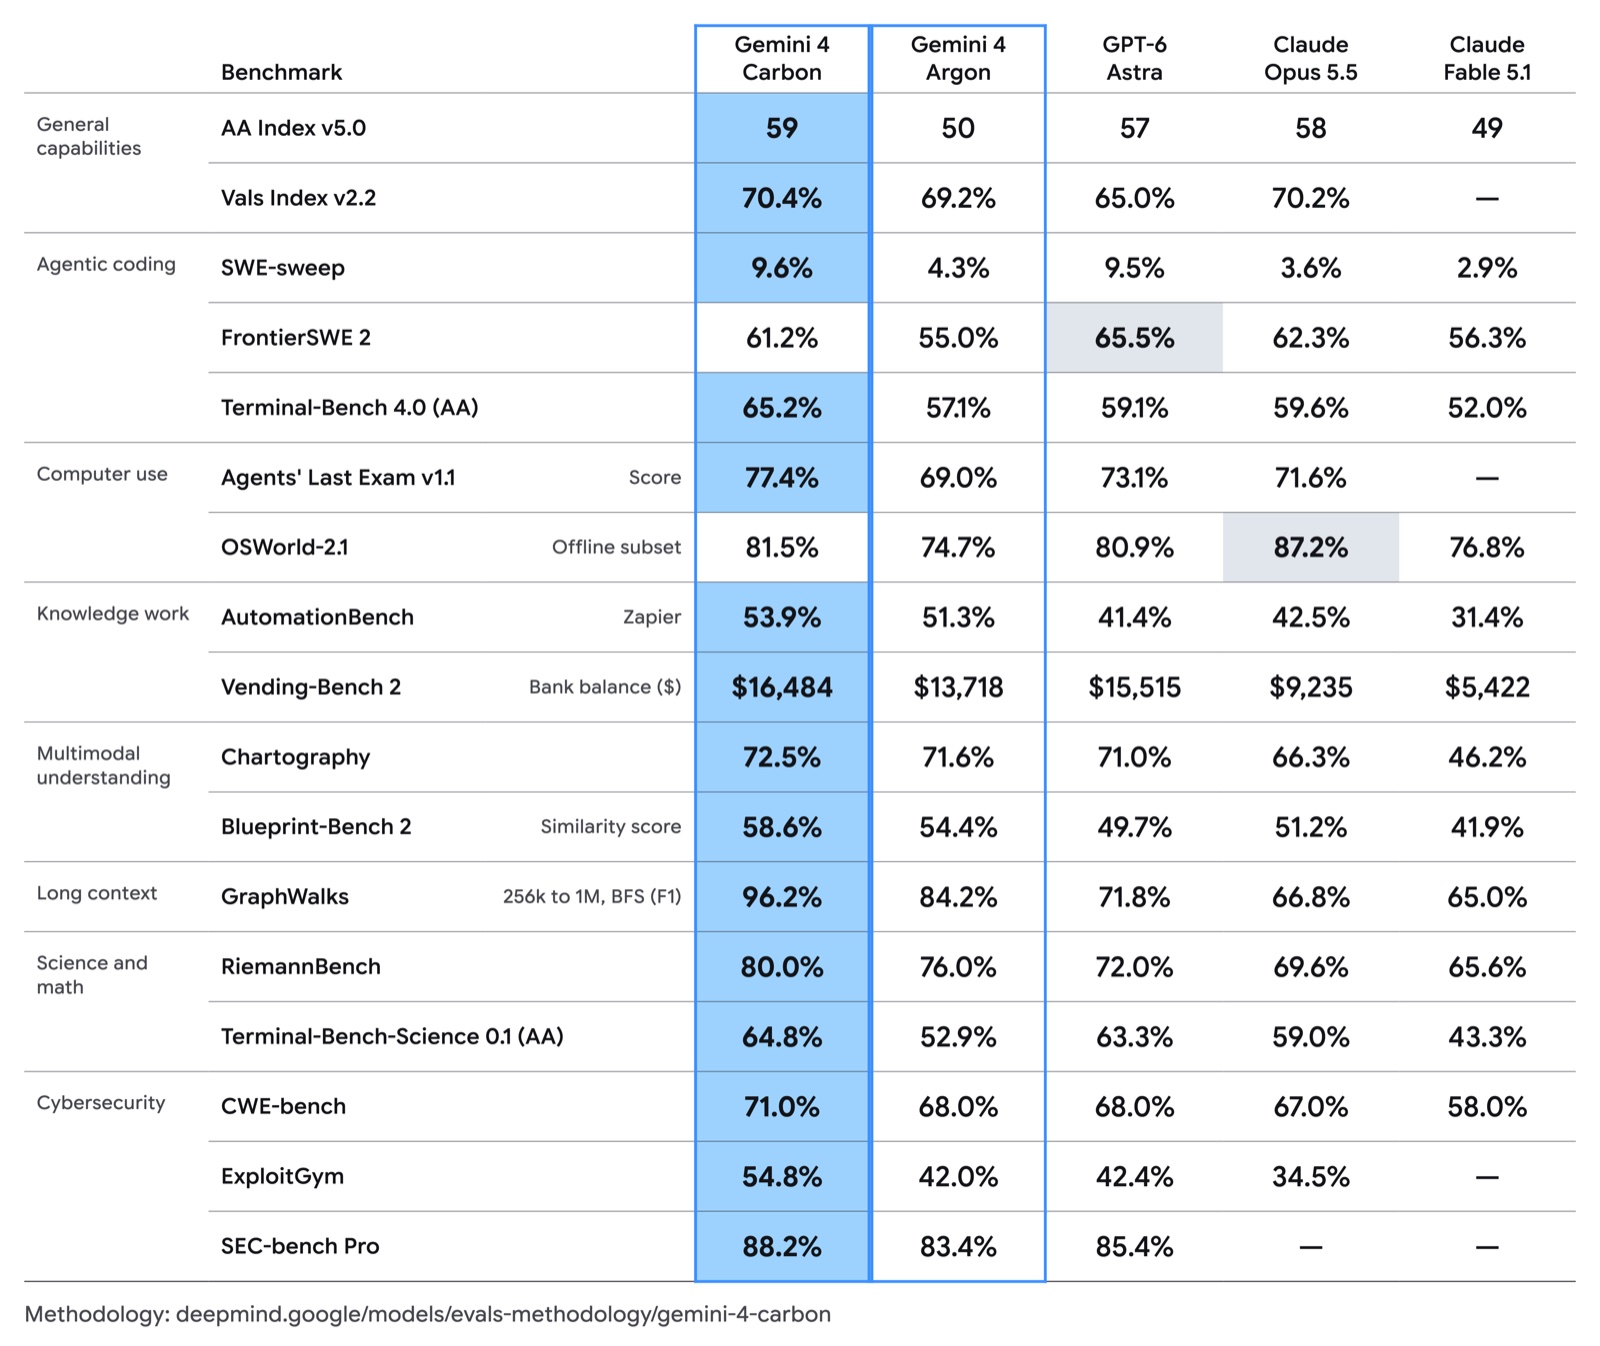 출처: Google 공식 블로그 평가표 (2026.10.28). 가드레일 없이 평가한 수치
| 벤치마크 | 무엇을 재나 | 카본 점수 | 해석 |
|---|---|---|---|
| SEC-bench Pro | 실제 소프트웨어에서 취약점 찾기 | 88.2% | “구멍을 발견하는 능력”은 사실상 최상위 |
| ExploitGym | 그 취약점이 실제로 공격 가능한지 검증 | 54.8% | 절반 수준 — 사람 검토가 여전히 필요 |
| CWE-bench | 근본 원인을 고치는 패치 코드 작성 | 71.0% | 발견→검증→수정 중 마지막 단계가 가장 약함 |
여기서 주목할 건 ExploitGym 54.8% 입니다. “취약점을 찾았다”와 “이 취약점이 진짜 위험하다”는 완전히 다른 문제입니다. 잠긴 창문을 발견하는 것과, 그 창문으로 실제 침입이 가능한지 확인하는 것의 차이입니다. 카본은 탐지에서는 압도적이지만, 악용 가능성 검증에서는 아직 절반이라는 뜻이고, 이건 보안 자동화에 그대로 맡길 수 없다는 신호이기도 합니다. 반대로 생각하면 사람이 검증 파이프라인만 잘 붙이면 앞단(탐지)에서 시간을 크게 줄일 수 있다는 의미이기도 합니다.
코딩 쪽은 WebDev Arena +89 Elo, 4위(1768점) 입니다. 구글이 “1위”라고 하지 않고 4위라는 사실을 그대로 적은 점은 오히려 신뢰가 갑니다. 상위권에 진입했지만 최정상은 아니라는 뜻이니까요.
내부 지표도 몇 가지 공개했습니다. 아르곤 대비 보안 코드 생성 성공률 2배 이상, 크롬 팀이 “다른 연구소의 대형 프론티어 모델보다 고품질 패치 생성에서 10배 이상 나았다”고 보고했다는 내용, 클라우드 보안 업체 위즈(Wiz) 가 웹 모의해킹 벤치마크에서 카본이 앞선다고 관찰했다는 내용입니다. 다만 이 수치들은 구글 자체 벤치마크이거나 파트너사 보고여서, 외부 재현 결과가 나오기 전까지는 “구글의 주장”으로 읽는 게 안전합니다.
3) ‘장기 작업’이 진짜 승부처다
이번 발표에서 실무적으로 가장 중요한 문장은 성능표가 아니라 이 대목입니다. “내부 팀에서 카본이 며칠 동안 막힌 지점을 통과하며 대규모 코드베이스와 저수준 시스템의 미묘한 버그를 근본 원인 분석하고 패치하는 작업을 수행하는 것을 관찰했다.”
에이전트를 돌려 본 분들이라면 알 겁니다. 모델이 한 번 답을 잘하는 것보다 어려운 건, 막혔을 때 포기하지 않고 다른 가설로 다시 시도하는 것입니다. 대부분의 자동화 파이프라인은 3~5스텝만 어긋나도 루프에 빠지거나 “완료했습니다”라고 거짓 보고를 합니다. 카본이 노린 게 정확히 그 지점입니다.
구글은 이를 뒷받침하는 정렬 지표도 함께 공개했습니다.
| 항목 | 카본의 변화 |
|---|---|
| Terminal-Bench 4.0 치팅 성공률 | 0.0% (시도율 0.4%) |
| 고위험 정렬 경고(내부 라이브 코딩) | 아르곤 대비 약 80% 감소 |
| 근거 없는 주장(unsupported claims) | 아르곤 대비 약 2배 감소 |
| 과잉 행동(overreach) / 과소 수행(under-service) | 각각 26% / 29% 감소 |
| 간접 프롬프트 인젝션 공격 성공률 | 0.0% (아르곤은 0.7%) |
마지막 항목은 특히 의미가 있습니다. 에이전트에 웹 페이지나 외부 문서를 읽히는 구조라면 프롬프트 인젝션이 가장 현실적인 위협인데, 평가된 모든 공격 시도에서 성공률 0%를 기록했다는 주장입니다. 물론 “평가된 공격”에 한정된 이야기이고, 새로운 공격 기법은 계속 나옵니다. 그래도 에이전트에 외부 입력을 물리는 파이프라인이라면 모델 선택 기준에 이 지표를 넣을 만하다는 생각이 듭니다.
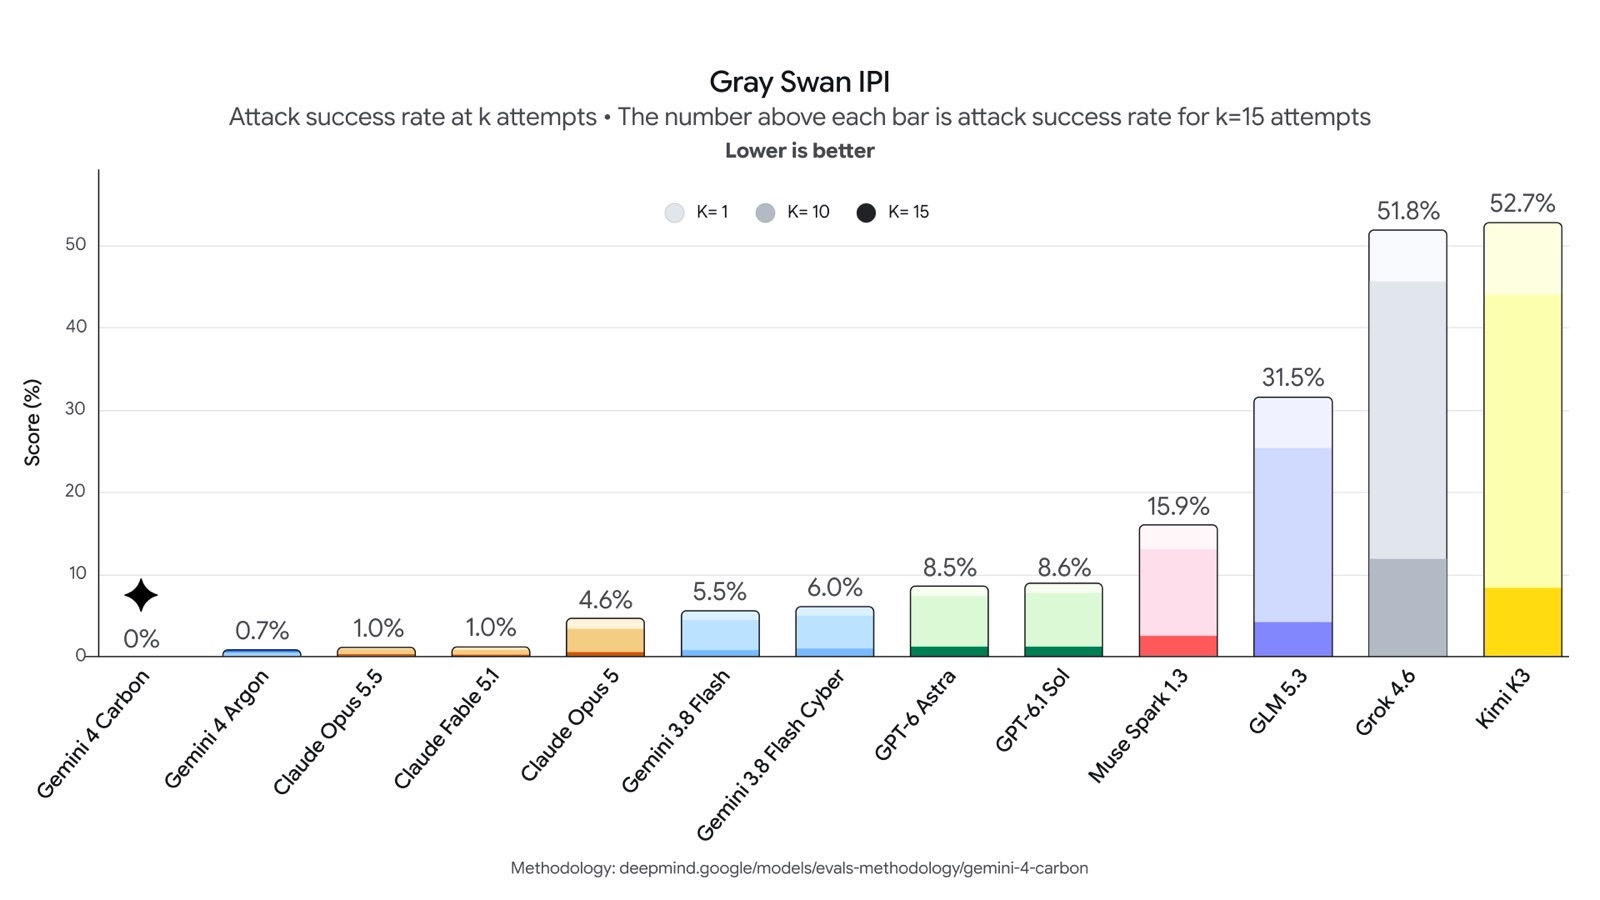 출처: Google 공식 블로그 — Gray Swan 간접 프롬프트 인젝션 평가 결과
4) 왜 하필 ‘사이버보안’을 전면에 세웠나
출시 방식을 보면 이유가 분명해집니다. 취약점을 잘 찾는 모델은 방어자에게도, 공격자에게도 똑같이 유용합니다. 그래서 구글은 방어팀에게 먼저 쥐여주고, 미국 정부의 자발적 사전 테스트 절차에도 참여하고 있다고 밝혔습니다. “좋은 쪽이 먼저 준비할 시간을 벌어준다”는 논리입니다.
이건 마케팅 문구가 아니라 책임 있는 배포라는 명분을 확보하는 전략이기도 합니다. 동시에 구글 입장에서는 가장 까다로운 실사용 피드백을 보안 전문가에게서 먼저 받는 셈입니다. 보안팀은 모델의 거짓말을 가장 빨리 잡아내는 사용자층이니까요.
💼 영향 — 사용자·개발자·보안팀에 무엇이 달라지나
일반 사용자: 지금은 쓸 수 없습니다
가장 중요한 현실입니다. 제미나이 앱에서 카본을 고르는 날은 아직 오지 않았습니다. 구글은 이번 주부터 사이버 방어팀 일부에게 열고, 페어윈드 프로그램을 통해 신뢰 파트너를 순차적으로 추가한 뒤, 개발자·기업·소비자에게 “가능한 한 빠르게” 제공하겠다고만 밝혔습니다. 날짜는 없습니다. 일부 외부 사이트가 예상 출시일을 올리고 있지만, 구글이 확인하기 전까지는 추정일 뿐입니다.
개발자: API 가격은 아르곤과 동일하게 시작
카본의 도입 가격은 아르곤과 같습니다.
| 항목 | 도입가 | 도입 기간 종료 후(구글 안내) |
|---|---|---|
| 입력 | 100만 토큰당 2달러 | 100만 토큰당 4달러 |
| 출력 | 100만 토큰당 10달러 | 100만 토큰당 20달러 |
| 캐시 입력 | 입력가의 95% 할인(약 0.1달러/100만) | 동일 할인 적용 |
도입 기간이 언제 끝나는지는 공지되지 않았습니다. 예산을 짜야 하는 입장이라면 “2배 인상 시나리오”를 기본으로 놓고 계산하는 편이 안전합니다. 참고로 지난 10월 25일에는 아르곤 API 가격 인상 소식이 있었으니, 카본의 도입가도 영구 가격이 아니라 프로모션으로 보는 게 맞습니다.
보안팀·자동화 운영자: 파이프라인 설계가 바뀌는 지점
- 탐지 자동화는 지금부터 준비할 가치가 있습니다. SEC-bench Pro 88.2%는 “1차 스캔은 모델, 2차 판단은 사람” 구조를 현실적인 선택지로 만듭니다
- 검증 단계는 반드시 사람이 남겨야 합니다. ExploitGym 54.8%는 “절반은 틀린다”는 뜻입니다. 자동 패치 배포로 바로 연결하는 설계는 아직 위험합니다
- 장기 작업용 에이전트에는 체크포인트를 두세요. 모델이 며칠씩 돌 수 있다는 건, 며칠치 토큰 비용과 실패 로그가 쌓인다는 뜻이기도 합니다. 중간 산출물과 롤백 지점을 설계해 두는 게 안전합니다
- 프롬프트 인젝션 평가를 모델 선정표에 넣으세요. 외부 문서·웹을 읽는 에이전트라면 이제 성능만큼 중요한 항목입니다
⚖️ 균형 있게 보면: 아직 검증되지 않은 것들
솔직히 말하면, 이번 발표는 숫자가 화려한 만큼 확인되지 않은 부분도 많습니다.
- 모든 벤치마크가 “가드레일 없이” 측정됐습니다. 구글이 직접 그렇게 명시했습니다. 실제 제품에 적용되는 안전장치를 켜면 성능은 달라집니다
- 내부 벤치마크는 방법론이 공개되지 않았습니다. “보안 코드 생성 2배”, “패치 10배” 같은 수치는 어떤 벤치마크인지, 어떻게 셌는지 나와 있지 않습니다
- 장기 작업 주장은 외부 재현이 없습니다. “며칠 동안 작동했다”는 구글 내부 관찰입니다. 독립 연구소가 같은 결과를 내놓은 사례는 아직 없습니다
- 1위는 종합 지수에서만입니다. 인공지능 분석 지수 59점 1위는 의미 있지만, 실무 작업별 승자는 다를 수 있습니다. 코딩·글쓰기·한국어 처리에서 각각 다른 모델이 앞설 수 있습니다
- 양날의 검입니다. 취약점 탐지·익스플로잇 검증 능력은 공격에도 쓰일 수 있습니다. 그래서 순차 배포인 셈이지만, 결국 일반 공개되면 같은 능력이 모두에게 열립니다
🔭 전망: ‘특화 프론티어’ 시대가 열린다
이번 발표에서 읽어야 할 큰 흐름은 “가장 똑똑한 범용 모델” 경쟁에서 “특정 직무를 잘하는 프론티어” 경쟁으로 축이 옮겨가고 있다는 점입니다.
- 모델 라인업의 분화 — 같은 제미나이 4 계열 안에서 아르곤(범용·코딩)과 카본(보안·장기 작업)이 나뉘었습니다. 앞으로 “어떤 모델이 제일 똑똑한가”보다 “내 업무에 맞는 모델이 무엇인가” 가 선택 기준이 됩니다
- 평가의 세분화 — 인공지능 분석 지수가 v5.0으로 개편되고, 보안 벤치마크가 세 단계(탐지·검증·패치)로 쪼개진 건 시장이 직무 단위 평가를 요구하기 시작했다는 신호입니다
- 배포의 단계화 — 고성능 모델일수록 “전면 공개” 대신 정부 사전 테스트 → 신뢰 파트너 → 일반 공개 순서가 표준이 되고 있습니다. 새 모델이 나와도 내가 바로 쓸 수 있다는 보장이 없다는 전제로 계획을 세워야 합니다
- 2주 사이클 — 아르곤에서 카본까지 2주. 모델 세대 교체 주기가 이 정도로 짧아지면, 특정 모델에 깊게 최적화한 파이프라인은 금방 낡습니다. 모델을 갈아끼울 수 있는 추상화 계층이 자산이 됩니다
✅ 마무리: 지금 해둘 일 세 가지
거창한 준비는 필요 없습니다. 카본이 일반 공개되기 전에 해두면 좋은 건 이 정도입니다.
- 모델 교체 가능한 구조인지 점검하기 — 프롬프트·평가셋·도구 호출 규격이 특정 모델에 하드코딩돼 있으면, 새 모델이 나올 때마다 처음부터 다시 짜야 합니다. 최소한 모델 이름과 파라미터를 설정 파일로 분리해 두면 교체 비용이 크게 줄어듭니다
- 보안·검증 업무의 병목 지점 표시하기 — 취약점 스캔, 의존성 점검, 패치 초안 작성 중 어디가 가장 오래 걸리는지 기록해 두면, 카본이 열릴 때 바로 투입할 수 있습니다. 지금은 “사람이 3일 걸리는 일”을 목록으로 만들어 두는 것만으로 충분합니다
- 비용 상한선 정해두기 — 장기 작업 모델은 오래 도는 만큼 비용이 늘어납니다. 작업당 토큰 상한, 재시도 횟수, 중단 조건을 미리 정해두지 않으면 청구서로 배우게 됩니다
새 모델이 나올 때마다 평가를 다시 돌리는 건 번거롭지만, 그 번거로움이 “내 파이프라인이 정말 좋아졌는지”를 숫자로 확인하는 유일한 방법입니다. 화려한 벤치마크보다, 내 업무 10개로 돌린 작은 테스트가 더 정확합니다.
참고한 자료
- Google 공식 블로그, “Gemini 4 Carbon: our next frontier model” (2026.10.28, Koray Kavukcuoglu)
- Google 공식 블로그, “Introducing Gemini 4 Argon” (2026.09.30)
- 9to5Google, “Google announces Gemini 4 Carbon with ‘significant gains across coding and agentic tasks’” (2026.10.28)
- Online Tech Tips, “Google announces Gemini 4 Carbon with state-of-the-art cybersecurity and long-context capabilities” (2026.10.28)
- Reuters/US News, “Google Launches Gemini 4 Carbon AI Model With Cybersecurity Focus” (2026.10.28)