
OpenAI GPT 최신 소식 — ETH 반증·카케야 추측·양-밀스, 난제 3개 해법 공개 (2026.10.28)
📌 한줄 요약: 2026년 10월 26일(현지시간), OpenAI가 내부 모델로 얻은 세 가지 연구 결과를 공개했습니다. ① 1991년 제기된 국소 평활화 추측(local smoothing conjecture) 을 모든 차원에서 증명 — 카케야 추측과 스타인 제한 추측까지 함께 해결, ② 지수시간가설(ETH)이 거짓이라는 반증, ③ 게이지장과 페르미온을 포함한 4차원 상호작용 양자장론의 존재 증명(양-밀스 존재, QCD 포함). 세 건 모두 Lean 형식화를 거쳤고, ETH는 가설을 처음 제안한 러셀 임파리아초·라마모한 파투리(UCSD) 와 MIT 라이언 윌리엄스가 검증 그룹을 맡았습니다. 단, 동료검토 전이고 앤트로픽이 같은 날 자체 ETH 반증을 내놓는 등 검증 경쟁이 붙은 상태입니다.
복잡도 이론이나 알고리즘을 다루는 개발자라면, “이 문제는 지수 시간이 필요하다”는 전제 위에 세워진 논문과 설계를 한 번쯤 만나게 됩니다. 그 전제의 뿌리에 해당하는 것이 지수시간가설(Exponential Time Hypothesis, ETH) 입니다. 만약 이 전제가 흔들리면, 그 위에 얹힌 수백 편의 결과와 “이 정도가 최선”이라는 통념이 같이 재검토 대상이 됩니다.
10월 26일 OpenAI가 공개한 글 “Working with academic communities to build scientific understanding” 은 정확히 그 지점을 건드립니다. 이번 발표에서 눈에 띄는 건 결과 자체만이 아니라, 결과를 세 분야에 서로 다른 방식으로 공개하는 절차를 실험했다는 점입니다. 이 글은 무엇이 나왔는지 → 절차가 어떻게 달라졌는지 → 개발자·실무에 무엇이 걸리는지 → 아직 아닌 것 순서로 정리했습니다.
 OpenAI 공식 블로그 ‘Working with academic communities to build scientific understanding’ 대표 이미지 (출처: OpenAI 공식 블로그, 2026년 10월 26일)
이슈 요약 — 한 장으로 정리
| 항목 | 내용 |
|---|---|
| 무엇을 | 내부 모델이 낸 연구 결과 3건 공개 (수학·컴퓨터과학·물리) |
| 언제 | 2026년 10월 26일 (현지시간), 주요 외신 27일 보도 |
| 수학 | 국소 평활화 추측 전 차원 증명 → 카케야·스타인 제한 추측 해결 |
| 컴퓨터과학 | 지수시간가설(ETH) 반증 — “ETH는 거짓” |
| 물리 | 4차원 게이지장+페르미온 양자장론 존재 증명 (QCD, 양-밀스 존재 포함) |
| 검증 | 3건 모두 Lean 형식화 완료 (수학 10/19, CS 10/17, 물리 10/16) |
| 검증 주체 | 수학: AI 출력 공개 / CS: 임파리아초·파투리·윌리엄스 그룹 / 물리: 데이비드 그로스 그룹 |
| 공개 위치 | github.com/openai/math (수학·CS 논문 PDF + Lean 증명) |
| 물리 자료 | 그룹 결정으로 AI 산출물 비공개, 그룹이 직접 논문화 |
| 부대 조치 | 사이먼스 재단에 500만 달러 기여, ETH 함의 논의 학회 개최 지원 |
숫자만 보면 “또 하나의 AI 수학 발표”로 읽힙니다. 하지만 이번 건은 모델 공개 없이 내부 모델로 얻은 결과라는 점, 그리고 검증을 외부에 넘기는 방식을 분야별로 다르게 실험했다는 점에서 성격이 다릅니다.
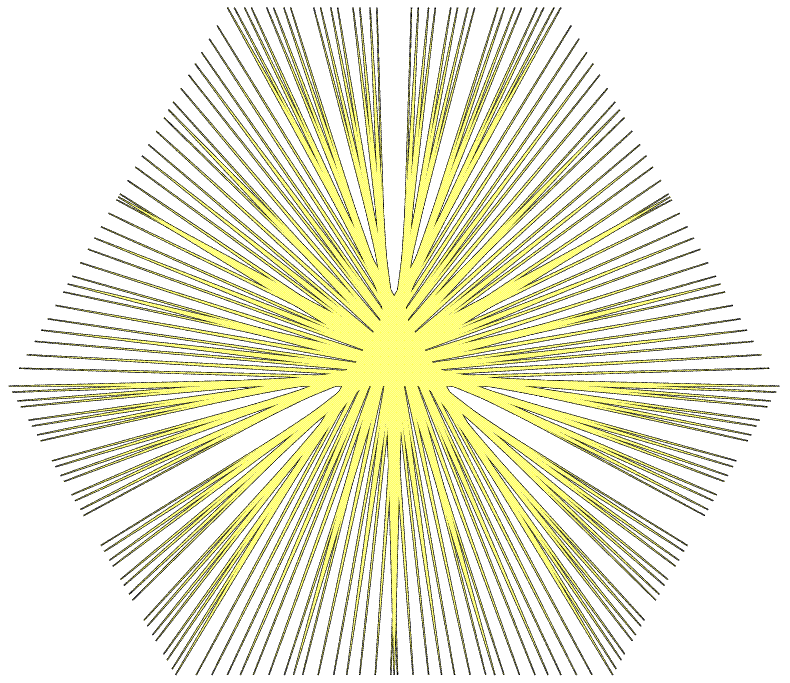 카케야 바늘 집합(Perron tree 구성) — 이번 수학 결과가 다루는 카케야 추측과 직접 연결되는 도형 (출처: Wikimedia Commons, 퍼블릭 도메인)
상세 분석 — 세 가지 결과
1) 수학: 파동이 “가장 극단적으로 모이는 순간”에 대한 추측
첫 번째는 조화해석학입니다. 1991년 소게(Sogge) 가 제안한 국소 평활화 추측은 파동이 초점처럼 모일 때, 가장 극단적인 집중은 오래 지속될 수 없다는 내용입니다. 평균적인 순간의 집중은 최악의 순간보다 훨씬 작다는 것 — 최악값과 평균값이 벌어지는, 수학에서 흔한 패턴입니다.
이 추측이 중요한 이유는 따름정리 때문입니다. 국소 평활화 추측이 참이면 카케야 추측과 스타인 제한 추측이 따라 나옵니다. 그동안의 진전은 이랬습니다.
- 2019년 구스·왕·장(Guth–Wang–Zhang): 국소 평활화 추측을 공간 2차원에서 증명
- 2025년 왕·찰(Wang–Zahl): 카케야 추측을 3차원에서 증명
- 2026년 10월, OpenAI 모델: 국소 평활화 추측을 모든 차원에서 증명 → 카케야·스타인 제한 추측까지 전 차원 해결
OpenAI는 새 증명이 새로운 보조 편미분방정식에 기반한다고 밝혔습니다. 산출 시점도 공개돼 있습니다. 10월 18일 자연어 결과를 얻고, 다음 날 Lean 형식화를 마쳤습니다. 공개 방식은 이번에도 10월 6일 공개와 같은 방식 — AI 출력과 Lean 증명을 GitHub에 그대로 올리는 쪽이었습니다.
2) 컴퓨터과학: “ETH는 거짓” — 이번 발표의 핵심
두 번째가 가장 파장이 큽니다. 지수시간가설(ETH) 은 1999년 임파리아초와 파투리가 제안한 가설로, 불리언 논리식 만족 문제(SAT) 의 난이도에 대한 가정입니다. 쉽게 말해 “변수 개수가 늘면 최선의 알고리즘도 지수적으로 느려진다”는 통념입니다.
이 가설이 중요한 이유는 이론 자체보다 쓰임새에 있습니다. ETH를 전제로 “이 문제는 이보다 빠를 수 없다”는 조건부 하드니스 결과가 그래프 이론, 계산생물학, 데이터베이스, 계산기하 등에서 수백 편의 논문에 깔려 있습니다. OpenAI는 내부 시스템이 ETH가 거짓임을 증명했고, 그 결과가 Lean으로 검증됐다고 밝혔습니다.
검증 그룹의 구성이 의미심장합니다. 가설을 처음 제안한 두 사람과, 그 가설의 강한 버전을 이미 반박한 이력이 있는 MIT 라이언 윌리엄스가 함께 맡았습니다. 윌리엄스는 과거 OpenAI의 결과물 투하 방식을 두고 “수학자들에 대한 DDoS 공격”이라고 비판했던 사람입니다. 그가 이번에는 협업을 수락했습니다.
그룹이 OpenAI에 요구한 조건도 공개됐습니다.
- 모든 원자료 공개 — 독립 검증이 가능하도록
- 학회 개최 자금 지원 — 이 결과가 분야 전체에 갖는 함의를 논의할 자리
OpenAI는 두 요구를 모두 수락했고, 자연어 증명과 Lean 형식화를 GitHub에 공개했습니다. 산출 시점은 10월 16일, Lean 형식화는 10월 17일입니다.
3) 물리: 4차원 양자장론의 존재 증명
세 번째는 이론물리의 가장 어려운 구석입니다. 표준모형은 중력을 뺀 세 가지 힘을 설명하지만, 임의로 짧은 거리까지 외삽할 수 없다는 구조적 한계가 있습니다. OpenAI는 게이지장과 페르미온을 포함한 4차원 상호작용 양자장론의 존재에 대한 수학적으로 엄밀한 증명을 제시했다고 밝혔습니다.
- 대상: QCD(쿼크·글루온의 강한 상호작용)와 표준모형의 통일적 완성
- 부분 문제로 순수 양-밀스 이론의 존재 증명 포함 — 클레이 수학연구소 밀레니엄 문제의 일부
- 기반: 발라반(Balaban)의 건설적 양자장론 접근
검증 그룹은 데이비드 그로스가 이끕니다. 1973년 양-밀스 이론의 점근적 자유도 연구로 QCD를 강한 상호작용 이론으로 자리잡게 한 인물이고, 2004년 노벨 물리학상 공동 수상자입니다. 여기에 마이클 더글러스, 아서 재피, 이고르 클레바노프, 니키타 네크라소프가 참여합니다. 재피는 윈튼과 함께 양-밀스 밀레니엄 문제를 정식화한 사람입니다.
산출 시점은 더 이릅니다. 양-밀스 존재 증명 9월 9일, QCD 증명 9월 18일, 그리고 Lean 형식화 완료가 10월 16일입니다. 분량과 복잡도 때문에 형식화가 끝날 때까지 공개를 미뤘다고 설명했습니다. 이 건은 공개 방식이 다릅니다. 그룹이 AI 산출물을 당분간 공개하지 않고 직접 논문을 쓰는 쪽을 택했습니다.
4) 절차 실험 — 같은 발표를 세 가지 방식으로 내놓다
이번 글에서 실질적으로 새로운 부분은 공개 절차입니다. OpenAI는 세 분야에 서로 다른 전략을 적용했습니다.
| 분야 | 공개 전략 |
|---|---|
| 수학 | AI 출력물을 그대로 공개, 해설은 연구자 커뮤니티가 자율 조직 |
| 컴퓨터과학 | 외부 협업 그룹이 해설 + AI 출력은 누구나 검토 가능하게 즉시 공개 |
| 물리 | 외부 협업 그룹 구성 후 자료 공개 시점은 그룹에 위임 |
협업 원칙도 네 가지로 못 박았습니다. 투명성(NDA 없음, 중간 결과 공유 자유), 학술적 공로 불요구(내부 모델이 낸 발견에 대해 OpenAI가 공로를 주장하지 않음), 기여자 인정(해설·집필에 대한 크레딧은 그룹에), 독립성(무보수·자발적 참여, 발언은 그룹 자신의 것).
한계도 스스로 인정했습니다. “어떤 초기 조력자를 고르느냐가 누가 먼저 참여하는지를 규정하고 정보 비대칭을 만든다“는 문장이 그대로 들어 있습니다. 그리고 사이먼스 재단의 1,500만 달러 규모 AI 시대 수학 대응 사업에 500만 달러를 기여했습니다.
영향 — 개발자와 실무에 무엇이 걸리나
1) “이 정도가 최선”이라는 전제가 재검토 대상이 됩니다
ETH가 거짓이라면, ETH를 근거로 “이 이상 빠른 알고리즘은 없다”고 주장해 온 결과들이 조건을 잃습니다. 당장 코드가 느려지거나 빨라지는 문제는 아니지만, 알고리즘 선택의 근거 문서와 성능 상한에 대한 사내 가정은 출처를 다시 확인할 필요가 생깁니다.
2) 암호 체계 영향 — 확인은 됐지만 “안전 보증”은 아닙니다
윌리엄스는 인터뷰에서 가장 먼저 암호 영향을 확인했습니다. 키 길이에 의존하는 체계가 흔들릴 수 있기 때문입니다. 그가 OpenAI 과학 책임자 댄 로버츠에게 물었고, OpenAI 쪽은 암호 체계가 깨지지 않는다고 상당히 확신한다고 답했다고 전해집니다. 다만 이는 “지금 알려진 범위에서 즉각적 위험은 없다” 는 수준의 답변이지, 수학적 안전 증명이 아닙니다.
3) 벤치마크로 측정되지 않는 능력
이번 결과는 모델을 공개하지 않고 내부 모델로 얻은 산출물입니다. 외부에서는 같은 입력으로 재현할 수 없습니다. 공개 벤치마크 점수로는 이런 종류의 능력을 가늠하기 어렵다는 점이 다시 확인된 셈입니다. 사내에서 모델을 평가할 때 “공개 리더보드 + 자체 과제” 조합이 필요한 이유이기도 합니다.
4) 연구·검증 프로세스가 병목이 됩니다
결과를 얻는 속도보다 검증하는 속도가 느립니다. OpenAI도 이번 글에서 산출물을 “가공되지 않은 연구 데이터(raw research data)“로 규정하고, 그것을 과학적 이해로 바꾸는 일을 별도 과업으로 놓았습니다. 자동화 파이프라인을 운영하는 입장에서 보면, 산출물 생성 단계는 이미 자동화됐고 검증·해설·문서화 단계가 남은 병목이라는 그림이 낯설지 않습니다.
반응과 반론 — 아직 결론이 아닌 이유
가장 뜨거운 반응은 ETH 쪽에 몰렸습니다.
- 티모시 가워스(콜레주 드 프랑스, 필즈상): “거짓이라는 것은 매우 놀랍고 중대하다”
- 라이언 윌리엄스(MIT): “일부는 일상적이라고 할 수 있지만, 외계인처럼 보이는 부분이 두세 군데 있었고 바로 그 부분이 온 커뮤니티가 함께 다뤄야 할 지점이라고 생각했다.” 또 “모든 컴퓨터과학자가 P=NP 가능성에 조금 더 무게를 둬야 하지만, 개인차는 있다”, “이것이 최종 답이라고 생각하지 않는다”
- 존 D. 쿡(응용수학 컨설턴트): “P=NP의 지위는 여전히 미지다. 3-SAT이 지수 시간이 걸리지 않는다 해도, 아는 한 다항 시간보다는 오래 걸린다”
- 게리 마커스(NYU 명예교수): “맞다면 큰일”
경쟁 구도도 변수입니다. OpenAI 발표 몇 시간 뒤 앤트로픽이 자체 ETH 반증을 공개했습니다. 앤트로픽 소속 수학자 레벤트 알포게는 OpenAI 결과가 기존 연구에 기반한 것이라고 지적했습니다. 검증 그룹 역시 자신들의 참여가 결과에 대한 보증이 아니라는 점을 공개 서한에서 분명히 했습니다.
맥락도 함께 봐야 합니다. 10월 초 OpenAI가 수백 건의 수학 결과를 GitHub에 올렸을 때 수학계 반발이 있었고, 나비에-스토크스 건에서는 Lean이 검증한 명제가 당초 문서보다 약한 것 아니냐는 지적이 나왔습니다. 이번에 절차를 세분화한 것은 그 비판에 대한 응답 성격입니다.
실무 체크리스트 — 지금 할 수 있는 것
- 성능 상한 문서 표시: “ETH에 따르면 이보다 빠를 수 없다”는 근거를 쓰는 문서가 있다면, 조건부 결과임을 명시
- 암호 의존도 점검: 자체 프로토콜이 특정 키 길이·난이도 가정에 기대고 있다면, 가정의 출처와 교체 비용을 함께 기록
- 논문 인용 재확인: 인용 중인 하드니스 결과가 ETH 전제에 기대는지 표시해 두면, 후속 검증 결과가 나왔을 때 갱신 범위가 좁아집니다
- 벤더 주장 검증 절차: “내부 모델로 발견” 유형의 발표는 재현 불가를 전제로, 자체 과제로 교차 확인
- 검증 단계 자동화: 산출물 생성이 빨라질수록 검증·기록이 병목이 되므로, 산출물에 출처·버전·검증 상태를 붙이는 규칙을 먼저 정해 두는 편이 안전합니다
전망
이번 발표의 실질적 변화는 “AI가 어려운 문제를 풀었다”가 아니라 “AI 산출물을 학계가 소화하는 절차를 실험하기 시작했다” 는 쪽에 가깝습니다. 결과의 참·거짓은 앞으로 몇 달간의 검증과 학회 논의에서 갈릴 것이고, OpenAI 스스로도 어느 전략이 유용한지 아직 모른다고 적었습니다.
당장 업무 자동화 파이프라인에 넣을 변화는 없습니다. 다만 “AI가 낸 결과를 어떻게 검증하고 기록할 것인가” 라는 질문은 이미 실무로 넘어왔습니다. 그 질문에 답을 준비해 둔 팀과 그렇지 않은 팀의 차이는, 다음 번 비슷한 발표가 나올 때 드러날 가능성이 큽니다.
참고한 자료
- OpenAI, “Working with academic communities to build scientific understanding” (2026.10.26)
- TechCrunch, “Frontier AI labs say their models refuted the Exponential Time Hypothesis. What does that mean?” (2026.10.27)
- Business Insider, “What smart people are saying about OpenAI’s Exponential Time Hypothesis claim” (2026.10.27)
- Gizmodo, “OpenAI Trumpets 3 More Math and Science Results, Along With a New Plan for Publishing Them” (2026.10.27)
github.com/openai/math— 수학·CS 논문 PDF 및 Lean 증명