
OpenAI GPT 최신 소식 — Uber 전 직원 3만 명이 ChatGPT Work로 갈아탄 이유 (2026.10.26)
📌 한눈 요약: 2026년 10월 22일, Uber와 OpenAI가 ChatGPT Work를 전 세계 임직원 3만 명 규모로 전면 확대한다고 발표했습니다. 올해 초 1,000명 파일럿으로 시작한 실험이 30배로 커진 셈입니다. 눈에 띄는 건 규모만이 아닙니다. 파일럿 얼리어답터의 약 80%가 엔지니어가 아닌 비기술 직군이었고, 기본 모델은 GPT-6.1 Sol입니다. “개발자 도구”가 아니라 사무직 전체의 실행 레이어로 에이전트가 들어온다는 신호라, 업무 자동화를 준비하는 쪽이라면 읽어볼 만한 사례입니다.
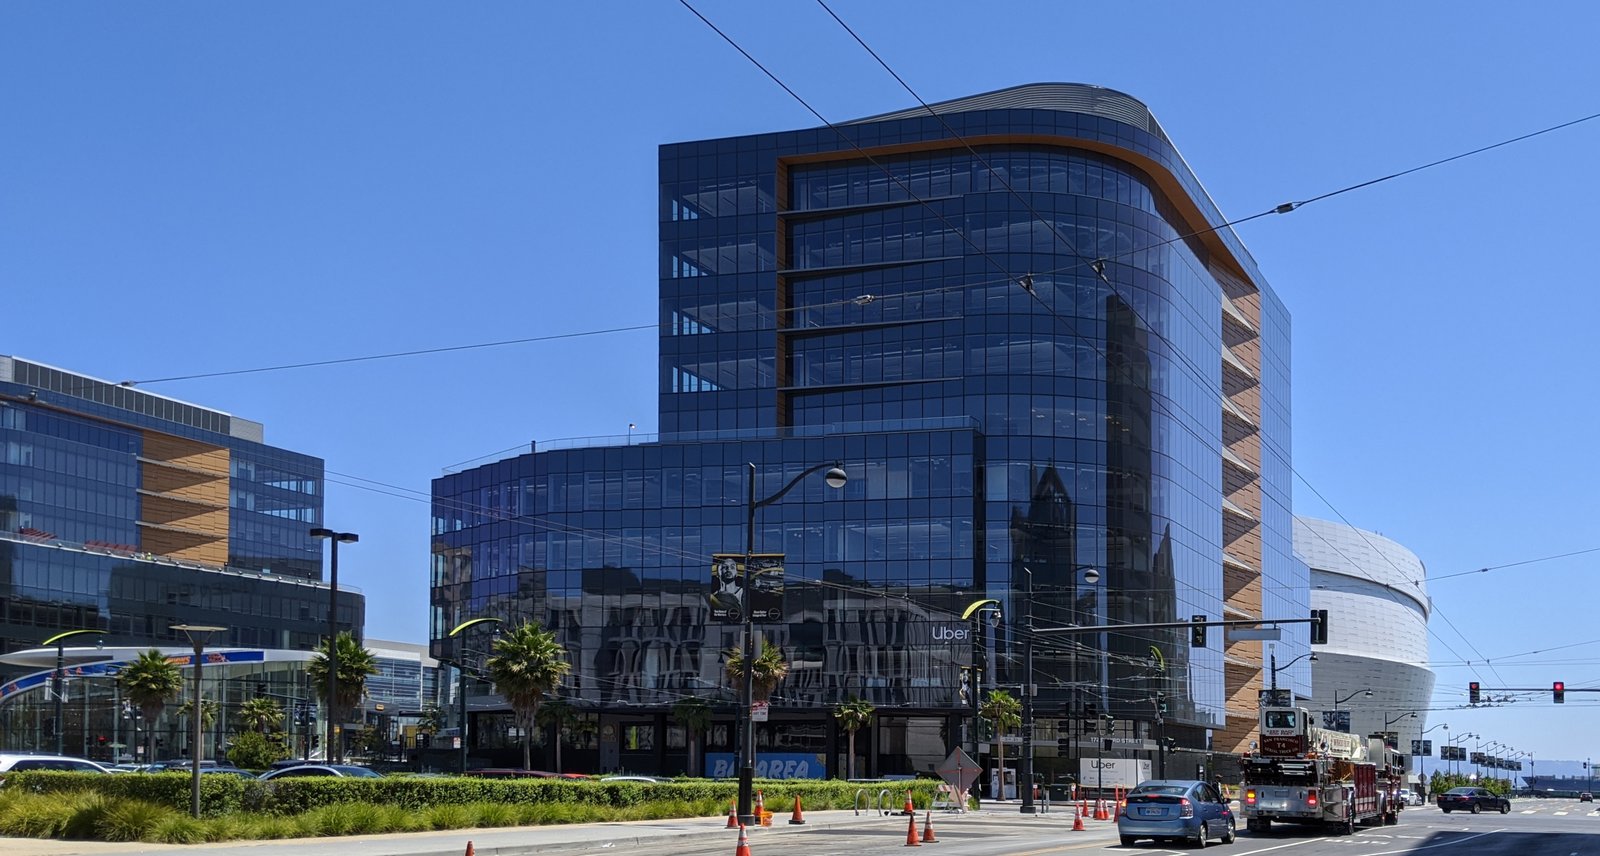
사진: HaeB, CC BY-SA 4.0 (Wikimedia Commons) — 샌프란시스코 미션베이 3rd Street·16th Street 교차로의 Uber 오피스. 이번 ChatGPT Work 전면 도입이 발표된 회사의 본사 건물입니다.
1. 무슨 일이 있었나 — 1,000명 실험이 30,000명이 되기까지
2026년 10월 22일(현지시간), Uber와 OpenAI는 파트너십 확대를 공식 발표했습니다. 핵심은 한 줄입니다. Uber의 전 세계 임직원 약 30,000명 전원이 ChatGPT Work를 쓰게 된다.
ChatGPT Work는 OpenAI가 2026년 7월에 내놓은 기업용 에이전트입니다. 단순히 “질문에 답하는 챗봇”이 아니라, 여러 단계를 스스로 밟아 완성된 결과물까지 만들어내는 쪽에 초점이 맞춰져 있습니다. ChatGPT Enterprise 안에서 동작하는 형태입니다.
타임라인을 정리하면 이렇습니다.
| 시점 | 내용 |
|---|---|
| 2026년 7월 | OpenAI, 기업용 에이전트 ChatGPT Work 출시 |
| 2026년 상반기 | Uber, 재무·운영·프로덕트 등 여러 부서 1,000명 파일럿 진행 |
| 2026년 10월 22일 | Uber, 전 세계 임직원 30,000명 규모로 전면 확대 발표 |
| 기본 모델 | GPT-6.1 Sol (성능과 비용의 균형점으로 선택) |
| 개발 조직 | 기존처럼 Codex를 코딩 도구로 유지 |
여기서 실무자들이 가장 먼저 궁금해하는 부분은 “얼마 썼나”입니다. Uber는 비용을 공개하지 않았습니다. 대신 “직원들이 어떻게 쓰는지, 어떤 워크플로를 만드는지, 실제로 업무가 얼마나 나아지는지를 보고 판단하겠다”는 입장을 밝혔습니다. 좌석(seat) 단가를 깔고 “일단 다 깔아라”가 아니라, 도입 효과를 측정한 뒤 확장 속도를 정하겠다는 구조입니다.
2. 파일럿에서 드러난 진짜 사용처 — 80%가 비엔지니어
이번 발표에서 업무 자동화 관점으로 가장 값진 숫자는 30,000이 아니라 80%입니다.
Uber의 엔지니어링 VP인 수만트 수쿠마르는 TechCrunch에 파일럿 얼리어답터의 약 80%가 엔지니어가 아닌 직군이었다고 말했습니다. 재무, 운영, 프로덕트 등 여러 부서가 섞여 있었고, 이들이 실제로 쓴 방식은 대략 세 갈래였습니다.
- 운영 데이터 분석 — 복잡한 운영 데이터에서 추세를 뽑고 권고안까지 만들기
- 교육 자료 현지화 — 여러 시장·언어에 맞춰 트레이닝 자료를 번역·각색
- 개인 대시보드 제작 — 자기 업무를 관리할 인터랙티브 대시보드를 직접 만들기
세 가지 모두 공통점이 있습니다. “코드를 짜는 일”이 아니라 “여러 도구를 오가며 손으로 하던 일” 이라는 점입니다. 스프레드시트를 열고, 사내 시스템에서 데이터를 뽑고, 슬라이드에 붙이고, 번역기를 돌리고, 다시 표를 만드는 그 반복 말입니다.
이게 왜 중요할까요. 지난 2년간 AI 생산성 논의는 대부분 개발자 생산성에 집중됐습니다. 그런데 실제 기업의 인건비 구조는 개발직보다 비개발 사무직이 훨씬 두껍습니다. 80%라는 숫자는 “에이전트의 실사용 수요가 코딩 바깥에 있다”는 걸 대규모 표본으로 보여준 사례입니다.
한 가지 덧붙이면, ChatGPT Work는 Google Drive, Gmail, Google Calendar, Slack 같은 업무 도구와 연결해 씁니다. 회의 브리핑을 만들고, 발표 자료를 뽑고, 앱을 넘나드는 워크플로를 에이전트 안에서 처리하는 구조입니다. 결국 승부처는 모델 성능만이 아니라 “사내 도구와 얼마나 자연스럽게 붙는가” 입니다.
사진: FoxTPNL, CC BY 4.0 (Wikimedia Commons) — OpenAI 아이콘 스티커. 이번 Uber 사례의 핵심은 개발자가 아닌 일반 직군이 에이전트를 어떻게 쓰는가였습니다.
3. 도입 방식이 눈에 띄는 이유 — ‘강제’가 아니라 ‘측정’
기업 AI 도입이 실패하는 전형적인 패턴이 있습니다. 라이선스를 대량 구매하고, 전사 공지로 “쓰세요”라고 뿌리고, 6개월 뒤 사용률 12%가 찍히는 그림입니다.
Uber가 택한 방식은 조금 다릅니다. 회사가 공개한 내용을 정리하면 이렇습니다.
첫째, 강제하지 않습니다. “Uber 전반에 강력한 AI 도구를 제공하되, 팀이 실험할 여지를 준다”는 표현을 썼습니다. 사용을 의무화하는 대신 사용 패턴 자체를 관찰 대상으로 둡니다.
둘째, ‘AI 파드(pod)’라는 사전 실험을 했습니다. 올해 초 AI 엔지니어 30명을 각 팀에 붙여 2주 동안 그 팀 업무의 핵심 부분을 자동화하게 했습니다. 이 실험의 목적은 자동화 결과물이 아니라 “기술 전문성 + 해당 업무에 대한 깊은 이해”가 만나면 어디까지 되는지를 확인하는 것이었습니다.
셋째, 지원 인프라를 함께 깔았습니다. 사내 AI 스킬 라이브러리, 승인된 연동 목록, 전용 교육을 병행했습니다. 개발 조직은 계속 Codex를 쓰고, 비개발 조직은 ChatGPT Work를 쓰는 식으로 도구를 용도별로 분리한 것도 눈에 띕니다.
자동화 파이프라인을 운영하는 입장에서 보면, 이 세 가지는 사실 기술 이야기가 아니라 조직 운영 이야기입니다. 도구를 사는 것과 도구가 실제로 일을 바꾸게 만드는 것 사이에는 이만큼의 설계가 필요합니다.
4. 냉정하게 짚어야 할 부분
좋은 소식만 적으면 반쪽짜리 정리입니다. 이번 발표에서 확인되지 않았거나, 우려되는 지점을 짚어보겠습니다.
① 비용 구조가 공개되지 않았습니다. 30,000석 규모의 엔터프라이즈 계약은 상당한 금액일 텐데, 단가도 총액도 나오지 않았습니다. “효과를 보고 판단하겠다”는 말은 곧 아직 ROI가 증명되지 않았다는 뜻이기도 합니다.
② ‘사용률’과 ‘생산성’은 다른 이야기입니다. 로그인 수, 질문 수, 생성된 문서 수는 측정하기 쉽습니다. 하지만 그 문서가 재작업 없이 바로 쓸 수 있는 품질이었는지는 별개의 문제입니다. 에이전트 산출물 검수에 드는 시간이 줄지 않으면, 자동화는 일을 옮기는 것에 그칩니다.
③ 데이터·권한 경계 문제는 여전히 남습니다. Drive·Gmail·Calendar·Slack을 한 에이전트에 연결한다는 건, 한 곳에서 잘못된 권한이 설정되면 여러 시스템이 동시에 노출된다는 뜻입니다. 최근 몇 달간 프론티어 랩들이 에이전트 격리 실패 사례를 연달아 공개한 배경도 여기에 있습니다. 도입 검토 단계라면 에이전트가 접근 가능한 데이터 범위를 좌석 단위로 쪼개는 작업이 선행되어야 합니다.
④ 실패 사례가 공개되지 않습니다. 파일럿이 성공했다는 이야기는 나오지만, 어떤 팀에서 왜 안 먹혔는지는 나오지 않습니다. 대규모 롤아웃 사례를 참고할 때는 성공담의 조건을 먼저 따져야 합니다.
5. 업무 자동화 담당자가 훔쳐갈 5가지
이번 사례에서 바로 가져다 쓸 수 있는 것들을 정리했습니다.
| # | 포인트 | 실무 적용 |
|---|---|---|
| 1 | 1,000명 파일럿 → 전사 확대 | 전사 도입 전에 부서 횡단 소규모 파일럿을 먼저 돌리고 수치를 뽑습니다 |
| 2 | 비개발 직군이 80% | 자동화 후보 1순위는 개발이 아니라 반복 보고서·현지화·대시보드입니다 |
| 3 | AI 파드 2주 스프린트 | 엔지니어 1~2명을 특정 팀에 붙여 2주 단위로 업무 하나를 끝까지 자동화합니다 |
| 4 | 용도별 도구 분리 | 코딩은 코딩 도구, 문서·분석은 업무 에이전트로 역할을 섞지 않습니다 |
| 5 | 강제 대신 측정 | 사용률·워크플로 종류·소요 시간 변화를 사전에 정의한 지표로 기록합니다 |
특히 3번은 비용 대비 효과가 큰 방식입니다. 조직 전체에 라이선스를 뿌리는 대신, 한 팀·한 업무·2주라는 작은 단위로 성공과 실패를 빠르게 확인할 수 있기 때문입니다.
6. 전망 — 경쟁 축은 ‘모델’에서 ‘배치’로
이번 발표는 OpenAI의 기업 시장 공세라는 맥락으로 읽어야 정확합니다. ChatGPT로 소비자 브랜드가 된 회사가, 최근 몇 달 사이 기업 고객 확보에 속도를 내고 있다는 점이 여러 보도에서 확인됩니다. 경쟁사인 Anthropic도 기업용 에이전트와 코워크 기능을 연달아 내놓고 있습니다.
같은 주에 나온 소식들을 나란히 놓으면 방향이 더 선명합니다. 마이크로소프트는 25억 달러 규모의 전방 배치(frontier) 조직과 엔지니어 6,000명을 투입하겠다고 밝혔고, AWS도 전방 배치 엔지니어링 조직에 10억 달러를 투입했습니다. 모델 성능 경쟁이 어느 정도 상향 평준화되자, 승부가 “고객 조직 안에 얼마나 깊이 들어가느냐” 로 옮겨간 것입니다.
앞으로 6개월 정도의 관전 포인트는 세 가지로 압축됩니다.
- 에이전트가 만든 결과물의 검수 비용이 얼마나 줄어드는가
- 권한·감사 로그가 좌석 단위로 얼마나 촘촘해지는가
- 파일럿 성공 사례가 재무·법무·HR 같은 규제 민감 부서까지 확장되는가
7. 마무리 — 도입을 검토 중이라면
정리하면 이렇습니다. 이번 뉴스의 본질은 “Uber가 AI를 산”이 아니라, “비개발 직군 80%가 실제로 쓰는 업무 에이전트가 전사 표준이 됐다” 는 점입니다. 업무 자동화를 준비하는 조직이라면 벤치마크로 삼을 만한 사례입니다.
도입을 검토하는 분들께 현실적인 팁을 몇 가지 남깁니다.
- 라이선스부터 사지 마세요. 먼저 자동화할 업무 3개를 고르고, 그 업무의 소요 시간을 지금 측정해 두세요. 나중에 비교할 기준이 없으면 효과를 증명할 수 없습니다.
- 연동 범위를 최소로 시작하세요. 메일·드라이브·메신저를 한꺼번에 붙이면 편해지는 만큼 사고 반경도 커집니다. 읽기 권한부터 여세요.
- 검수 담당자를 정하세요. 에이전트 산출물을 그대로 결재선에 올리는 순간, 자동화는 리스크 관리 대상이 됩니다.
- 성공 기준을 숫자로 쓰세요. “편해졌다”가 아니라 “주간 보고서 작성 90분 → 25분”처럼요.
가성비 좋은 도구를 찾는 것보다 어려운 건, 그 도구가 실제로 일을 줄이게 만드는 설계입니다. 이번 Uber 사례가 그 설계의 좋은 참고서가 되어줄 것 같습니다.
참고 자료
- TechCrunch, “Uber puts all 30,000 employees on ChatGPT Work” (2026.10.22)
- OpenAI, “Uber brings ChatGPT Work to all employees” (2026.10.22)
- 관련 배경: Microsoft Frontier 조직 발표(2026.10.22), AWS 전방 배치 조직 투자(2026.10.20)