
OpenAI GPT 최신 소식 — GPT-6, COBOL·포트란 레거시 코드 역량 크게 올랐다 (2026.10.20)
📌 한줄 요약: 2026년 10월 19일, OpenAI가 COBOL·포트란·비주얼베이직 같은 이른바 ‘저자원(low-resource) 프로그래밍 언어’에서 GPT 최신 모델의 코딩 역량이 크게 좋아졌다고 발표했습니다. 핵심은 숫자보다 평가 도구를 함께 공개했다는 점입니다. MultiLangBench(20개 언어로 SQLite 호환 엔진을 처음부터 구현)와 COBOL 마이그레이션 평가(동작을 그대로 보존하며 다른 언어로 옮기기)를 깃허브에 풀었습니다. 결과는 GPT-6 Astra 평균 통과율 87.4%(이전 GPT-5.6 Sol 26.8%), COBOL 이전 작업은 GPT-6.1 Sol이 97.9%까지 나왔습니다. 화려한 숫자 뒤에 아직 안 풀린 부분도 같이 보입니다.
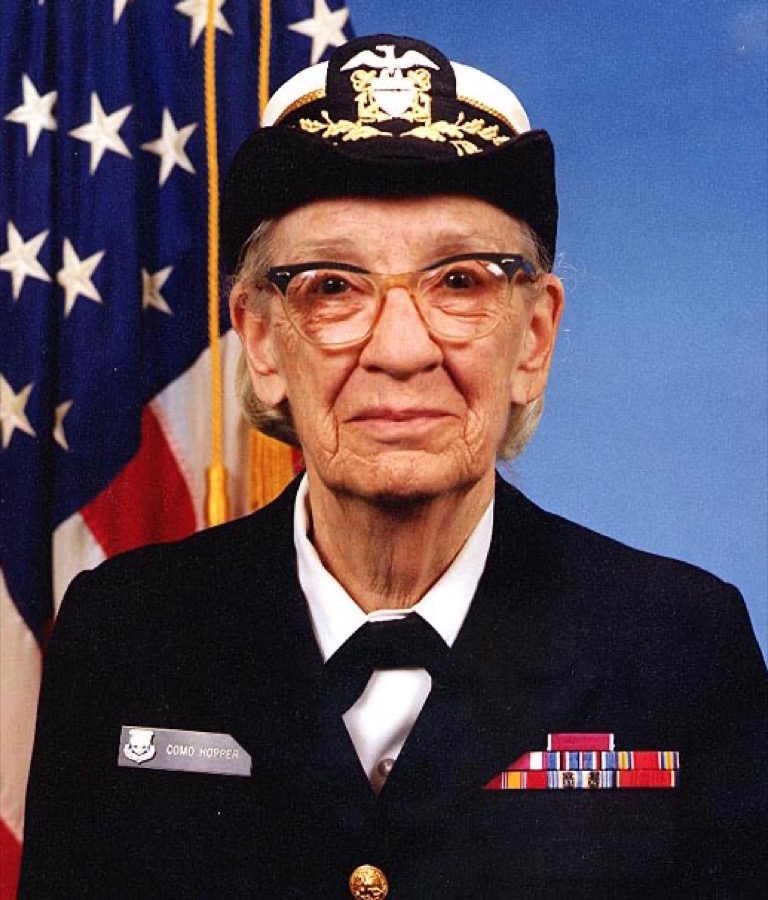 COBOL을 설계한 그레이스 호퍼 준장의 공식 초상 (출처: Wikimedia Commons, Public Domain, James S. Davis / U.S. Navy). 1950년대 컴파일러와 비즈니스 언어의 출발점을 만든 인물입니다.
은행·보험·공공 시스템을 다루는 쪽에서 일하거나, 그런 시스템을 유지보수하는 팀과 일하는 분들이라면 한 번쯤 같은 이야기를 듣습니다. “그 코드는 건드리면 안 됩니다. 돌아가고 있으니까요.” 문서는 없고, 원래 만든 사람은 퇴사했고, 바꾸려면 몇 달짜리 영향도 분석부터 해야 하는 코드. AI 코딩 도구가 아무리 좋아져도 이런 영역에서는 늘 한 발 물러서 있었습니다. 학습 데이터가 파이썬·자바스크립트에 몰려 있으니까요.
그런데 이번 발표는 정확히 그 구석진 영역을 겨눕니다. 그리고 솔직히, 처음엔 “또 벤치마크 자랑이겠지” 싶었습니다. 읽어보니 평가셋 자체를 공개한 부분이 예상 밖이었고, 97.9%라는 숫자가 뜻하는 게 생각보다 복잡했습니다.
🔎 무슨 일이 있었나 — 발표 개요
OpenAI가 2026년 10월 19일(현지시간) 공식 사이트에 올린 “Advancing coding in low-resource programming languages” 글의 내용을 정리하면 이렇습니다.
- 발표 시점: 2026년 10월 19일. 새 모델 출시가 아니라 기존 최신 모델들의 역량 측정·개선 결과 발표입니다.
- 문제 정의: COBOL·포트란·비주얼베이직은 파이썬·자바스크립트보다 학습할 코드와 문서가 훨씬 적습니다. 그런데 이 언어들이 실제로 떠받치는 건 핵심 인프라입니다.
- COBOL: 온라인 뱅킹 40% 이상, 대면 신용카드 거래 80%, ATM 거래 95% (IBM 자료 인용)
- 포트란: 일기예보, 원자로 안전 해석 등 과학·공학 계산
- 새 평가 두 가지:
- MultiLangBench — 20개 프로그래밍 언어로 SQLite 호환 데이터베이스 엔진을 처음부터 구현하는 과제
- COBOL 마이그레이션 평가 — COBOL 프로그램을 C++·자바·코틀린·파이썬·러스트로 옮기되 동작을 그대로 보존하는 과제
- 공개 범위: MultiLangBench 평가 환경과 테스트 스위트를 깃허브에 공개, 언어별 결과도 함께 공개.
- 핵심 수치: GPT-6 Astra 평균 통과율 87.4%(GPT-5.6 Sol 26.8%), GPT-6 Luna 40.3%에 API 비용 약 78% 절감, COBOL 이전은 GPT-6.1 Sol이 86.6%(낮은 추론 강도) / 97.9%(높은 추론 강도).
한 줄로 줄이면 “AI가 은행 ATM을 돌리는 그 오래된 언어를, 이제 제법 다룬다”는 발표입니다. 단, 평가 환경 안에서 그렇다는 조건이 붙습니다.
🧩 상세 분석 — 숫자를 그대로 믿으면 안 되는 이유
1. 이번 발표의 진짜 성과는 ‘점수’가 아니라 ‘자’
벤치마크 발표는 늘 조심해서 봐야 합니다. 자기가 만든 시험, 자기가 채점하는 구조니까요. 그런데 이번에는 테스트 스위트와 채점 방식까지 깃허브에 공개했습니다. 이게 실질적으로 중요한 이유는 세 가지입니다.
- 재현 가능성: 개발자가 자기 언어·자기 코드베이스 스타일로 다시 돌려볼 수 있습니다.
- 반박 가능성: 수치가 과장이라면 외부에서 바로 지적할 수 있습니다.
- 비교 기준의 표준화: 다른 모델·다른 회사도 같은 시험으로 비교할 수 있게 됩니다.
평가 방식도 꽤 실전적입니다. MultiLangBench는 데이터베이스 파일을 공통 인터페이스로 씁니다. 모델이 만든 프로그램에 초기 DB와 SQL 쿼리를 넣고, 결과 DB가 기준 SQLite 구현과 같은 내용인지 검사합니다. 언어가 뭐든 같은 테스트를 적용할 수 있는 구조입니다. SQLite의 기존 테스트 스위트를 이 형식에 맞게 각색했다고 하니, “토이 과제”보다는 긴 코딩 세션에서 실제로 돌아가는 기능을 얼마나 쌓는가를 보는 쪽에 가깝습니다.
2. COBOL 72%는 ‘자랑’이 아니라 ‘남은 숙제’
숫자를 언어별로 뜯어보면 이야기가 달라집니다. GPT-6 Astra, 최대 추론 강도 기준입니다.
| 언어 | GPT-5.6 Sol | GPT-6 Astra | 비고 |
|---|---|---|---|
| 20개 언어 평균 | 26.8% | 87.4% | 19/20개 언어에서 83% 이상 |
| COBOL | 10.9% | 72.1% | 20개 중 최저 |
| OCaml | 25.6% | 85.8% | |
| 포트란 | 21.4% | 83.5% | |
| 비주얼베이직 | 27.5% | 89.4% |
표를 보면 COBOL만 유독 낮습니다. 평균 87.4%인데 COBOL은 72.1%입니다. OpenAI도 글에서 “COBOL이 여전히 가장 어렵다”고 인정합니다. 즉 이번 발표는 “레거시도 이제 끝”이 아니라 “레거시 중에서도 COBOL은 아직 어렵다”는 고백에 가깝습니다. 실제로 은행·보험의 핵심 자산이 몰려 있는 언어가 바로 그 COBOL이라는 점을 생각하면, 가장 필요한 곳이 가장 약한 구도가 아직 남아 있습니다.
저비용 모델인 GPT-6 Luna는 평균 40.3%입니다. COBOL은 17.1%로, “싼 모델로 대충 돌린다”는 전략이 통하기 어려운 영역임을 보여줍니다.
3. 97.9%의 함정 — 평가가 ‘포화’됐다는 뜻이기도 하다
COBOL 마이그레이션 쪽 숫자는 더 극적입니다.
- GPT-5.6 Sol: 5.4% (같은 설정)
- GPT-6.1 Sol: 86.6% (낮은 추론 강도, API 비용 약 39% 절감)
- GPT-6.1 Sol: 97.9% (높은 추론 강도)
OpenAI 표현을 빌리면 “평가가 거의 포화(saturating) 상태에 이르렀다”입니다. 이건 두 가지로 읽어야 합니다.
- 좋은 쪽: 이 정도면 단순 변환 작업의 상당 부분을 자동화 후보로 올릴 수 있다는 신호입니다.
- 나쁜 쪽: 시험이 더 이상 변별력을 잃었다는 뜻이기도 합니다. 97.9%는 “실무 마이그레이션이 97.9% 해결됐다”가 아니라 “이 시험은 이제 다들 통과한다”에 가깝습니다. 다음 단계 평가는 더 크고 더 지저분한 대상으로 넘어가야 합니다.
평가의 합격 기준도 짚어둘 필요가 있습니다. 숨겨진 테스트에서 관찰 가능한 출력이 바이트 단위로 일치해야 하고, 모든 테스트를 통과해야 성공으로 칩니다. 엄격한 기준입니다. 다만 이건 “프로그램 하나” 단위입니다. 실제 차세대 사업은 프로그램 수천 개, 그리고 그 사이를 잇는 JCL·트랜잭션 미들웨어·데이터셋·문자 인코딩이 얽혀 있습니다. 단품 시험 성적이 좋다고 시스템 전체가 옮겨가지는 않습니다.
4. 현장에서 진짜 무서운 건 ‘에러’가 아니라 ‘조용히 다른 값’
OpenAI가 예로 든 부분이 실무자에게는 가장 와닿습니다. COBOL의 고정소수점 연산은 반올림을 명시하지 않으면 초과 자릿수를 버립니다. 이걸 모르고 다른 언어로 옮기면서 반올림하도록 구현하면, 프로그램은 에러 없이 잘 돌아가지만 재무 수치가 달라집니다.
이게 레거시 마이그레이션의 본질입니다. 크래시는 눈에 보이니까 고치면 됩니다. 문제는 조용히 틀린 값입니다. 그래서 OpenAI도 글에서 프로덕션 적용에는 전문가 검토와 비즈니스 규칙·의존성에 대한 테스트가 여전히 필요하다고 못 박습니다. 이 문장은 홍보 문구가 아니라 면책에 가까운 경고로 읽는 게 맞습니다.
5. 비용 구조가 바뀐다 — ‘작성’에서 ‘검증’으로
숫자에서 놓치기 쉬운 부분은 단가입니다. GPT-6 Luna는 표본당 약 0.77달러로, GPT-5.6 Sol의 3.48달러 대비 약 78% 저렴합니다. COBOL 이전도 GPT-6.1 Sol이 GPT-5.6 Sol 대비 39% 낮은 비용으로 훨씬 높은 정확도를 냈다고 합니다.
이게 의미하는 바는 “AI가 개발자를 대체한다”가 아닙니다. “코드를 쓰는 비용은 떨어지고, 그 코드가 맞는지 증명하는 비용의 비중이 커진다”입니다. 마이그레이션 프로젝트의 병목이 작성 단계에서 검증 단계로 이동합니다. 회귀 테스트, 바이트 단위 비교, 업무 규칙 대조 같은 검증 자산을 가진 조직이 유리해집니다. 반대로 “일단 AI로 바꾸고 나중에 보자”는 방식은 가장 위험한 조합이 됩니다.
⚙️ 실무에 어떻게 붙이나 — 공개된 기준으로 짜본 흐름
평가 방식이 그대로 작업 절차의 참고가 됩니다. 핵심은 “한 번에 다 옮기지 않는다”입니다.
- 단위 프로그램 목록화: 자주 바뀌고, 의존성이 적고, 테스트가 존재하는 프로그램부터 뽑습니다.
- 동작 명세 고정: 입력·출력·반올림 규칙·누락 레코드 처리 같은 업무 규칙을 문서로 못 박습니다. 이 단계를 건너뛰면 뒤에서 전부 무너집니다.
- 이전 실행: 모델에 원본과 명세를 주고 대상 언어로 옮기게 합니다. 언어는 팀이 유지보수할 수 있는 것으로 고정하세요.
- 바이트 단위 비교: 원본과 이전본에 같은 입력을 넣고 관찰 가능한 출력이 완전히 일치하는지 자동 비교합니다. OpenAI 평가가 채택한 방식입니다.
- 실패 케이스만 재작업: 전체를 다시 돌리지 말고, 어긋난 프로그램만 다시 시킵니다. 이게 비용을 줄이는 핵심입니다.
- 사람 검토: 금액·이자·수수료·세금 계산처럼 틀리면 조용히 손실이 나는 로직은 반드시 사람이 최종 확인합니다.
여기에 추론 강도(reasoning effort) 선택이 새 변수로 들어옵니다. 위 수치를 보면 낮은 강도로도 86.6%가 나오고, 높은 강도에서 97.9%까지 올라갑니다. 즉 “싸게 많이”와 “비싸게 정확히”를 작업 난이도별로 섞는 운영이 가능해집니다. 다만 이건 평가셋 기준이므로, 실제 코드베이스에서 같은 비율이 나온다고 가정하면 안 됩니다. 파일럿에서 자체 측정이 먼저입니다.
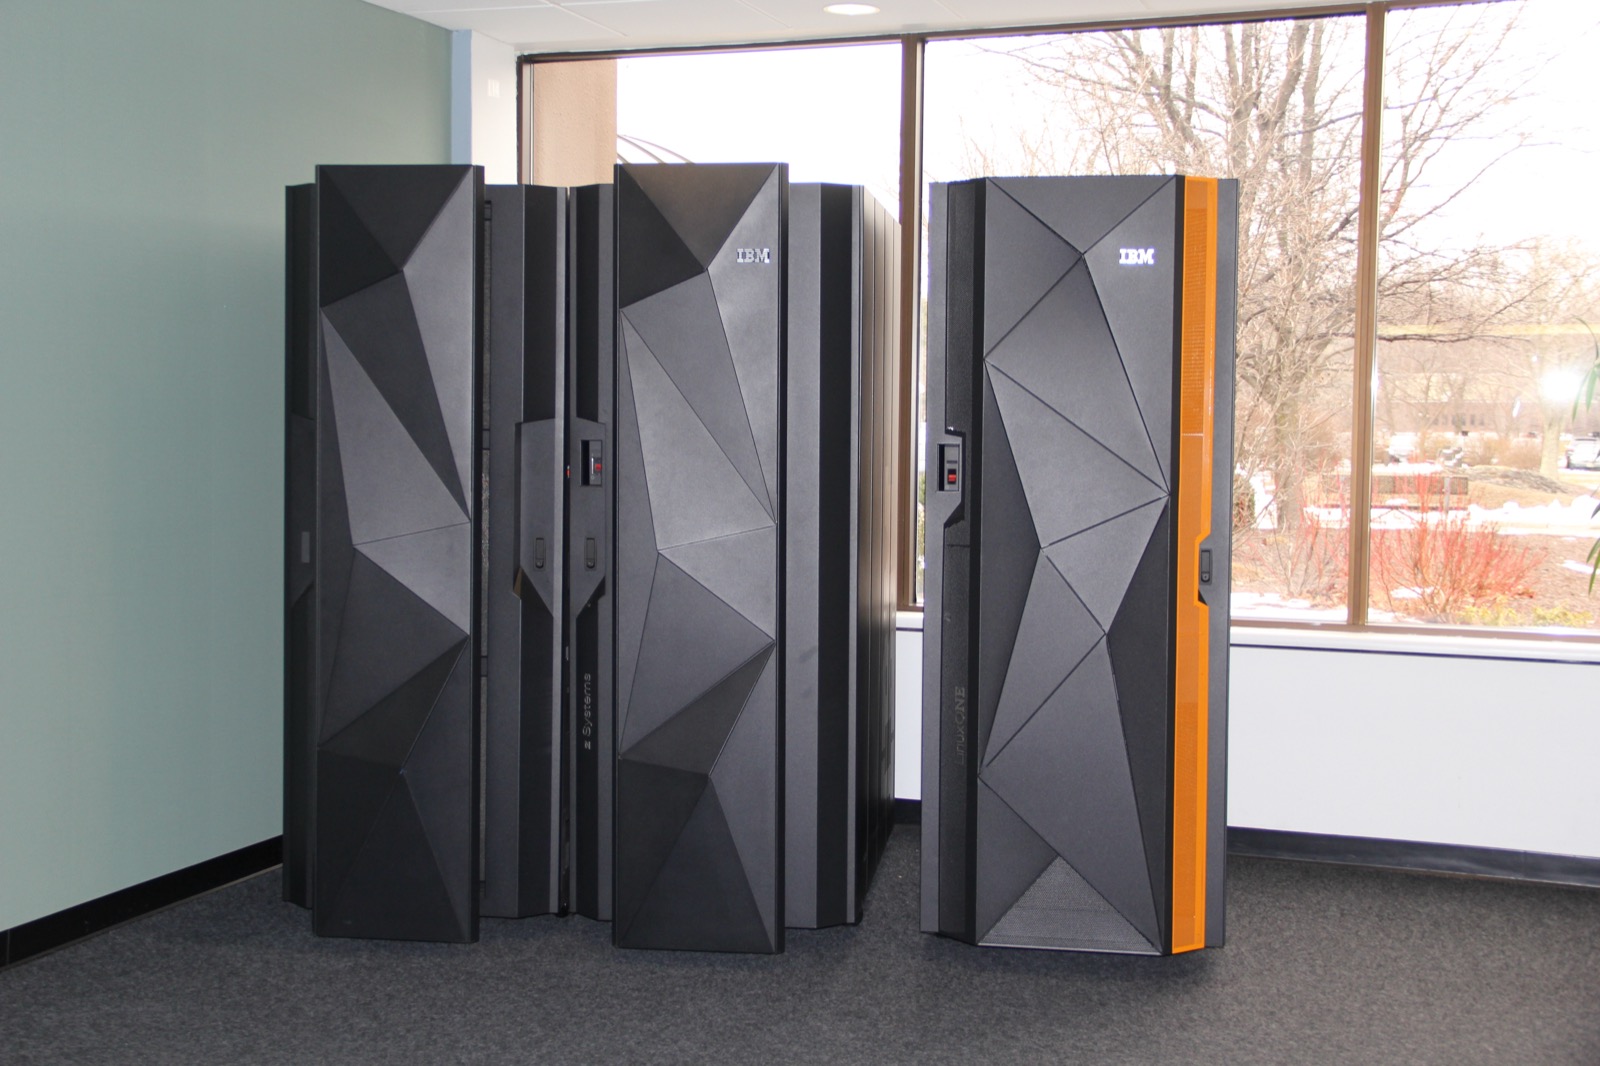 IBM z13과 LinuxONE 랙 (출처: Wikimedia Commons, CC BY-SA 4.0, Agiorgio). COBOL·포트란 코드가 실제로 도는 환경은 대개 이런 대형 시스템입니다. 제품 홍보 이미지가 아닌 참고 사진입니다.
👍 장점 — 생각보다 실무적인 부분
- 평가셋을 공개했다. 수치만 던지지 않고 테스트 스위트와 언어별 결과를 풀었습니다. 도입 검토 시 자체 검증의 출발점으로 쓸 수 있습니다.
- 저자원 언어를 정면으로 다뤘다. 그동안 AI 코딩 도구의 사각지대였던 COBOL·포트란·비주얼베이직이 평가 대상에 들어왔습니다.
- 비용이 같이 내려갔다. GPT-6 Luna의 표본당 약 0.77달러는 대량 코드 변환을 시도해 볼 수 있는 가격대입니다.
- 검증 기준이 명확하다. “바이트 단위 일치 + 전 테스트 통과”라는 엄격한 합격선을 제시해, 흔한 “그럴듯한 코드 생성”과 구분됩니다.
- 업무 자동화 파이프라인에 붙이기 좋다. 입력 고정 → 변환 → 비교 → 재작업이라는 흐름이 CI에 그대로 얹히는 구조입니다.
- 레거시 인력 리스크를 줄이는 방향. “원래 만든 사람이 없어서 못 건드린다”는 상황에서 코드를 읽고 설명해 주는 보조로 즉시 쓸 수 있습니다.
👎 단점·한계 — 솔직히 아쉬운 부분
- COBOL이 여전히 꼴찌다. 평균 87.4%인데 COBOL은 72.1%입니다. 가장 필요한 곳이 가장 약한 구도는 그대로입니다.
- 평가가 단품 프로그램 단위다. JCL, 트랜잭션 미들웨어, 데이터셋, 문자 인코딩, 외부 호출이 얽힌 시스템 단위 이전은 검증되지 않았습니다.
- 97.9%는 포화 신호다. 시험이 쉬워졌다는 뜻일 수 있어, 실무 난이도를 대변한다고 보기 어렵습니다.
- 자체 평가라는 근본 한계. 외부 재현은 가능해졌지만, 과제 설계 자체는 OpenAI가 했습니다. 어떤 실패 유형이 빠졌는지는 아직 검증되지 않았습니다.
- 조용한 오답 리스크. 반올림·누락 레코드 처리처럼 에러 없이 값만 틀리는 유형은 자동 테스트로 잡히지 않으면 그대로 남습니다.
- 여전히 사람 검토 전제. OpenAI도 프로덕션 적용에는 전문가 검토와 비즈니스 규칙 테스트가 필요하다고 명시합니다. “AI가 다 해준다”는 기대와는 거리가 있습니다.
- 모델 버전 의존. 수치는 특정 모델·특정 추론 강도 기준입니다. 모델이 바뀌면 재측정이 필요합니다.
👥 영향 — 누구에게 무엇이 달라지나
🙋 개인 사용자·비전공 기획자
- 레거시 코드를 ‘읽는’ 용도로 가치가 큽니다. 오래된 프로그램의 동작을 자연어로 설명받고 확인하는 식입니다.
- 단, 금액이 걸린 계산 로직은 그대로 믿지 마세요. 설명과 실제 동작이 어긋나는 사례가 가장 위험합니다.
- 개인 플랜에서도 최신 모델을 API로 시험할 수 있으니, 작은 프로그램 하나를 직접 변환·비교해 보는 게 가장 빠른 판단법입니다.
👨💻 개발자·자동화 운영자
- 평가셋을 직접 돌려보세요. 깃허브에 공개됐으니, 자기 팀 언어 조합에서 점수를 뽑아보면 도입 판단이 빨라집니다.
- 검증 자동화가 곧 경쟁력입니다. 바이트 단위 비교 하네스, 골든 파일, 회귀 테스트를 먼저 갖추면 모델이 좋아질수록 성과가 같이 커집니다.
- 추론 강도를 작업별로 분리하세요. 초안 변환은 낮은 강도, 금액 로직은 높은 강도로 나누는 식입니다.
- 조용한 오답 탐지를 별도 규칙으로 두세요. 출력 비교만으로는 잡히지 않는 업무 규칙 위반을 체크리스트로 관리해야 합니다.
🏢 기업·SI·금융 IT
- 차세대·시스템 개편 PoC의 문턱이 낮아졌습니다. 전체 이전이 아니라 프로그램 50~100개 단위 파일럿으로 비용·정확도를 먼저 재보는 방식이 현실적입니다.
- 검증 인력의 역할이 커집니다. 코드를 쓰는 인력보다 업무 규칙을 문서화하고 결과를 대조하는 인력의 비중이 올라갑니다.
- 감사 대응 체계가 필요합니다. “AI가 변환했다”는 사실과 어떤 테스트로 무엇을 확인했는지를 남겨야 합니다. 금융·공공은 이 기록이 없으면 배포가 어렵습니다.
- 외주 단가 구조가 흔들립니다. 단순 변환 작업의 단가가 내려가고, 검증·이행·안정화 쪽으로 비용이 이동할 가능성이 큽니다.
🌐 AI 업계
- 경쟁 축이 ‘최신 언어’에서 ‘오래된 언어’로 넓어집니다. 파이썬 벤치마크 경쟁은 이미 포화 상태이고, 남은 차별화는 기업이 실제로 가진 코드에 있습니다.
- 평가 공개가 압박이 됩니다. 한쪽이 평가셋을 공개하면, 다른 쪽도 같은 잣대로 비교됩니다.
- 레거시 현대화가 새 시장입니다. 모델 성능보다 검증 도구·이행 방법론에서 부가가치가 갈릴 가능성이 큽니다.
🔭 전망
- 단기 — 다음 평가는 ‘시스템’으로 간다. 단품 프로그램이 포화됐으니, 다음 단계는 여러 프로그램과 잡(JCL)·데이터 의존성이 얽힌 과제가 될 가능성이 큽니다.
- 단기 — COBOL 격차 축소 시도. 가장 낮은 점수를 받은 언어부터 개선 대상이 됩니다. 다음 버전에서 COBOL 점수 상승이 나올지가 관전 포인트입니다.
- 중기 — 평가의 산업 표준화. MultiLangBench가 제3자 비교 잣대로 자리 잡으면, 모델 선택 기준이 “감”에서 “내 언어 점수”로 옮겨갑니다.
- 중기 — 검증 도구 시장 성장. 마이그레이션 검증·리그레션·업무 규칙 대조를 다루는 도구와 서비스 수요가 커집니다.
- 중기 — 규제·감사 요구. 금융·공공에서 AI 변환 이력과 검증 증적을 요구하는 흐름이 강해질 수 있습니다.
- 장기 — ‘유지보수’의 정의 변화. 코드를 새로 쓰는 일보다, 오래된 코드의 의미를 복원하고 증명하는 일이 중심이 됩니다.
💡 마무리 — 지금 챙겨야 할 것
새 모델 출시 뉴스가 아니라서 헤드라인은 약합니다. 하지만 “AI가 손대지 못하던 영역”의 문턱이 내려간 소식이라, 레거시를 안고 사는 조직에는 실질적입니다. 정리하면 이렇습니다.
- 레거시를 안고 있다면: 전체 이전을 상상하지 말고, 테스트가 있는 작은 프로그램 20~30개로 파일럿을 하세요. 목표는 성공이 아니라 “우리 코드에서 몇 %가 통과하는지” 측정입니다.
- 개발자라면: 공개된 평가셋을 자기 언어 조합으로 돌려보는 것이 가장 빠른 정보 습득입니다. 블로그 요약보다 자기 숫자가 정확합니다.
- 팀·기업이라면: 변환보다 검증 자산을 먼저 만드세요. 바이트 단위 비교, 골든 파일, 업무 규칙 체크리스트 — 이 세 가지가 없으면 모델이 좋아져도 결과를 못 믿습니다.
- 비용을 보는 분이라면: “싼 모델로 대량 변환”은 초안 단계까지가 한계입니다. 금액·수수료·이자 계산은 비싼 설정 + 사람 검토로 분리하는 편이 결국 총비용이 낮습니다.
- 공통: AI가 잘하는 건 “그럴듯하게 옮기는 일”이고, 사람이 반드시 해야 하는 건 “옮긴 게 원래와 같은지 증명하는 일”입니다. 이 분업을 처음부터 전제로 잡으면 시행착오가 줄어듭니다.
가성비 좋은 선택을 찾는 분들이라면, 판단 기준은 “모델이 똑똑한가”보다 “내 코드에서 검증이 자동화되는가”입니다. 검증이 자동화되지 않는 조직에서 AI 마이그레이션은 비용만 늘고 책임만 남습니다.
참고: OpenAI 공식 발표 “Advancing coding in low-resource programming languages”(2026-10-19)와 OpenAI MultiLangBench 공개 저장소, 그리고 IBM·미국 원자력규제위원회(NRC)의 COBOL·포트란 활용 자료를 바탕으로 정리했습니다. 본문 수치는 OpenAI가 자체 설계한 평가 환경에서 측정된 값이며, 실제 사내 코드베이스에서 동일한 성능이 나온다고 보장되지 않습니다. 프로덕션 적용 전에는 자체 파일럿과 전문가 검토가 필요합니다.