
Google Gemini 최신 소식 — EmbeddingGemma 2 공개, 온디바이스 멀티모달 임베딩 (2026.10.6)
 구글 딥마인드가 2026년 10월 6일 공개한 EmbeddingGemma 2 공식 비주얼 (출처: Google DeepMind 공식 블로그)
📌 한줄 요약: 2026년 10월 6일, 구글 딥마인드가 오픈 멀티모달 임베딩 모델 ‘EmbeddingGemma 2’를 공개했습니다. Gemma 4 아키텍처 기반의 sub-1B(10억 미만) 모델로, 텍스트·코드·이미지·영상·오디오를 하나의 768차원 벡터 공간에 매핑합니다. 270M(텍스트·코드)부터 740M(전체 멀티모달)까지 모듈형으로 필요한 인코더만 메모리에 올리고, Matryoshka 표현학습(MRL) 으로 768→128차원까지 줄여 벡터 DB 저장 공간을 최대 6배 아낍니다. 픽셀 11 프로에서 전체 모델이 약 567MB RAM으로 돌아가고, 코드 검색 성능은 전작 대비 9.92점(68.76→78.68) 올랐습니다. 라이선스는 Apache 2.0입니다.
AI로 사내 문서를 찾거나, 쌓여 있는 소스코드·녹음 파일에서 원하는 부분을 검색하는 ‘검색 파이프라인(RAG)’을 운영하는 분들이라면, 임베딩 모델 선택이 곧 비용·지연(latency)·개인정보 문제로 이어진다는 걸 체감하게 됩니다. 클라우드 임베딩 API를 쓰면 데이터를 밖으로 보내야 하고, 반대로 가벼운 로컬 모델은 검색 품질이 아쉬운 경우가 많았습니다. 그 간극을 정면으로 겨냥한 오픈 모델이 나왔습니다. 무엇이 달라졌는지 정리해 보겠습니다.
🗞️ 이슈 요약 — 한눈에 보기
- 무엇이 나왔나: 구글 딥마인드가 EmbeddingGemma 2를 2026년 10월 6일 공개했습니다. 검색·분류·라우팅에 쓰이는 임베딩(embedding) 전용 모델입니다
- 성격: 작년에 나온 EmbeddingGemma 1의 후속입니다. 전작이 텍스트만 다뤘다면, 2는 코드·이미지·영상·오디오까지 한 공간으로 통합했습니다
- 기반·라이선스: Gemma 4 아키텍처 기반이며, Apache 2.0(상업적 이용 가능)으로 공개됐습니다
- 규모: 최대 740M 파라미터(sub-1B). 하지만 모듈형이라 270M(텍스트·코드) 만 올려도 동작합니다
- 핵심 기술 1 — 통합 임베딩: 텍스트·코드·이미지·영상 프레임·오디오를 하나의 768차원 벡터 공간에 매핑합니다. 별도 모델을 쇠사슬처럼 연결(chained)하던 방식을 모듈형 인코더로 대체했습니다
- 핵심 기술 2 — MRL 축소: Matryoshka 표현학습으로 출력 벡터를 768 → 512·256·128차원으로 골라 줄일 수 있습니다. 벡터 DB 저장량을 최대 6배까지 줄입니다
- 핵심 기술 3 — 확장된 컨텍스트: 8,192토큰(8K) 컨텍스트로 전작의 4배입니다. 한 번에 오디오 약 5.5분, 이미지 29장, 영상 58프레임까지 처리합니다
- 온디바이스 성능: 픽셀 11 프로 기준, 양자화 시 텍스트 전용 약 191MB, 전체 멀티모달 약 567MB의 활성 RAM으로 구동됩니다
- 품질: 코드 검색 성능이 9.92점 상승(MTEB Code 68.76→78.68). MTEB·MAEB 등에서 sub-1B급 1위 수준이며, 2배 이상 큰 전문 모델을 능가하는 항목도 있습니다
- 활용: sentence-transformers(6.1.0 이상), Hugging Face, Google AI Edge Gallery·MediaPipe 등에서 바로 실행 가능. 완전 오프라인 검색이 가능합니다
🔍 상세 분석 — 무엇이, 왜 바뀌는가
1) ‘텍스트 전용’에서 ‘만능 검색’으로
EmbeddingGemma 1은 텍스트 임베딩에 특화된 가벼운 모델이었고, 2,000만 건 이상 다운로드되며 온디바이스 검색·프라이버시 중심 RAG에 쓰였습니다. EmbeddingGemma 2의 변화는 방향이 다릅니다. 여러 모달리티를 하나의 벡터 공간으로 묶는 것이 목표입니다.
예를 들어 음성 메모로 영상 속 특정 장면을 찾거나, 텍스트 질의로 몇 시간 분량의 녹음을 검색하는 일이 단일 모델로 가능해집니다. 이전에는 모달리티별로 임베딩 모델을 따로 돌려 결과를 맞추는 구조였다면, 이제는 하나의 공간에서 유사도 비교가 됩니다. 구글은 이 모델이 Gemini Embedding 모델과 같은 기술로 만들어졌다고 설명합니다.
2) 모듈형 설계 — 필요한 것만 올린다
이번 모델의 실용적 장점은 가변 크기입니다. 전체를 다 올릴 필요 없이 쓰는 모달리티의 인코더만 로드하면 됩니다.
| 구성 | 파라미터 | 처리 대상 |
|---|---|---|
| 텍스트·코드 전용 | 270M | 텍스트, 소스코드 |
| 텍스트 + 비전 | 440M | + 이미지·문서(PDF·슬라이드·차트)·영상 프레임 |
| 텍스트 + 오디오 | 570M | + 음성·소리(원시 오디오 직접 입력) |
| 전체 멀티모달 | 740M | 텍스트·코드·이미지·영상·오디오 |
로드 시점에 vision_config·audio_config를 비활성(None) 하면 사용하지 않는 인코더는 메모리에 올라가지 않아, 가중치와 피크 메모리를 함께 절약합니다. 또 Gemma 4와 텍스트 토크나이저·오디오 인코더를 공유하기 때문에, Gemma 4와 EmbeddingGemma 2를 함께 쓰는 온디바이스 RAG 파이프라인에서는 전체 메모리 사용량이 더 줄어듭니다.
3) 저장 공간을 ‘골라서’ 줄이는 MRL
검색 파이프라인에서 조용히 부담이 되는 것이 벡터 DB 용량입니다. 임베딩을 많이 만들수록 저장·메모리 요구량이 커지기 때문입니다. EmbeddingGemma 2는 Matryoshka 표현학습(MRL) 로 벡터 앞부분을 잘라내도 품질을 상당 부분 유지합니다. 구글에 따르면 256차원으로 줄여도 텍스트·코드 품질 대부분을 유지하고, 이미지·영상·음성 검색은 약 95% 수준을 지킵니다. 차원을 낮추면 저장량과 검색 속도가 함께 개선됩니다.
4) 품질과 벤치마크 — ‘작은데 강하게’
가장 눈에 띄는 개선은 코드 검색입니다. MTEB(Code) 점수가 68.76에서 78.68로 9.92점 올라, 로컬 코드베이스 인덱싱·시맨틱 코드 검색·코딩 에이전트의 검색 단계에 특히 적합해졌습니다. 여기에 더해 MTEB(텍스트)·MAEB(오디오) 등에서 sub-1B급 최상위 성능을 기록했고, 2배 이상 큰 전문 모델을 앞서는 항목도 있다고 밝혔습니다.
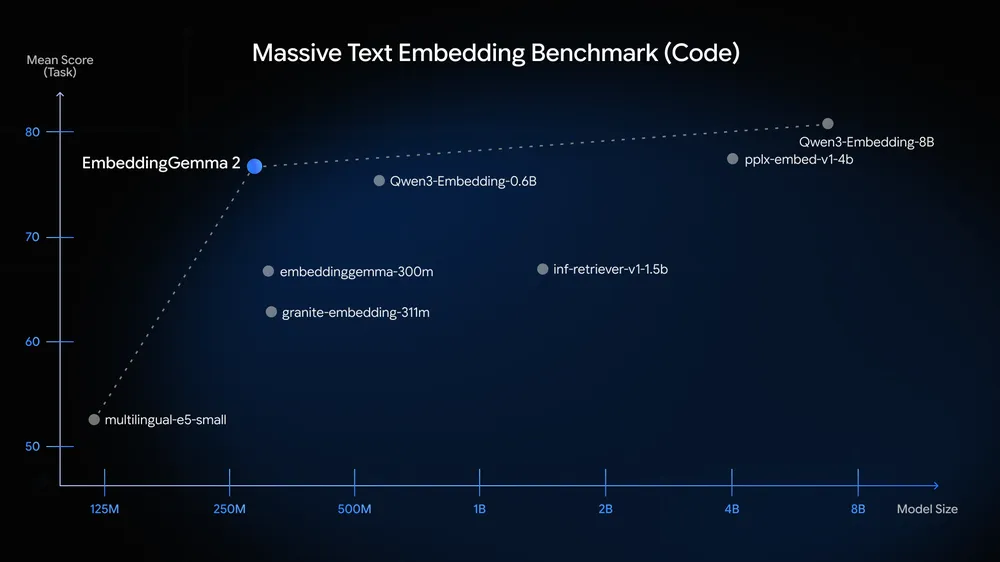 EmbeddingGemma 2 공식 벤치마크 자료(텍스트 임베딩) — sub-1B급 최상위 수준을 기록했습니다 (출처: Google DeepMind 공식 블로그 / Google)
5) ‘오프라인’이 기본값이 된다
구글의 강조점은 프라이버시와 지연입니다. 임베딩을 기기 안에서 계산하면 데이터 외부 전송이 없고, 네트워크 왕복이 사라져 파이프라인 지연이 줄어듭니다. 구글은 Google AI Edge Gallery의 ‘Instant Media Search’, ‘Video Moments Finder’, AI Edge Foresight 앱, MediaPipe 기반 실시간 분류·라우팅 예시까지 함께 공개하며 엣지(edge) 활용을 밀고 있습니다.
📉 영향 — 사용자·개발자에게 뭐가 달라지나
개발자·운영자 입장에서 실무 포인트는 셋입니다. 첫째, 임베딩 파이프라인을 로컬로 내릴 선택지가 생겼습니다. 민감한 문서·음성·영상을 다루면서 데이터 반출 없이 검색을 구현하려는 팀에게는 설계가 단순해집니다. 둘째, 비용 구조가 바뀝니다. 클라우드 임베딩 API 과금을 온디바이스 추론으로 대체하면 토큰당 비용이 사라지는 대신 기기 자원·전력이 새 변수가 됩니다. 셋째, 마이그레이션 시 차원 설계를 재점검할 필요가 있습니다. MRL로 768→256·128차원 축소가 가능해진 만큼, 기존 벡터 DB의 차원·인덱스 설정과 재색인(re-index) 계획을 함께 따져야 합니다. 참고로 이번 모델은 임베딩·검색 계층이고, 생성을 담당하는 Gemma 4와 짝을 이룰 때 온디바이스 RAG가 완성됩니다.
일반 사용자 입장에서는 체감이 조금 늦게 옵니다. 다만 인터넷 없이도 기기 안 사진·영상·녹음을 의미 기반으로 검색하는 기능이 확산되면, 개인정보를 서버로 보내지 않고 검색하는 경험이 늘어납니다. 오프라인 환경이나 데이터 반출이 어려운 업무 현장에서 특히 의미가 있습니다.
업계 관점에서는 오픈·온디바이스 진영의 ‘작지만 강한 모델’ 경쟁이 한 단계 올라간 신호입니다. 클라우드 대형 모델 중심이던 검색·RAG 계층이 엣지로 내려오는 흐름이 가속될 수 있습니다.
🔭 전망
짚어볼 지점은 세 가지입니다. 첫째, 온디바이스 RAG의 대중화입니다. 임베딩(검색) + 생성(Gemma 4)이 같은 토크나이저를 공유하며 기기 안에서 도는 조합이 갖춰졌다는 점에서, 폐쇄망·개인정보 민감 환경의 도입이 늘어날 수 있습니다. 둘째, 오픈 임베딩 경쟁입니다. 검색 품질과 저장 효율은 RAG 품질을 좌우하는 핵심이라, 다른 진영의 오픈 임베딩 모델과 차원·성능·라이선스 경쟁이 이어질 전망입니다. 셋째, 파이프라인 재설계 수요입니다. 모달리티를 하나로 묶는 통합 임베딩은 기존의 다중 모델 구조를 단순화하는 대신, 차원·저장·색인 전략을 다시 짜게 만듭니다.
🧭 정리 & 참고 팁
- 핵심 한 줄: 2026년 10월 6일 공개된 EmbeddingGemma 2는 텍스트·코드·이미지·영상·오디오를 한 벡터 공간에 담는 오픈(Apache 2.0) 온디바이스 임베딩 모델입니다
- 검색·RAG를 운영한다면: 데이터 반출이 어렵거나 지연이 중요한 파이프라인이라면, 로컬 임베딩으로 내리는 선택지를 검토해 볼 만합니다
- 도입 검토 시: MRL 축소(768→256·128차원) 로 저장·속도를 잡고, 기존 벡터 DB 차원·재색인 비용을 함께 계산하세요
- 메모리 계획: 텍스트 전용 270M(약 191MB RAM) ↔ 전체 740M(약 567MB RAM) 사이에서 쓰는 모달리티만 로드하면 자원을 아낍니다
- 참고: 본문은 2026년 10월 6일 Google DeepMind·Google Developers 공식 발표와 EmbeddingGemma 2 모델 카드·개발자 가이드, 관련 보도를 정리한 것입니다. 파라미터·벤치마크·메모리 수치는 측정 환경에 따라 달라질 수 있으니, 실제 도입 전 공식 모델 카드와 저장소(Hugging Face 등) 문서를 직접 확인하시길 권합니다.
참고: 이 글은 2026년 10월 6일(미국 현지시간) 구글 딥마인드 공식 발표를 바탕으로 작성했습니다. 벤치마크 점수·메모리 사용량은 기기·양자화·설정에 따라 차이가 날 수 있습니다.