
OpenAI GPT 최신 소식 — 미공개 차세대 모델이 쏟아낸 수학 논문 722편, 하루 만에 3편 철회 (2026.10.9)
📌 한줄 요약: 2026년 10월 6일(현지시간), OpenAI가 미공개 내부 프런티어 모델이 생성한 수학 논문 722편(372개 결과군) 을 오픈소스 저장소
openai/math에 공개했습니다. 그런데 하루 만인 10월 7일, 부호(sign) 오류가 발견되며 논문 3편이 철회되고 14편이 수정됐습니다. 공개 시점 기준 상위 결과의 약 42%만 Lean 형식 검증을 통과했고, 모델 자체는 공개되지 않아 외부인이 다시 돌려볼 수 없습니다. “AI가 수학을 한다”는 뉴스가 쏟아지는 가운데, 이번 사건은 성과보다 ‘검증’이 핵심 쟁점이라는 걸 보여줍니다. 아래에서 무엇이 공개됐고, 무엇이 문제였는지 살펴봤습니다.
 OpenAI 공식 저장소 openai/math — 미공개 모델이 생성한 수학 논문 722편 공개 (출처: GitHub · OpenAI)
요즘 AI로 문서를 정리하거나 코드를 짜는 분들이라면, “AI가 이제 수학 논문까지 쓴다”는 소식을 한 번쯤 보셨을 겁니다. 문제는 그 논문이 정말 맞는지를 사람이 확인하기가 만만치 않다는 점이죠. 이번 OpenAI 사건은 바로 그 지점을 정면으로 건드립니다. 거대한 결과물을 쏟아낸 다음, 하루 만에 스스로 오류를 찾아 논문을 내리는 장면이 공개적으로 벌어졌기 때문입니다.
자동화 파이프라인을 운영하는 입장에서 보면, 이 사건은 “생성”보다 “검증”이 병목이라는 걸 그대로 보여줍니다. OpenAI 공식 발표와 openai/math 저장소, Unite.AI·Implicator·Shattered 등 보도를 바탕으로 정리해 봤습니다.
이슈 요약 — 무엇이 일어났나
결론부터 정리하면 이렇습니다.
- 공개일: 2026년 10월 6일 (현지시간)
- 무엇을: 미공개 내부 프런티어 모델이 생성한 수학 논문 722편을 372개 결과군(family) 으로 묶어 GitHub 저장소
openai/math에 공개 (Apache-2.0 라이선스) - 함께 공개된 것: Lean 형식 증명(formalization) 다수와 모델의 추론 요약 10편
- 철회·수정: 공개 하루 뒤인 10월 7일, 부호(sign) 오류로 논문 3편 철회, 14편 수정, 13편의 참조 갱신
- 검증 현황: 공개 시점 기준 상위 결과 719편 중 약 300편(약 42%)만 기계 검증(Lean) 통과
- 컴퓨트: 약 4,000개 문제를 풀렸고, 결과 1건당 평균 약 3시간 분량의 ChatGPT Pro 추론 컴퓨트 투입
- 모델은 비공개: OpenAI는 모델 이름도, API도 공개하지 않았고, 외부인은 결과를 재현할 수 없음
- 이름 논란: 커뮤니티에서 “GPT-7 ‘Bel’“ 로 부르지만, OpenAI는 그런 이름을 붙이지 않음(루머)
정리하면 “새 모델 발표”가 아니라 “결과물 공개” 입니다. 이름도 없는 모델이 만든 방대한 논문 묶음이 곧바로 정정 절차를 밟은 사건입니다.
상세 분석 — 안을 뜯어보면
① 무엇이 공개됐나 — 722편, 372개 결과군
핵심은 소위 ‘정답’ 722개가 아니라 372개 결과군이라는 점입니다. 저장소는 관련 논문을 하나의 결과군으로 묶고, 각 군을 수학 분야별로 분류합니다.
- 결과군(family): 주 결과 하나에 보조 논증·따름정리·대안 증명이 함께 묶인 단위
- 722편 → 372군: 숫자가 크게 보이지만, 서로 다른 논증의 수는 372개라는 뜻
- Lean 형식 증명: 증명 보조기 Lean으로 옮긴 결과들이 포함 — 사람의 눈이 아니라 소프트웨어가 논리 단계를 검증
- 추론 요약 10편: 모델이 어떤 경로로 답에 도달했는지 요약한 자료
- 평가 맥락: 기존 수학 벤치마크가 포화되자, 열린 연구 문제 약 4,000개로 평가를 확장
여기서 Lean이 결정적입니다. Lean은 증명을 컴퓨터가 단계별로 검사할 수 있는 형태로 강제합니다. 자연어 논문만 있으면 사람이 읽고 판단해야 하지만, Lean 증명이 붙으면 논리 자체를 기계가 확인합니다.
② 하루 만의 정정 — 부호 오류가 부른 연쇄 철회
이번 사건에서 가장 중요하게 봐야 할 대목은 정정 절차입니다.
- 10월 6일: 722편 공개
- 10월 7일: 부호(sign) 오류 발견 → 관련 논문 3편 철회
- 「Algebraicity of Weil classes on split abelian eightfolds」 — 부호 오류가 안정화 흔적 상쇄(stabilization-trace cancellation) 논증을 무효화
- 위 결과에 의존하던 2편(K3 곡면 관련 Kuga–Satake 대응, K3 곡면 곱의 유리 Hodge 추측)도 함께 철회
- 같은 날: 14편 수정(증명 보강·진술 정정), 13편의 참조 갱신
- 결과: 카탈로그가 722편 → 719편으로 조정
숫자 자체는 작습니다. 하지만 의미는 큽니다. “논문을 대량으로 뽑아내는 것”과 “그 논문이 맞는 것”은 전혀 다른 문제라는 걸, 하루 만에 스스로 증명한 셈입니다. 동시에 철회 이력까지 공개한 투명성은 평가할 만한 부분입니다.
③ 검증의 벽 — 42%만 기계 검증 통과
OpenAI 스스로 인정한 한계도 분명합니다.
- 상위 결과 719편 중 약 300편(42%) 만 Lean 형식 검증 완료
- 형식화되지 않은 결과는 문제가 있을 수 있다고 저장소가 명시
- 모델은 비공개 — 외부인은 결과를 재현하거나 반박 실험을 하기 어려움
- 대표 발언: “거의 모든 결과가 단일 에이전트에 대한 단일 프롬프트에서 나왔다” — 다만 모델이 비공개라 외부에서 검증 불가
- 프롬프트는 미공개: 평균 컴퓨트만 공개했고, 프롬프트는 공개하지 않음
즉 “검증된 것(42%)”과 “아직 모르는 것(58%)”이 섞여 있는 묶음입니다. 화려한 헤드라인 뒤에 검증 격차가 그대로 남아 있습니다.
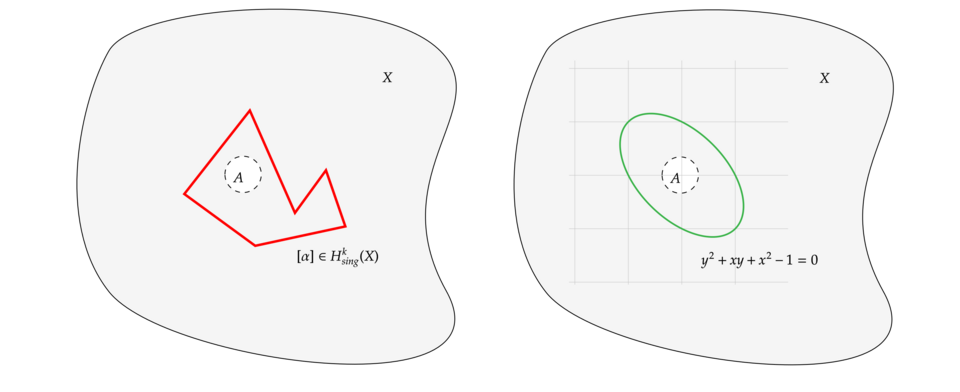 Hodge 추측 도해 — 철회된 논문들이 다룬 주제 중 하나 (출처: Wikimedia Commons, CC BY-SA 4.0, Tazerenix)
④ 헷갈리기 쉬운 지점
- “새 모델 출시”가 아니다: 모델은 이름도 API도 없이 비공개입니다
- “GPT-7”은 붙인 이름이 아니다: ‘Bel’·’GPT-7’은 커뮤니티·언론의 별칭이고 OpenAI의 공식 명칭이 아닙니다
- “리만 가설·나비에-스토크스 해결”이 아니다: 저장소는 그런 주장을 하지 않으며, 관련 주장은 별개입니다
- 722는 “문제 722개”가 아니다: 논문 722편 / 결과군 372개이고, 현재는 719편으로 조정됐습니다
장점과 아쉬운 점(단점)
장점
- 공개 검증 자료: Lean 형식 증명과 저장소를 통째로 공개해, 누구나 직접 읽고 검사할 수 있습니다
- 정정의 투명성: 오류를 찾아 논문을 철회·수정하고 이력을 남긴 절차 자체가 신뢰 자산입니다
- 평가 규모: 약 4,000개 열린 문제에 도전한 대규모 실험 데이터를 남겼습니다
- 오픈 라이선스: Apache-2.0으로 재사용·연구가 자유롭습니다
아쉬운 점
- 재현 불가: 모델이 비공개라 외부 검증·반박 실험이 사실상 막혀 있습니다
- 검증 격차: 58%는 아직 형식 검증 전 — “미검증”과 “오류”를 구분하기 어렵습니다
- 프롬프트 미공개: 단일 프롬프트 주장을 외부에서 확인할 수 없습니다
- 과장 위험: “722편”이라는 숫자가 곧 성과로 읽히기 쉽습니다
- 하루 만의 철회: 대량 생성 결과물의 신뢰성이 아직 성숙하지 않다는 신호이기도 합니다
영향 — 사용자와 개발자에게
일반 사용자에게
- 이번 건은 ChatGPT 기능 업데이트가 아닙니다. 지금 바로 쓸 수 있는 새 모델이나 요금 변화는 없습니다.
- “AI가 수학 논문을 쓴다”는 뉴스를 볼 때, “몇 편 중 몇 편이 검증됐는지” 를 함께 보는 습관이 도움이 됩니다.
- 연구 결과물을 인용할 일이 있다면, 철회·수정 이력이 붙었는지 먼저 확인하는 게 안전합니다.
개발자·자동화 담당자에게
- 이번 사건의 교훈은 “생성”보다 “검증 파이프라인” 입니다. 결과물을 대량으로 뽑는 자동화를 운영한다면, 자동 검증 단계(형식 검사·테스트·린트) 를 파이프라인에 넣는 게 핵심입니다.
- AI 에이전트를 실사용하는 입장에서, “에이전트가 낸 결과를 무엇으로 검증할지” 를 정하지 않으면 검증되지 않은 산출물이 쌓입니다. Lean이 수학에서 하는 역할을, 코드에서는 타입 검사·테스트가 합니다.
- 재현성 없는 자동화는 위험합니다. 모델·프롬프트·버전을 로그로 남겨 나중에 같은 결과를 다시 만들 수 있어야 합니다.
업계에
- 경쟁 축이 “누가 더 많이 생성하나”에서 “누가 더 많이 검증하나” 로 이동하는 신호입니다.
- 형식 검증(Lean 등)을 붙인 진영이 신뢰 경쟁에서 유리해질 가능성이 큽니다.
전망
세 가지를 봅니다.
- 검증 중심 경쟁이 심화된다. 결과 편수보다 “기계 검증 통과율” 이 성적표가 되는 방향으로 갈 가능성이 큽니다.
- 재현성 압력이 커진다. 모델을 숨긴 채 결과만 공개하는 방식에 대해 “프롬프트·버전을 공개하라” 는 요구가 이어질 겁니다.
- 정정 이력이 신뢰 자산이 된다. 오류를 스스로 찾아 공개하는 관행이 자리 잡으면, 철회 이력을 투명하게 남기는 쪽이 장기적으로 유리해집니다.
마무리 — 이런 분께 추천
정리하면, 이번 OpenAI 미공개 모델의 수학 논문 722편 공개와 하루 만의 3편 철회는 “AI가 만든 결과물을 어떻게 검증할 것인가”에 관심 있는 분들께 읽어볼 만한 사건입니다. 특히 AI 자동화 파이프라인을 운영하거나, AI 산출물을 업무에 쓰는 분이라면 시사점이 큽니다.
체크 포인트를 드리면 이렇게 보시면 됩니다.
- 숫자보다 검증률을 보기: “몇 편”이 아니라 “몇 편이 검증됐나(약 42%)” 를 함께 확인
- 재현성 확인: 결과를 다시 만들 수 있는지, 모델·프롬프트·버전이 공개됐는지 체크
- 정정 이력 확인: 인용 전에 철회·수정 표시가 있는지 확인
- 내 자동화에 대입: 생성 단계 옆에 검증 단계를 두고 있는지 점검
솔직히 “AI가 수학 논문 722편을 쏟아냈다”는 헤드라인만 보면 대단해 보입니다. 하지만 실제로 중요한 건 하루 만에 3편이 내려갔다는 사실과 42%만 검증됐다는 숫자입니다. 생각보다 검증과 재현성이 이 이야기의 진짜 주인공이라, AI로 결과물을 대량 생산하는 분들이라면 한 번쯤 자기 파이프라인에 대입해 보시길 권합니다.
참고 출처: OpenAI 공식 발표(Sharing AI progress in mathematics, 2026.10.6), 오픈소스 저장소 openai/math(GitHub, Apache-2.0), Unite.AI(2026.10.6), Implicator.ai(2026.10.8), Shattered.io(2026.10.7) 등. 논문 편수·검증률·철회 내역은 OpenAI 저장소 및 언론 보도 인용이며, ‘GPT-7/Bel’ 명칭은 공식 명칭이 아닌 커뮤니티 별칭입니다. 이미지 출처는 각 이미지 캡션에 표기했습니다.