
OpenAI GPT 최신 소식 — 텍스트 워터마킹 'textGrain' 발표, EU AI Act 대응·API 옵트인 개시 (2026.10.6)
📌 한줄 요약: 2026년 10월 5일(현지시간), OpenAI가 EU AI Act(유럽 AI법)의 텍스트 출처 표기(provenance) 요구에 대응해 자체 텍스트 워터마킹 기술 ‘textGrain’ 을 공개했습니다. 전 세계 API 고객은 옵트인(opt-in)으로 특정 모델에 켤 수 있고(기본값은 꺼짐), EU의 ChatGPT·Codex에는 향후 몇 주간 전 플랜에 보이지 않는(invisible) 워터마크가 자동 삽입됩니다. 검출기는 승인된 연구자·전문기관 신청 방식으로만 열립니다. OpenAI는 자체 평가에서 400토큰 문장의 약 95%를 검출했지만, 단어 25%를 바꾸면 검출률이 17%로 급락하는 한계도 함께 공개했습니다.
AI로 만든 문장을 제품·업무 문서에 붙여 쓰는 분들이라면, 이런 질문을 한 번쯤 하게 됩니다. “이 텍스트가 AI가 쓴 건지, 나중에 누가 어떻게 구분할 수 있을까?” 사용자가 늘수록, 그리고 규제가 촘촘해질수록 ‘누가 썼는가’를 기계가 읽을 수 있게 만드는 문제가 조용히 중요해집니다. 이번 주 그 첫 번째 큰 규칙이 유럽에서 구체화됐습니다.
이번 글은 새 모델 출시나 가격 인하 소식이 아니라, OpenAI가 텍스트 워터마킹을 어떻게, 어디에, 언제 적용하는지에 대한 정책·기술 발표를 정리합니다. 무엇이 새로 나왔는지, 실제로 어떻게 동작하고 어떤 한계가 있는지, 그리고 사용자와 개발자에게 무엇이 달라지는지 짚어 보겠습니다.
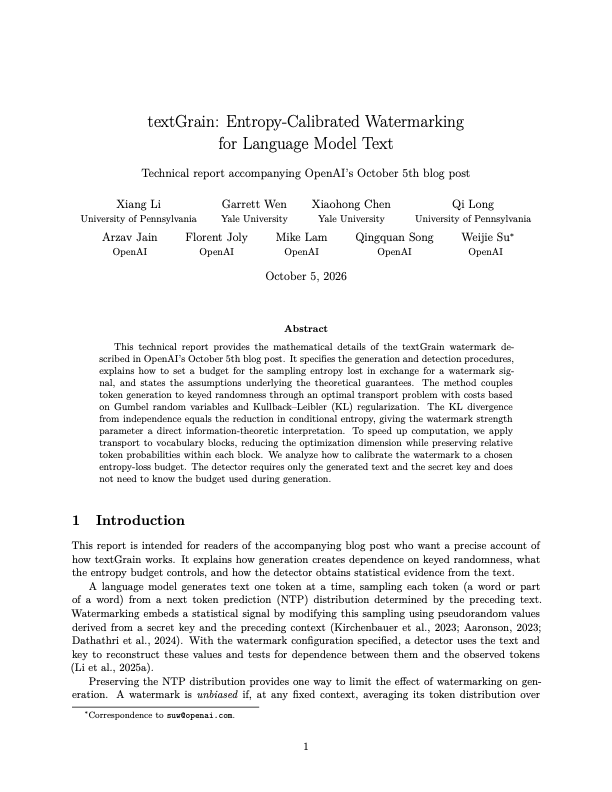 OpenAI 공식 ‘textGrain’ 기술 보고서 표지 (출처: OpenAI 공식 기술 보고서, cdn.openai.com, 2026년 10월 5일)
이슈 요약 — 무엇이 새로 나왔나
먼저 결론부터 정리하면 이렇습니다.
- 무엇을: OpenAI가 텍스트 워터마킹 기술 ‘textGrain’ 을 공개했습니다. 모델이 단어를 고르는 방식에 보이지 않는 통계적 신호를 심어, 나중에 검출기가 그 신호를 찾아 AI가 만든 텍스트인지 판별하는 방식입니다.
- 왜: EU AI Act가 생성형 AI 사업자에게 “생성된 텍스트를 기계가 읽을 수 있는 방식으로 식별 가능하게 만들 것” 을 요구합니다(투명성 의무, 이른바 Article 50 계열). OpenAI는 이 요구에 맞춘 단계적 접근을 내놨습니다.
- 누구에게, 언제:
- API 고객(전 세계): 10월 5일부터 특정 모델에 옵트인으로 워터마킹 활성화 가능. 기본값은 꺼짐(off).
- EU의 ChatGPT·Codex 사용자: 향후 몇 주간, 모든 플랜에 보이지 않는 워터마크가 자동 삽입(EU 한정).
- 연구자·전문기관: 10월 5일부터 검출기 사용 신청 접수. 초기에는 승인된 기관만, 사안별(case-by-case)로 허용.
- 검출기는 공개 안 함: 오탐(false positive)과 미탐(false negative) 위험 때문에 검출기는 일반 공개하지 않고, 연구·검증 목적의 승인 기관에만 엽니다.
- 기술 보고서: 같은 날 “textGrain: Entropy-Calibrated Watermarking for Language Model Text” 라는 기술 보고서를 공개했습니다. 저자에는 펜실베이니아대·예일대·OpenAI 소속 연구자들이 이름을 올렸습니다.
한마디로, “AI 텍스트를 사후에 식별할 수 있게 만드는 장치” 를 OpenAI가 유럽 규제에 맞춰 공식화한 사건입니다.
 OpenAI 로고 (출처: Wikimedia Commons, 퍼블릭 도메인)
상세 분석 — textGrain은 어떻게 동작하나
핵심은 “문장을 겉으로 바꾸지 않고, 통계적 흔적만 남긴다” 는 점입니다.
- 동작 원리: textGrain은 모델이 다음 단어를 고를 때의 무작위성(엔트로피) 에 비밀 키에서 파생된 규칙을 섞습니다. 사람 눈에는 문장이 자연스럽게 보이지만, 검출기는 그 규칙이 남긴 통계적 패턴을 찾아냅니다. 이름 그대로 엔트로피 보정(entropy-calibrated) 방식입니다.
- 성능(OpenAI 자체 테스트): 오탐률 1% 기준으로, 200토큰 문장은 약 80%, 400토큰 문장은 약 95% 를 검출했습니다(심리학 등 일반 텍스트 기준). 반면 수학처럼 단어 선택의 자유도가 낮은 글은 검출률이 크게 떨어졌습니다.
- 편집에 약함: 이게 가장 중요한 한계입니다. 400토큰 문장에서 단어 10%를 동의어로 바꾸면 검출률이 약 92% → 66%로, 25%를 바꾸면 17%로 떨어졌습니다. 즉 조금만 손보면 워터마크는 거의 사라집니다.
- 품질 영향은 없음: OpenAI는 자사 최신 프런티어 모델(Astra) 벤치마크에서 워터마크를 켜든 끄든 의미 있는 성능 차이가 없었다고 밝혔습니다.
- 워터마크가 말해주지 않는 것: OpenAI가 명시한 한계는 다음과 같습니다.
- 인간의 기여도를 측정하지 않음(AI가 얼마나, 사람이 얼마나 기여했는지는 모름)
- 소유권·책임을 확정하지 않음(누가 소유자인지, 사용이 적법했는지 판단하지 않음)
- 사용자를 식별하지 않음(누가 썼는지 알려주지 않음)
- 사실 여부를 검증하지 않음(내용이 참인지 거짓인지 판단하지 않음)
- 미검출이 곧 사람 작성 증명은 아님(짧거나 편집·번역된 텍스트는 못 잡을 수 있음)
정리하면, textGrain은 “AI가 개입했다는 약한 신호” 를 남기는 도구이지, “저작권·책임을 판정하는 만능 심판” 은 아니라는 것입니다.
 유럽의회(European Parliament) 브뤼셀 청사 (출처: Wikimedia Commons, CC BY-SA 4.0, Steven Lek)
배경 — 왜 EU에서 먼저인가
- EU AI Act의 투명성 의무: EU AI Act는 생성형 AI 사업자에게 생성 텍스트를 기계 판독 가능하게 식별하도록 요구합니다. OpenAI는 이 요건에 맞춰 텍스트 출처 표기(text provenance) 정책을 정리한 것입니다.
- EU 행동규약(Code of Practice) 서명: OpenAI는 2026년 6월 AI 생성 콘텐츠 투명성 관련 EU 행동규약에 서명했습니다. 이번 검출기 접근도 그 규약에 따라 사안별 승인 방식으로 운영됩니다.
- 지역 한정으로 시작: OpenAI는 이번에 워터마킹을 전 세계 기본값으로 만들지 않았습니다. EU에서만 먼저 적용하고, 실사용 데이터와 피드백을 보고 확장 여부를 판단하겠다는 것입니다.
- 레이어드 전략의 연장: OpenAI는 이미 이미지·오디오에는 C2PA 규격의 Content Credentials와 SynthID 워터마크를, 그리고 openai.com/verify·Content Provenance API 같은 검증 도구를 운영해 왔습니다. 이번 textGrain은 그 ‘출처 표기’ 전략을 텍스트로 확장한 것입니다.
- 경쟁사 흐름: Anthropic은 2026년 8월 전 세계 대상 텍스트 워터마킹을 도입했고, 구글은 이미 SynthID 계열 워터마킹을 운영해 왔습니다. 즉 주요 프런티어 랩이 ‘텍스트 출처 표기’로 수렴하는 흐름 속에서 OpenAI가 합류한 셈입니다.
영향 — 사용자와 개발자에게 무엇이 달라지나
일반 사용자 관점
- 눈에 보이는 변화는 없음: 워터마크는 비가시적이라 답변 품질이나 모양은 그대로입니다. 다만 EU 사용자의 ChatGPT·Codex 출력물에는 통계적 흔적이 남는다는 점이 다릅니다.
- “내 글을 AI가 썼다고 판정될 수 있다”: 규제·플랫폼이 검출기를 쓰기 시작하면, 사람이 다듬은 글도 AI 신호가 남아 있을 수 있습니다. 반대로 워터마크가 없다고 해서 사람이 쓴 글로 증명되는 것도 아닙니다.
- 지역 차이: 이번 계획에서 EU 밖 사용자의 ChatGPT·Codex에는 자동 적용되지 않습니다. 같은 서비스라도 지역에 따라 텍스트 출처 신호가 달라질 수 있다는 뜻입니다.
개발자·기업 관점
- API는 기본 꺼짐 → 선택은 개발자 몫: API 워터마킹은 옵트인입니다. EU 고객을 상대하는 제품이라면 자사의 투명성 의무를 어떻게 채울지를 두고 켤지 말지를 직접 결정해야 합니다. 클라우드 파트너를 통한 모델 출력에도 순차 적용될 예정입니다.
- 검출기를 아직 직접 쓸 수 없음: 검출기는 승인된 연구자·전문기관에만 열립니다. 즉 개발자가 “내 출력에 워터마크가 잘 박혔는지” 스스로 검증하기 어렵습니다. 자체 검증 파이프라인을 만드는 팀이라면 이 공백을 염두에 둬야 합니다.
- 오픈소스 계획: OpenAI는 textGrain 기술을 오픈소스로 공개할 계획이라고 밝혔습니다. 이게 풀리면 자체 검출·검증 도구를 만들 여지가 생깁니다.
- 편집 취약성 = 설계 리스크: 단어 25%만 바꿔도 검출률이 17%로 떨어진다는 건, 워터마킹을 ‘컴플라이언스 만능 카드’로 기대하면 안 된다는 신호입니다. 규제 대응을 설계할 때 워터마크 + 정책 + 감사 로그를 함께 보는 레이어드 접근이 필요합니다.
- 자동화 파이프라인 운영 팁: 대량 텍스트를 생성·가공하는 자동화 파이프라인을 굴리는 환경이라면, 입력·출력에 어떤 모델이 쓰였고 어떤 후처리(편집·번역)를 거쳤는지 로그로 남겨 두는 것이 결국 규제 대응 비용을 줄입니다. 워터마크는 편집에 약하지만, 자체 기록은 편집에 강합니다.
전망
- 단기(몇 주): EU ChatGPT·Codex에 비가시 워터마크가 순차 적용되고, 검출기 승인 절차가 가동됩니다. API 옵트인도 이미 열려 있습니다. 클라우드 파트너 경유 출력으로도 확대될 예정입니다.
- 중기(수개월): 오픈소스 공개, 검출기 접근 확대, AI Act 행동규약 이행 점검이 맞물립니다. 검출 신뢰도가 어느 정도 올라가면 전 세계 기본값(global default)으로의 전환 논의가 본격화될 수 있습니다.
- 구조적: 이번 발표의 본질은 “AI 텍스트를 규제 가능한 대상으로 만드는 첫 층” 입니다. 다만 편집·번역에 약한 워터마크의 한계는 기술만으로 메울 수 없어, 표준·정책·검증 도구를 겹치는 레이어드 방식이 당분간 주류가 될 가능성이 큽니다.
- 한 줄 전망: 텍스트 워터마킹은 ‘AI를 잡아내는 탐지기’ 라기보다, ‘출처를 기록하는 인프라’ 로 이해하는 편이 정확합니다. 규제가 강해질수록 모델 선택보다 ‘콘텐츠 출처 관리’가 기업의 숙제로 커질 것입니다.
정리 — 이 뉴스, 어떻게 받아들일까
요약하면 이렇습니다. 새 모델 성능 뉴스가 아니라 ‘AI 텍스트 출처 표기’라는 규제 인프라 뉴스입니다. 핵심은 세 가지입니다. ① API는 옵트인(기본 꺼짐), ② EU의 ChatGPT·Codex에는 자동 적용, ③ 검출기는 승인 기관만. AI 텍스트를 업무 문서나 제품에 붙여 쓰는 분들이라면, “이 텍스트가 나중에 어떻게 식별될 수 있는가” 를 미리 따져 두는 것이 안전합니다. 편집에 약한 워터마크의 특성상, 결국 자체 로그·정책·검증 파이프라인을 갖춘 팀이 규제 시대에 유리합니다.
앞으로도 OpenAI GPT 관련 굵직한 소식이 나오면 핵심만 추려 정리해 전해드리겠습니다.
출처
- OpenAI, “Our approach to EU text provenance rules” (2026년 10월 5일) — https://openai.com/index/eu-text-provenance/
- OpenAI 기술 보고서, “textGrain: Entropy-Calibrated Watermarking for Language Model Text” (2026년 10월 5일, cdn.openai.com)
- Unite.AI, “OpenAI Begins Phased Text Watermarking Under EU AI Act Rules” (2026년 10월 5일)
- DEV Community(techaiwire), “OpenAI textGrain watermarks ChatGPT text under EU AI Act” (2026년 10월 5일)
- CellCog, “OpenAI Text Watermark: ChatGPT EU Rollout and textGrain” (2026년 10월 5일)
- Daring Fireball, “OpenAI Announces Their Text Watermarking Plans” (2026년 10월 5일)
- 이미지: OpenAI 공식 기술 보고서 표지 / Wikimedia Commons (OpenAI 로고 퍼블릭 도메인, 유럽의회 청사 CC BY-SA 4.0 · Steven Lek)