
Google Gemini 최신 소식 — Gemini 3.8 Flash TTS·Flash-Lite TTS 공개, 목소리를 '디자인'하는 시대 (2026.9.24)
 Gemini 3.8 Flash TTS 공식 이미지 — 구글이 “가장 표현력이 뛰어난 오디오 생성 모델”이라고 소개한 신규 TTS 라인업입니다 (출처: blog.google Google 공식 블로그)
📌 한줄 요약: 요즘 저처럼 음성 더빙·오디오북·팟캐스트·ARS 안내방송을 AI로 만들려다 “목소리가 다 비슷하다”는 벽에 부딪히신 분들 많으시죠. 9월 22~23일(현지시간) Google이 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS를 정식 출시(GA)했습니다. 이번엔 단순히 “더 자연스러운 목소리”가 아니라, 자연어 프롬프트로 목소리를 처음부터 디자인하고, 30초 샘플로 음성을 복제하며, 2,000개 이상 라이브러리 + 100개 이상 언어를 다루는 “보이스 스튜디오”에 가깝습니다. Google AI Studio·Gemini API·Gemini Notebook·Google Vids에 바로 들어갔고, 가격도 분당 1센트 안팎으로 공개됐습니다.
이 글을 읽으면 알 수 있는 것
- 무슨 일이 있었나 — Gemini 3.8 Flash TTS / Flash-Lite TTS 출시 핵심 요약
- 상세 분석 — 보이스 디자인·복제·신규 Voices API가 실제로 무엇을 하는지
- 영향 — 일반 사용자와 개발자 입장에서 뭐가 달라지는지
- 솔직한 장단점 — 지금 써도 되는 기능과 아직 조심할 부분
- 전망과 활용 팁 — 어떤 작업부터 붙이면 체감이 큰지
1. 무슨 일이 있었나 — 이슈 요약
Google은 Gemini API 릴리스 노트(9월 22일)와 공식 블로그 포스트(9월 23일)를 통해 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS를 일반 제공(GA)으로 공개했습니다. Gemini Audio 모델군(3.5 Live Translate, 3.5 Transcribe, 3.8 Live, 3.8 Live Extended Thinking)에 이어 음성 “출력” 쪽을 담당하는 신규 모델입니다.
핵심 숫자만 먼저 정리하면 이렇습니다.
| 항목 | 내용 |
|---|---|
| 출시 시점 | 2026년 9월 22일 API GA / 9월 23일 공식 발표 |
| 모델 ID | gemini-3.8-flash-tts, gemini-3.8-flash-lite-tts |
| 신규 엔드포인트 | Voices API (/v1beta/voices) 신설 |
| 제공 채널 | Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook, Google Vids |
| 음성 라이브러리 | 기본 30개 → 2,000개 이상(지역 방언 포함) |
| 언어 | 100개 이상(멕시코 스페인어, 퀘벡 프랑스어, 스코틀랜드 영어 등 지역 변종 포함) |
| 음성 복제 | 30초 샘플로 복제 + 동의 검증(Consent Verification) |
| 안전장치 | 전 출력물 SynthID 워터마크 + C2PA 자격증명 |
| 가격(12/31까지) | 텍스트 입력 100만 토큰 $0.50, 오디오 출력 100만 토큰 $9(Flash) / $6(Flash-Lite) |
| 분당 환산 | 약 1.35센트(Flash) / 0.9센트(Flash-Lite) — 2027년 1월 1일부로 2배 인상 예고 |
| 벤치마크 | Hume AI Voice Design Benchmark 1위(71.4), Overall Quality Index 1·2위 |
솔직히 저는 3.7 Flash → 3.8 Flash → 3.8 Live로 이어지는 최근 흐름을 보면서 “이제 텍스트·추론은 충분히 좋아졌고, 남은 건 음성 출력의 품질이겠구나”라고 생각하고 있었습니다. 그 예상이 정확히 맞아떨어진 셈입니다. 이번 발표의 본질은 “목소리를 고르는 것”에서 “목소리를 만드는 것”으로의 전환입니다.
2. 상세 분석 — 무엇이 달라졌나
2-1. 보이스 디자인 — 프롬프트로 목소리를 새로 만든다
가장 눈에 띄는 건 생성형 보이스 디자인(Generative Voice Design)입니다. 미리 녹음된 목소리 중에서 고르는 게 아니라, 역할·억양·음색을 자연어로 묘사하면 그 목소리를 새로 만들어냅니다. 공식 예시로 “불을 뿜는 드래곤” 캐릭터, 멜버른 억양의 고에너지 DJ, 아주 얇고 단조로운 로봇 목소리, 일본어 드래곤 연기 등이 소개됐습니다.
핵심은 100개 이상 언어·방언에 걸쳐 이 디자인이 가능하다는 점입니다. 캐릭터 더빙이나 게임 성우, 브랜드 앰버서더 보이스처럼 “우리만의 목소리”가 필요한 작업에서 의미가 큽니다.
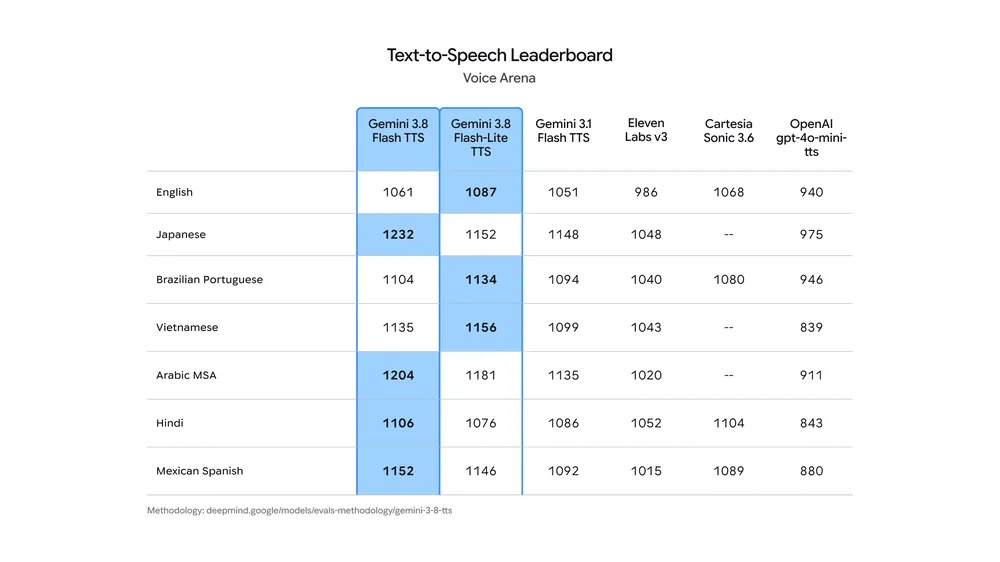 Gemini 3.8 Flash TTS 평가 결과 — Hume AI Voice Design Benchmark 전체 1위(71.4), 악센트 모델링 1위(60.8)를 기록했습니다 (출처: blog.google Google 공식 블로그)
2-2. 음성 복제 — 30초 샘플 + 동의 검증
보이스 복제(Voice Replication)는 30초 분량의 오디오 샘플만으로 일관된 성우 프로필을 재현합니다. 여기서 중요한 건 동의 검증 절차입니다. 음성 소유자의 구두 동의 녹음을 함께 제출해야 목소리를 만들 수 있게 설계됐습니다. 무단 성우 도용 리스크를 구조적으로 줄이려는 접근입니다.
2-3. 신규 Voices API — 목소리를 자산으로 관리
이번에 Voices 엔드포인트(/v1beta/voices)가 새로 생겼습니다. 디자인한 커스텀 보이스를 저장·관리하고, 프로젝트가 길어져도 음색 드리프트를 최소화하도록 재사용할 수 있습니다. 즉 목소리가 일회성 결과물이 아니라 재사용 가능한 자산이 됩니다. 조만간 보이스 리믹싱(라이브러리 음성의 음색·피치·속도·억양을 프롬프트로 미세 조정)도 예고됐습니다.
2-4. 연출 제어 — 대본 한 줄 한 줄을 “연기”시킨다
두 모델 모두 대본의 각 대사를 개별 지시할 수 있습니다. 웃음·한숨·헐떡임 같은 비언어 큐(<laughs>, <sigh>, <gasp>)와 맞장구(|mhm|, |yeah|)를 스크립트에 넣어 정교한 코미디 타이밍·리액션 비트를 만들 수 있습니다.
여기에 장시간 생성(Long-form)과 2인 대화 씬 스테이징(Native two-speaker scene staging)이 더해집니다. 한 대본 안에서 두 화자를 자연스럽게 주고받게 하면서 목소리를 분리해 유지합니다. 오디오북·팟캐스트·드라마틱 스토리텔링이 정확히 겨냥한 영역입니다.
| 구분 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 강점 | 최고 수준 음성 충실도, 연기 뉘앙스, 방언 커버리지 | 고처리량·저지연·비용 효율 |
| 용도 | 캐릭터 디자인, 오디오북, 게임, 몰입형 미디어 | 대량 더빙, 음성 에이전트, 스케일 오디오 |
| 오디오 출력 단가 | $9 / 100만 토큰 | $6 / 100만 토큰 |
3. 영향 — 사용자와 개발자에게 무엇이 달라지나
3-1. 일반 사용자
Gemini Notebook과 Google Vids에 이미 들어갔다는 점이 실질적입니다. 노트북 콘텐츠를 음성으로 듣거나, 영상에 AI 더빙을 입히는 작업이 별도 툴 없이 구글 생태계 안에서 끝납니다. 다국어 더빙의 진입장벽이 눈에 띄게 낮아집니다.
3-2. 개발자
- 신규 Voices API로 커스텀 보이스를 저장·버전 관리하는 파이프라인을 만들 수 있습니다.
- Flash-Lite가 분당 0.9센트로 들어오면서, 콜봇·음성 에이전트·ARS처럼 호출량이 많은 서비스의 단가 계산이 현실적으로 바뀝니다.
- 다만 2027년 1월 1일부로 가격이 2배로 오른다는 예고가 있습니다. 지금 단가로 대량 트래픽을 설계한다면 연말 전에 요금 시나리오를 다시 짜두는 게 안전합니다.
업무 자동화 관점에서 보면, 기존에 “음성 더빙 외주”로 나가던 작업이 API 호출 한 줄로 대체되는 구간이 늘어납니다. 저처럼 자동화 파이프라인을 운영하는 입장에서는 콘텐츠 제작 공정에서 사람이 개입하는 지점이 하나 더 줄어드는 셈입니다.
4. 솔직한 장단점
장점
- 프롬프트만으로 무한 보이스 생성 — 캐릭터·브랜드 목소리 확보가 쉬워졌습니다.
- 동의 검증 + SynthID + C2PA 3중 안전장치로 무단 음성 도용·딥페이크 리스크를 구조적으로 낮췄습니다.
- 2인 대화·장시간 생성이 한 번의 호출로 가능해 오디오북·팟캐스트 제작이 단순해집니다.
- Flash-Lite의 0.9센트/분 단가는 음성 에이전트 대량 운영에 현실적인 수준입니다.
단점·주의점
- 가격 인상 예고(2027.1.1, 2배) — 지금의 저렴함을 전제로 한 비즈니스 모델은 재검토가 필요합니다.
- 음성 복제는 동의 절차가 필수라, 편하지만 즉시성은 떨어집니다.
- 보이스 리믹싱은 아직 “coming soon” — 발표 시점 기준으로는 미제공 기능입니다.
- 지역·언어별 품질 편차는 직접 테스트해봐야 합니다. 벤치마크가 좋다고 해서 내 도메인 대본에서도 좋다는 보장은 없습니다.
5. 전망과 활용 팁
Gemini Audio 라인이 인식(Transcribe) → 번역(Live Translate) → 실시간 대화(Live) → 창작형 음성 생성(TTS)으로 빠르게 채워지고 있습니다. 다음 단계는 예고된 보이스 리믹싱과 더 정교한 감정·연기 제어가 될 가능성이 큽니다. 특히 “목소리를 자산으로 저장하는 Voices API”는 장기적으로 캐릭터 IP·브랜드 보이스 시장을 겨냥한 포석으로 보입니다.
활용 팁 (가성비 좋은 순서대로):
- 대량·반복 작업부터 Flash-Lite — 더빙, 안내방송, 음성 에이전트 응답처럼 물량이 많은 곳에 먼저 붙이면 단가 효과가 가장 큽니다.
- 캐릭터·브랜드 음성은 Flash로 — 연기 뉘앙스가 필요한 곳은 Flash가 맞습니다.
- 연말 전 가격 재계산 — 2027년 2배 인상을 전제로 트래픽·예산을 미리 잡아두세요.
- 동의·워터마크 정책 확인 필수 — 성우·본인 음성을 쓴다면 동의 녹음 절차를 워크플로에 미리 넣어두는 게 안전합니다.
솔직히 “AI 목소리”는 그동안 어딘가 어색한 구간이 있었는데, 이번 모델은 연출 제어와 목소리 자산화라는 두 축을 동시에 건드렸다는 점에서 결이 다릅니다. 음성 콘텐츠를 만들어야 하는데 성우 섭외가 부담이었던 분, 다국어 더빙이 필요했던 분이라면 먼저 Flash-Lite로 가볍게 테스트해보고, 만족스러우면 Flash로 올리는 순서를 추천드립니다. 가성비 좋은 음성 생성 툴을 찾는 분께 특히 권하고 싶습니다.
참고: 이 글은 Google 공식 블로그(blog.google)와 Gemini API 릴리스 노트, 그리고 공개된 가격·벤치마크 정보를 바탕으로 정리했습니다. 실제 품질과 비용은 본인 콘텐츠로 직접 테스트해 확인하시길 권합니다.
이미지 출처: Google 공식 블로그(blog.google) 및 Google Gemini Audio 공식 자료.