
OpenAI 자체 AI 칩 'Jalapeño(할라페뇨)' 추천 분석 — 엔비디아 GB300 제친 첫 벤치마크, 같은 날 사상 최대 실적… AI 반도체 전쟁의 48시간 (2026.8.27)
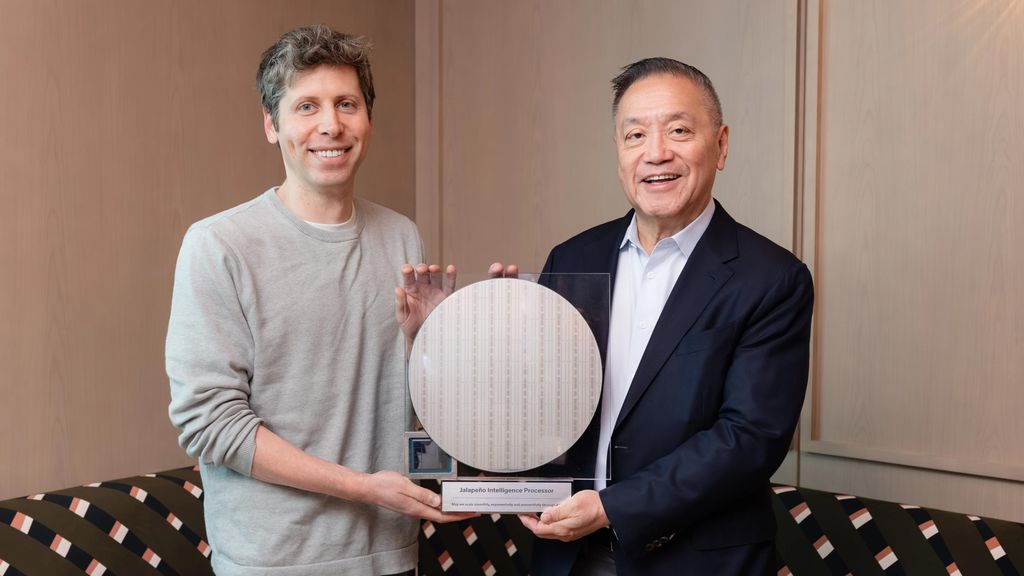 OpenAI가 공개한 자체 추론 칩 ‘Jalapeño’ (출처: OpenAI, Tom’s Hardware 2026-08-25 기사 인용, 2026-08-27 확인)
이 글을 읽으면 알 수 있는 것
- OpenAI 자체 AI 칩 ‘Jalapeño’란? — 브로드컴과 공동 설계한 LLM 추론 전용 ASIC, 설계 착수부터 테이프아웃까지 약 16개월
- 첫 벤치마크 결과 — GB200/GB300 대비 kW당 처리량 1.5~1.9배, 종단 간 지연시간 1.7~3.6배 단축 (SemiAnalysis InferenceX 공개 벤치마크)
- 솔직한 단점도 — 아직 엔지니어링 샘플(A0) 단계, Vera Rubin과는 정면 비교 안 됨, 학습(트레이닝)은 불가, 수치 일부는 ‘오픈AI 제공’
- 엔비디아 사상 최대 실적 (8/26) — 분기 매출 962억 달러(+106% YoY), 데이터센터 890억 달러(+117%), 3분기 가이던스 1,080억 달러
- 함께 공개된 신제품 — 첫 AI 에이전트용 CPU ‘Vera’, 추론 가속기 ‘Groq 3 LPX’
- 결론 — AI 반도체는 ‘1강 독주’에서 ‘2강(그리고 다강) 경쟁’으로, 전성비(성능/전력)가 새로운 기준이 되는 중
1. 요즘 저처럼 “AI 구독비·GPU 비용이 왜 이렇게 비싸지?” 고민하시는 분들
요즘 저처럼 ChatGPT·클로드·제미나이 구독료를 합치면 한 달에 몇만 원, GPU 렌탈이나 클라우드 API 비용까지 생각하면 지갑이 가벼워지시는 분들, 많으시죠.
솔직히 저는 AI를 하루도 안 쓰는 날이 없는데, 그때마다 드는 생각이 하나입니다. “이 토큰 하나하나가 결국 엔비디아 GPU 위에서 도는 거잖아? GPU 값이 내려가야 구독료도 내려갈 텐데…“ 그런데 지난 8월 25일(화)과 26일(수), 이틀 사이에 그 ‘상식’을 흔드는 일이 실제로 벌어졌습니다.
- 8/25(화) — 미국 ‘핫칩스(Hot Chips) 2026’ 컨퍼런스에서 OpenAI가 자체 설계한 첫 AI 추론 칩 ‘Jalapeño(할라페뇨)’의 벤치마크 결과를 공개했는데, 엔비디아 GB300(1,400W)보다 전력당 처리량이 최대 1.9배라는 충격적인 수치가 나왔습니다.
- 8/26(수) — 바로 다음 날, 엔비디아가 분기 매출 962억 달러(한화 약 128조 원)라는 사상 최대 실적을 발표하며 “우리가 여전히 왕이다”를 증명했습니다.
이 글은 그 48시간의 핫이슈를, 저처럼 “AI를 쓰는 사람” 관점에서 정리한 후기입니다. 칩을 직접 살 수는 없지만, 우리가 내는 구독료·API 비용이 어떤 방향으로 움직일지를 가늠하는 데는 이 이야기만큼 좋은 재료가 없더라고요.
 NVIDIA 공식 로고 (출처: nvidia.com 공식 브랜드 자산, 2026-08-27 확인)
2. 핫이슈 ① — OpenAI 자체 칩 ‘Jalapeño’, 대체 뭔가?
2-1. 한 줄 요약
Jalapeño는 OpenAI가 브로드컴(Broadcom)과 공동 설계한 ‘LLM 추론(inference) 전용 범용 ASIC’ 입니다. 이름은 매운 고추에서 따왔는데, 엔비디아 GPU에 ‘매운맛’을 보여주겠다는 뜻이 담겼다고 해석하는 분들이 많습니다(공식적으로는 그렇게 말하지 않지만요).
2-2. 개발 과정 — “9개월 만에 테이프아웃”
- 2024년 중반 설계 착수 → 초기 채용부터 제조 테이프아웃까지 약 16개월 (RTL→테이프아웃 사이클은 9개월)
- 지난 6월 첫 공개 이후, 8월 25일 Hot Chips 2026에서 초기 실리콘(A0 스테핑)으로 측정한 첫 벤치마크를 공개
- 엔비디아·AMD·구글 칩을 전부 테스트해봤다는 SemiAnalysis는 “우리가 테스트해본 모든 엔비디아·AMD·구글 칩을 이긴다“고 평가
2-3. 하드웨어 스펙 (핵심만)
| 항목 | Jalapeño | 비교 대상(GB300) |
|---|---|---|
| 패키지 | 연산 다이 + HBM4 6스택 | HBM3E 288GB |
| 메모리 | 216 GiB, 15.4 TB/s | 288GB, 8TB/s급 |
| 공정 | TSMC N3P(3nm급) 단일 레티클 | TSMC 4nm급 |
| TDP | 700W (실측 지속 전력 550W 이하) | 1,400W |
| 용도 | 추론 전용(학습 불가) | 학습+추론 겸용 |
포인트는 “메모리 대역폭을 더 많이 붙이는 게 아니라, 붙어 있는 대역폭을 최대한 끌어내는” 구조라는 점입니다. 또 TDP가 700W로 GB300(1,400W)의 절반인데 정격 전력당 메모리는 약 50% 더 많습니다. 전력 효율로 승부를 거는 설계라는 뜻이죠.
 NVIDIA가 실적 발표와 함께 공개한 첫 AI 에이전트용 CPU ‘Vera’ (출처: nvidianews.nvidia.com 공식 보도자료 이미지, 2026-08-27 확인)
3. 핫이슈 ② — 벤치마크 숫자를 솔직하게 까보자
3-1. 공개된 수치 (SemiAnalysis InferenceX, 공개 오픈모델 3종)
OpenAI가 테스트한 모델은 GPT-OSS 120B, DeepSeek R1 670B, Moonshot Kimi K2.5(1조 파라미터) 3종입니다. 결과는 이렇습니다.
- 전력당 처리량(kW당 토큰 수): GB200/GB300 대비 1.5배 ~ 1.9배
- 종단 간 지연시간: 1.7배 ~ 3.6배 단축
- 저지연 구간(가장 빨랐던 GB300 설정 기준): kW당 처리량 최대 8.6배 ~ 104.3배
- 단일 사용자(동시성 1) 기준: DeepSeek R1 초당 700토큰 이상, GPT-OSS·Kimi K2.5 초당 약 1,400토큰
“지연시간이 짧다”는 게 왜 중요하냐면, 채팅 AI가 ‘뚝뚝 끊기면서’ 답하는 체감 속도가 바로 이 지표로 결정되기 때문입니다. GPT-OSS 기준 kW당 처리량은 GB200 최고 처리량 지점의 약 2배, GB200 동시성 1 지점의 50배 이상이라는 수치도 나왔습니다.
3-2. 그런데… 솔직히 단점도 봐야죠
여기서부터가 중요합니다. 수치만 보면 ‘엔비디아 끝났네?’ 싶지만, 실제로는 조건이 붙어 있습니다.
| 항목 | 솔직한 평가 |
|---|---|
| 비교 대상 | GB200/GB300(현재 양산 중)과 비교. 차세대 Vera Rubin은 비교 대상에 없음 |
| 형평성 | 경쟁 칩들은 ‘다중 토큰 예측(MTP)’까지 쓴 결과인데, Jalapeño는 단일 토큰 예측(STP)만으로 이 수치를 냄 → 오히려 추가 여지가 크다는 해석도, “조건이 다르다”는 지적도 공존 |
| 검증 주체 | 벤치마크 수치는 OpenAI가 제공했고, SemiAnalysis가 연구소에서 실행을 직접 확인했지만 전체 제품군 검증은 아님 |
| 성숙도 | 엔지니어링 샘플(A0) 단계. B0 스테핑은 제조 중(전력당 성능 약 25% 개선 예정). 양산·대규모 배포는 2027년부터 점진 확대 |
| 학습 불가 | 트레이닝 워크로드는 여전히 엔비디아 천하. Jalapeño는 추론 전용 |
| 실전 워크로드 | 멀티턴·긴 문맥 에이전트 작업(AgentX) 결과는 아직 없음 |
또 하나 재미있는 사실 — 엔비디아도 8/17에 OpenAI의 오하이오 데이터센터 캠퍼스에 최대 1,050억 달러 규모 파이낸싱을 제공하기로 했습니다. OpenAI 하드웨어 담당 부사장 리처드 호는 “엔비디아는 정말 좋은 파트너이고, 우리는 계속 엔비디아를 많이 필요로 한다”고 말했죠. 싸우면서도 서로 필요한 관계, 이게 지금 AI 반도체 시장의 실제 모습입니다.
 OpenAI 공식 워드마크 로고 (출처: Wikimedia Commons ‘OpenAI Logo.svg’, 2026-08-27 확인)
4. 핫이슈 ③ — 엔비디아, 사상 최대 실적으로 맞불 (8/26)
Jalapeño 발표 하루 만에, 엔비디아가 2027 회계연도 2분기(6/26~7/26) 실적을 발표했습니다.
- 매출 962억 달러 — 전 분기 대비 +18%, 전년 동기 대비 +106% (사상 최대)
- 데이터센터 매출 890억 달러 — 전년 대비 +117% (전체의 92%)
- 총이익률 75.0% (GAAP·non-GAAP 동일)
- 3분기 가이던스 1,080억 달러 — 시장 예상치 상회
여기에 신제품 발표도 묶여 나왔습니다.
- NVIDIA Vera CPU — “AI 에이전트를 위해 처음 만들어진 CPU”라는 포지셔닝. SpaceXAI(일론 머스크의 AI 회사)가 대규모 도입 예정
- NVIDIA Groq 3 LPX — 인터랙티브 AI 추론 가속기 (Hot Chips 2026에서 아키텍처 공개)
- Vera Rubin 플랫폼 — MW당 성능이 GB200 NVL72 대비 5.4배라고 공식 발표 (고객 출하 시작)
- 아폴로·블랙스톤·KKR 등과 함께 AI 인프라 파이낸싱 5,000억 달러+ 조성 플랫폼 발표
즉, “OpenAI가 내 칩으로 도전장을 던졌지만, 나는 여전히 사상 최대 실적을 내고 있고, 차세대(Rubin)도 이미 나왔다”는 메시지인 셈입니다. 시장 시가총액이 약 5조 달러(한화 약 6,600조 원)에 달하는 기업답게, 실적 발표 후 주가도 급반등했다고 하네요.
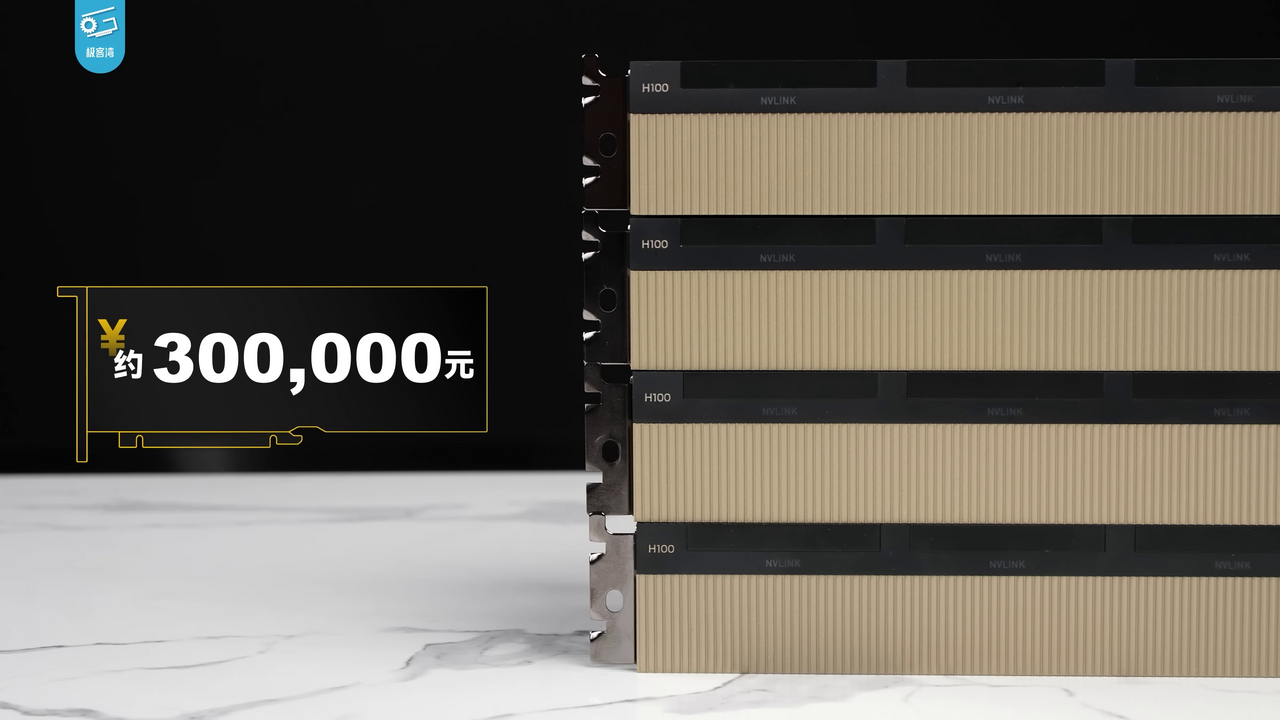 NVIDIA H100 GPU 실물 사진 (출처: Wikimedia Commons ‘NVIDIA H100’, 2026-08-27 확인)
5. 정리 — 장점 5, 단점 5 (솔직 버전)
장점 👍
- 전성비가 압도적 — kW당 처리량 GB300 대비 최대 1.9배, 저지연 구간에선 수십 배. 데이터센터가 ‘면적’보다 ‘전력’에 제약받는 현실에서 매우 큼
- HBM4 선점 — 216GB·15.4TB/s. 2027년까지 HBM 물량이 매진된 초호황기에 삼성·SK하이닉스 물량을 브로드컴 10GW 계약으로 확보
- 16개월 만의 개발 속도 — 1세대 칩이 이 정도 성능이면 2세대(수개월 내 테이프아웃 예정)·3세대가 기대됨
- 운영 유연성 — 프리필/디코드 분리 없이 동질적 장치 풀로 운영, 데이터 지역성 유지. 추측 디코딩을 얹으면 토큰당 비용 3~5배 추가 절감 가능
- 가격 구조 — 엔비디아보다 낮은 브로드컴 마진 구조. 같은 성능이면 우리가 내는 API·구독료가 내려갈 여지가 생김
단점 👎
- 아직 ‘종이 위의 용’ — 엔지니어링 샘플 단계. 실제 경쟁력은 2027년 양산·배포·신뢰성에서 확인됨
- Vera Rubin과는 정면 비교 불가 — Rubin도 HBM4 사용, MW당 성능 5.4배(GB200 대비) 주장. 토큰당 비용은 오히려 거의 동등
- 학습 불가 — 파운데이션 모델 학습은 여전히 엔비디아 독점
- 벤치마크 조건 논란 — 수치가 ‘OpenAI 제공’이고, STP vs MTP 조건 차이. 에이전트 실전(AgentX) 결과는 아직 없음
- HBM 공급 자체가 병목 — 삼성·SK하이닉스·마이크론 모두 2027년까지 매진. 칩이 아무리 좋아도 메모리가 없으면 못 만듦
6. 마무리 — “가성비 좋은 AI를 찾는 분”께 드리는 정리
솔직히 이번 48시간을 지켜보면서 든 생각은, “AI 구독료·API 비용이 내려가는 날이 생각보다 빨리 올 수 있겠다”는 것입니다.
- 단기(2026년 하반기) — 엔비디아의 압도적 공급 우위 + HBM 매진 → 구독료 인하 기대는 아직 이름. 다만 GB300·Rubin 출하가 늘면서 ‘용량당 단가’는 분명 내려가는 중
- 중기(2027년) — Jalapeño 양산 + 브로드컴 10GW + AMD·구글(TPU)까지 합류하면 AI 추론 단가가 확실히 내려갈 가능성이 큼. 그때쯤이면 지금의 GPT급 모델을 쓰는 비용이 지금의 절반 이하가 될 수도
- 우리가 지금 할 수 있는 것 — ① 연간 결제(연간 구독) 할인을 활용하거나, ② 가벼운 작업은 로컬 오픈모델(30B급)로 돌리고 무거운 작업만 API를 쓰는 하이브리드 전략, ③ AI 칩 관련 ETF·반도체 관련주를 눈여겨보는 것 정도
AI를 매일 쓰는 사람 입장에서, “엔비디아 독주”가 깨지는 순간이 곧 “내 구독료 인하”의 순간입니다. 이번 Jalapeño 발표와 엔비디아 사상 최대 실적은 그 전환점이 생각보다 가까이 왔다는 신호로 읽히네요.
저처럼 AI 비용이 부담되면서도 성능 좋은 AI를 계속 쓰고 싶은 분, AI 반도체 흐름이 궁금한 분께 이 글을 추천합니다. 다음 6시간 뒤에 또 새로운 핫이슈가 나오면 다시 정리해 오겠습니다!
참고 자료: OpenAI 공식 블로그 ‘Jalapeño’s first results’(2026-08-25), Tom’s Hardware(2026-08-25), SemiAnalysis InferenceX 벤치마크, NVIDIA 보도자료 ‘Q2 Fiscal 2027 Results’(2026-08-26), GeekNews(2026-08-26). 모든 이미지는 각 출처에서 인용했으며, 캡션에 출처를 표기했습니다.